GPT-6.2 Astra in sintesi
| Domanda |
Risposta breve |
| Cos'è GPT-6.2 Astra? |
Il modello GPT-6.2 di OpenAI con le massime capacità per programmazione complessa e lavoro professionale |
| Data di rilascio |
17 novembre 2026 |
| ID modello API |
gpt-6.2-astra |
| Finestra di contesto |
1,05 milioni di token |
| Input / output massimo |
922.000 / 128.000 token |
| Modalità |
Input di testo e immagini; output di testo |
| Prezzo API standard OpenAI |
8$ in input, 0,40$ in input memorizzato nella cache e 40$ in output per 1 milione di token |
| Prezzo GPT Proto |
6,40$ in input, 0,32$ in input memorizzato nella cache e 32$ in output per 1 milione di token — 20% di sconto |
| Ideale per |
Debug complesso, revisione del codice, migrazioni, analisi dei dati, documenti professionali, scienza, CAD e flussi di lavoro 3D |
| Migliore alternativa quotidiana |
GPT-6.2 Sol per programmazione di routine, scrittura e lavoro a costi inferiori |
La documentazione del modello OpenAI elenca il supporto per Risposte e Chat Completions, oltre a strumenti che includono ricerca web, ricerca file, interprete di codice, shell ospitata, utilizzo del computer, MCP e generazione di immagini. Il modello stesso restituisce testo. Fogli di calcolo, presentazioni, siti o risorse 3D completi dipendono dagli strumenti e dall'ambiente di esecuzione circostante.
Di cosa stanno discutendo i primi utenti?
La conversazione sul lancio non riguarda principalmente i punteggi dei benchmark. Riguarda il divario tra la capacità grezza e l'usabilità quotidiana.
1. Astra può essere eccellente nel revisionare e riparare sistemi esistenti
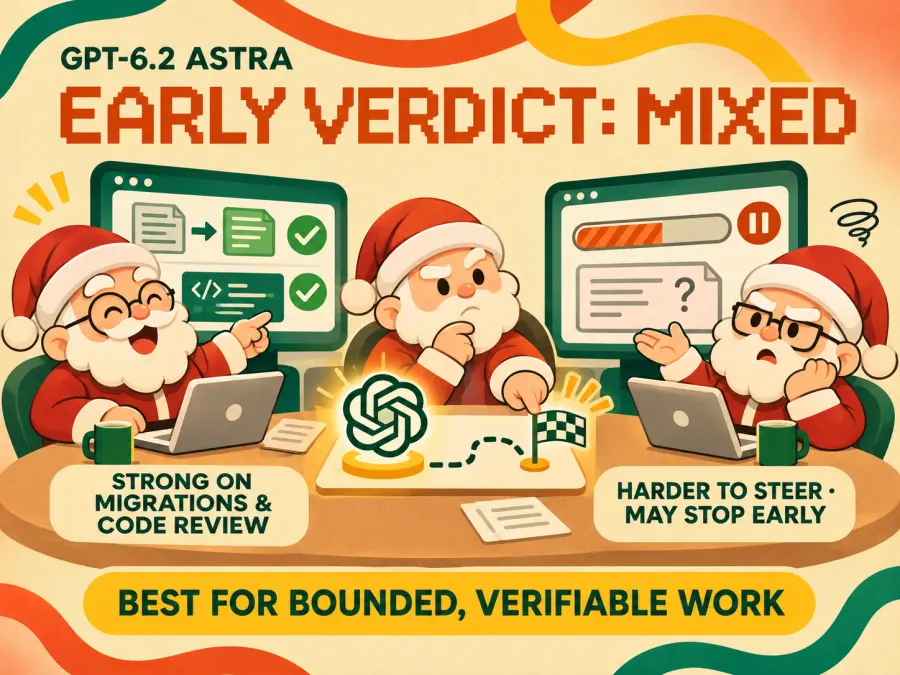
I primi test di Copilot di GitHub hanno rilevato che GPT-6.2 Astra ha rilevato molti più problemi reali di revisione del codice rispetto a GPT-6 Astra, utilizzando meno token. Questo è più rilevante per un team di produzione rispetto a un'altra demo di un'app una tantum: il lavoro prezioso consiste spesso nel trovare il difetto, preservare il comportamento esistente e dimostrare la patch con i test.
L'ingegnere Tibor Blaho ha descritto l'utilizzo di Astra nel lavoro quotidiano di infrastruttura e software, inclusi gestione dei server, backup, monitoraggio, ricerca, amministrazione, debug e revisione del codice. Il suo esempio più significativo è stato l'aggiornamento di un'applicazione legacy da milioni di righe e delle sue vecchie dipendenze a una versione linguistica attuale. Ha riportato un risultato utilizzabile localmente dopo circa tre ore e un test di clean-checkout superato dopo circa sei ore, pur notando che restava ancora del lavoro da fare.
Questo è un aneddoto, non un benchmark controllato. È comunque un esempio utile perché include una base di codice reale, il tempo trascorso e una fase di verifica. Indica anche un flusso di lavoro pratico: Blaho utilizza Astra e i modelli Claude per ricercare e revisionare il lavoro l'uno dell'altro invece di presumere che un singolo modello rilevi ogni difetto.
2. Le esecuzioni autonome prolungate possono essere frustranti
Anche i resoconti negativi sono concreti. La prima recensione di Dan Shipper ha affermato che Astra si interrompeva spesso troppo presto durante le build di programmazione end-to-end e poteva essere così concisa da rendere difficile seguire la sua scrittura. Ethan Mollick l'ha definita irregolare e più difficile da gestire: ha creato con successo un'ambiziosa esperienza di ascensore spaziale in Blender e Unity, eppure non si è ritrovato a usarla come modello quotidiano.
Il resoconto dettagliato dello sviluppatore Theo è altrettanto diviso. Ha elogiato Astra come revisore di codice, ha affermato che ha trovato soluzioni innovative e le ha attribuito un design di reverse-proxy che potrebbe far risparmiare alla sua azienda 25.000 dollari al mese. Ha anche segnalato esecuzioni lunghe bloccate su domande a cui non riusciva a rispondere, loop che non facevano progressi e riassunti più difficili da comprendere rispetto alle modifiche al codice.
Questi resoconti non dimostrano che ogni esecuzione di Astra fallirà. Identificano lo stesso rischio da diverse angolazioni: il modello potrebbe essere abbastanza capace da svolgere il lavoro, ma difficile da supervisionare quando l'obiettivo è a finale aperto.
3. L'output conciso è efficienza o mancanza di contesto
La stessa guida al prompting di GPT-6.2 di OpenAI afferma che Astra è più concisa e diretta per impostazione predefinita. Per una risposta di supporto, una nota di revisione del codice o un breve riassunto esecutivo, ciò può essere utile. Per una spiegazione complessa, può sembrare che il modello abbia saltato il ragionamento necessario al lettore.
Questo spiega perché le prime reazioni sono contrastanti. Le persone che testano un deliverable dall'ambito ristretto potrebbero vedere meno riempitivi e meno token. Le persone che usano Astra come collaboratore in un lungo progetto potrebbero vedere risposte brusche, decisioni inspiegabili o passaggi di consegne prematuri.
4. La vera domanda è la natura del compito, non se Astra sia “intelligente”
Le prove finora suggeriscono una semplice linea di demarcazione:
| Natura del compito |
Idoneità iniziale per Astra |
| Obiettivo chiaro, strumenti, test e traguardo |
Candidato ideale |
| Revisione ad alto valore dove i difetti mancati sono costosi |
Candidato ideale |
| Lavoro su dati o documenti da più fonti con un output verificabile |
Candidato ideale |
| Email di routine, note di riunione o piccole modifiche al codice |
Di solito usa prima Sol |
| Ricerca a finale aperto che richiede giudizio su ciò che conta |
Confronta con Fable 5.2 e mantieni la revisione umana |
| Build autonoma di ore con decisioni ambigue |
Testa attentamente prima di affidartici |
GPT-6.2 Astra è adatto al lavoro quotidiano?
Sì, ma la maggior parte del lavoro quotidiano non ne ha bisogno. Per appunti di riunioni, email di routine, ricerche brevi, piccole modifiche al codice o una prima bozza, GPT-6.2 Sol è il punto di partenza più naturale. È il modello che OpenAI posiziona per il lavoro quotidiano e le sue tariffe per token sono inferiori del 75% rispetto a quelle di Astra. GPT Proto applica lo stesso sconto del 20% a entrambi i modelli, quindi tale divario di prezzo rimane invariato.
Astra diventa utile quando una categoria di lavoro ordinaria si trasforma in un compito difficile e ad alto valore. “Revisiona questa pull request” potrebbe essere adatto a Sol; “traccia questo errore intermittente su tre servizi, risolvilo ed esegui i flussi di lavoro interessati” è un lavoro su misura per Astra. “Riassumi questo CSV” è routine; “trova i problemi di qualità dei dati, spiega le trappole statistiche e crea una cartella di lavoro decisionale modificabile” offre ad Astra più spazio per giustificare il suo costo.
Gli usi pratici quotidiani segnalati finora includono il debug, le operazioni sui server, il monitoraggio, i backup, la revisione del codice, la ricerca multi-fonte e l'amministrazione d'ufficio. Il filo conduttore non è la professione, ma il fatto che il lavoro abbia una complessità sufficiente a beneficiare di un ragionamento più profondo e una struttura sufficiente a verificare il risultato.
Per cosa è adatto GPT-6.2 Astra?
Revisione del codice, analisi delle cause profonde e modernizzazione di sistemi legacy
Questo è il caso d'uso pratico più chiaro. Fornisci ad Astra il flusso di lavoro non funzionante, i log pertinenti, il repository e i comandi di test. Chiedigli di tracciare il guasto tra i servizi, implementare la correzione sicura più mirata ed eseguire i test interessati. Ciò corrisponde al flusso di lavoro Astra raccomandato da OpenAI e ai rapporti positivi di GitHub e dei primi ingegneri.
Gli aggiornamenti di sistemi legacy potrebbero essere particolarmente adatti perché il compito è difficile ma verificabile. Il modello può ispezionare vecchie dipendenze, aggiornare il codice a fasi e rieseguire ripetutamente una build pulita. L'essere umano deve comunque definire i requisiti di compatibilità e rivedere la migrazione. “Tutti i test superati” è una prova valida solo se la suite di test copre il comportamento che conta.
Per la normale revisione di una pull request o una piccola revisione, GPT-6.2 Sol potrebbe essere sufficiente. OpenAI raccomanda esplicitamente Sol per la programmazione quotidiana e costa un quarto delle tariffe standard di input e output di Astra.
Analisi dei dati, dashboard e cartelle di lavoro modificabili
Il valore di Astra qui non è semplicemente scrivere una query SQL. Può ispezionare i dati, notare problemi di qualità, dichiarare ipotesi, eseguire analisi e trasformare i risultati in una cartella di lavoro, un grafico o una dashboard che un'altra persona può revisionare.
Un test di analisi dati Plotly indipendente fornisce un utile esempio di compito reale. Astra ha superato 41 domande su 43, ha rilevato tutti i problemi di qualità dei dati inseriti, ha evitato tutte e cinque le trappole statistiche e ha completato l'esecuzione per 4,11 $. La sua domanda mediana ha richiesto 12,4 secondi, contro i 26,9 secondi di GPT-6 Astra. Il compromesso è importante: ha mancato due schemi nascosti e GPT-6.1 Sol ha ottenuto un punteggio perfetto in quel test per 2,61 $. Astra è stato veloce e capace, ma non automaticamente l'opzione più economica o più accurata.
L'esempio di valutazione Alderfen di OpenAI mostra il lato documentale della stessa capacità. Astra ha creato una cartella di lavoro DCF modificabile che ha previsto i ricavi fino al 2031, riconciliato tre rendiconti finanziari, calcolato il valore per azione e posizionato i driver chiave accanto alla tabella di sensibilità. Trattalo come una demo del fornitore, non come una prova indipendente. È comunque un modello utile per un test che puoi riprodurre con il tuo foglio di calcolo.
Finanza, contabilità, lavoro legale e documenti professionali
GPT-6.2 Astra è stato addestrato per seguire le convenzioni professionali in presentazioni, fogli di calcolo, promemoria e documenti. OpenAI riporta miglioramenti nei flussi di lavoro di finanza, contabilità, consulenza, vendite e ambito legale. I risultati dei clienti sulla pagina di lancio includono un minor numero di cicli di revisione per app, dashboard e presentazioni, oltre a tempi di completamento più brevi per il lavoro contabile a lungo termine. Si tratta di risultati selezionati dal fornitore, quindi dovrebbero essere letti come casi d'uso promettenti piuttosto che come risultati garantiti.
Le applicazioni migliori sono i deliverable verificabili:
Un modello finanziario le cui formule si riconciliano e rispondono correttamente al variare delle ipotesi.
Un promemoria legale le cui affermazioni possono essere ricondotte alle autorità e ai documenti di origine forniti.
Una presentazione che segue un modello esistente e trasforma ogni titolo in una conclusione supportata.
Un tracker di conformità che associa ogni requisito a prove, un responsabile e uno stato.
Le prove indipendenti sono meno lusinghiere per quanto riguarda il lavoro a risposta aperta. Nella valutazione realistica dell'ambiente di lavoro di Epoch AI, nessun modello testato ha soddisfatto lo standard dei dipendenti di Epoch in nessuna attività. GPT-6.2 Astra ha ottenuto una media del 65%, 17 punti in meno rispetto a Claude Fable 5.2. Epoch ha rilevato che Astra è migliorato rispetto a GPT-6 Astra nella scrittura concisa, nella progettazione grafica e nella ricerca sui data center, ma potrebbe essere troppo cauto e omettere conclusioni supportate dalle prove disponibili.
Questa apparente contraddizione è il punto focale. Astra può essere molto forte quando la rubrica e l'output sono espliciti. Quando il lavoro richiede di decidere cosa è importante, fare ipotesi calibrate e iterare su un piano di ricerca incerto, la scelta del modello e la supervisione umana contano di più.
Analisi scientifica e ricerca tecnica
OpenAI posiziona la scienza come un caso d'uso di punta per Astra e riporta risultati leader nei flussi di lavoro scientifici basati su terminale. Un segnale separato proveniente dai primi utenti arriva dal ricercatore biomedico Derya Unutmaz, che ha preferito Astra per la scienza e la programmazione a lungo termine, pur continuando a preferire Opus 5.5 per il gusto estetico e l'intelligenza emotiva. Ha anche descritto la sua esperienza di ricerca biomedica con Astra come solida.
Ciò non significa che Astra possa produrre autonomamente ricerche pronte per la pubblicazione. La valutazione di Epoch ha rilevato che i modelli di frontiera riutilizzano ancora idee esistenti, si affidano troppo ai primi tentativi e faticano a identificare i risultati più importanti. Usa Astra per cercare, analizzare il codice, confrontare fonti, testare un'ipotesi dichiarata o sfidare una bozza. Non trattare una narrazione di ricerca sicura come una validazione.
CAD, simulazione, progettazione 3D e prototipi visivi
Qui gli esempi di lancio sono più interessanti dei giochi. OpenAI ha mostrato Astra mentre modella componenti di veicoli, scrive un risolutore Python per la dinamica del telaio, anima il risultato in Blender e crea una guida all'assemblaggio e un catalogo di parti per un buggy radiocomandato. Questi esempi combinano ragionamento visivo, codice, uso del computer e documentazione in un unico flusso di lavoro.
Questa combinazione può aiutare nell'esplorazione ingegneristica iniziale: trasformare immagini di riferimento e manuali in un modello modificabile, testare una revisione in simulazione e produrre una spiegazione visiva per un revisore. Un design fisico necessita ancora di una validazione ingegneristica. Un'animazione plausibile non è la prova che carichi, tolleranze, materiali o requisiti di sicurezza siano corretti.
GPT-6.2 Astra può creare giochi?
Sì. Meridian Sound Racing è una demo giocabile nel browser e il progetto dell'ascensore spaziale di Ethan Mollick ha combinato Blender, Unity, un'esperienza nel browser e una fisica simulata a gravità zero.
Tuttavia, "può creare un gioco" non è la sintesi migliore per Astra. Questi progetti dimostrano che il modello è in grado di coordinare codice, risorse 3D, strumenti e interazioni all'interno di una build complessa. Le stesse capacità sono utili per simulazioni, esperienze di formazione, gemelli digitali, configuratori di prodotto e storie interattive basate sui dati.
Anche la coerenza creativa richiede test. I primi utenti hanno segnalato forti istinti visivi predefiniti, ma schemi di design ripetitivi e un controllo più debole sullo stile. Fornisci ad Astra un riferimento visivo, tipografia, pubblico di destinazione, regole di interazione ed espliciti obiettivi da non perseguire. Quindi giudica la seconda revisione, non solo il primo screenshot.
Come ottenere risultati migliori da GPT-6.2 Astra
I feedback della community suggeriscono che Astra necessiti di un brief operativo più esplicito rispetto a un normale prompt di chat. La guida di OpenAI avverte inoltre che il modello potrebbe proporre un passaggio successivo e attendere quando l'intento non è chiaro.
Utilizza una struttura di prompt come questa:
Obiettivo:
Completa [deliverable specifico].

Completato quando:

1. [Verifica di accettazione]

2. [Test o prova]

3. [Formato di output richiesto]

Autonomia:
Fai ipotesi ragionevoli e reversibili e continua senza attendere.
Chiedi solo se una decisione cambierebbe materialmente il risultato o causerebbe un'azione irreversibile.

Vincoli:

- Preserva [comportamento o stile esistente].

- Non modificare [area fuori ambito].

- Usa [strumenti, file, fonti o convenzioni].

Verifica:
Esegui [test o controlli]. Segnala esplicitamente qualsiasi file mancante, strumento non riuscito, ipotesi non supportata o passaggio incompleto.

Consegna finale:
Riassumi cosa è cambiato, cosa è stato verificato, i rischi rimanenti e l'utilizzo/costo totale.
Per il lavoro API a più turni, mantieni invariato il prefisso del prompt precedente e aggiungi le nuove istruzioni. OpenAI afferma che questo preserva il ragionamento e migliora il riutilizzo della cache dei prompt. Per il lavoro front-end o visivo, fornisci un riferimento reale e specifica la tipografia e le immagini desiderate. "Rendilo moderno" non è un sistema di design.
Quanto costa GPT-6.2 Astra per attività?
Queste tariffe sono espresse in USD per milione di token per richieste fino a 272.000 token di input. Le righe GPT Proto applicano lo sconto attuale del 20% alle tariffe standard di OpenAI.
Per una richiesta con 20.000 token di input non memorizzati nella cache e 5.000 token di output fatturati, il costo standard dei token sarebbe $0.36 su GPT-6.2 Astra, $0.45 su GPT-6 Astra e $0.09 su GPT-6.2 Sol. Con le tariffe attuali di GPT Proto, lo stesso numero di token costa $0.288 su Astra o $0.072 su Sol. Un'attività di agente reale può effettuare chiamate ripetute al modello, riutilizzare il contesto memorizzato nella cache, riprovare strumenti non riusciti o produrre un risultato molto più lungo.
Con oltre 272.000 token di input in una singola richiesta, le tariffe di input e cache di Astra raddoppiano e i costi di output sono 1,5 volte la tariffa per contesto breve per l'intera richiesta. La finestra di contesto da 1,05M è utile, ma riempirla con leggerezza può generare un conto salato. Misura il costo per attività completata, non solo il prezzo per milione di token.
L'esecuzione di Plotly fornisce un esempio concreto: 43 domande di analisi costano $4.11 su GPT-6.2 Astra, rispetto ai $19.97 su GPT-6 Astra. Eppure GPT-6.2 Sol è costato $1.22 e ha completato solo una domanda in meno. L'aggiornamento di Astra è reale; il modello più economico potrebbe comunque avere un'economia migliore per il traffico di produzione di routine.
Entrambi i percorsi scontati sono ora attivi. Controlla la pagina del modello GPT-6.2 Astra o la pagina del modello GPT-6.2 Sol per l'ID modello e il formato di richiesta correnti prima di inviare traffico di produzione. La collezione di modelli OpenAI elenca il resto dei modelli OpenAI disponibili.
GPT-6.2 Astra è migliore di Claude Fable 5.2?
Non per ogni tipo di lavoro.
OpenAI riferisce che Astra ha più che raddoppiato il tasso di superamento rigoroso di Fable 5.2 in un benchmark per agenti legali a circa un sesto del costo. In Cognition’s FrontierCode 2.0, tuttavia, Fable 5.2 ha ottenuto un punteggio più alto nelle modifiche a codebase esistenti. Anche la valutazione sul posto di lavoro a risposta aperta di Epoch ha favorito Fable 5.2 di 17 punti.
| Scegli GPT-6.2 Astra quando… |
Scegli Claude Fable 5.2 quando… |
| Revisione del codice, debug, utilizzo di strumenti o un deliverable tecnico verificabile sono fondamentali |
Il compito è a risposta aperta e richiede un forte giudizio su ciò che conta |
| Hai bisogno di flussi di lavoro CAD, simulazione, 3D o utilizzo del computer |
Lo stile di collaborazione e le spiegazioni leggibili in formato lungo contano di più |
| Il costo delle attività ripetute e l'efficienza della cache sono importanti |
I tuoi test rappresentativi mostrano meno interventi o un completamento migliore |
| Vuoi un secondo modello per rivedere il lavoro di un altro agente |
Vuoi un secondo modello per sfidare le ipotesi e le patch di Astra |
La risposta più pratica potrebbe essere usarli entrambi. Il flusso di lavoro di cross-review iniziale descritto da Tibor Blaho è più credibile che dichiarare un vincitore universale: lascia che un modello implementi o faccia ricerca, poi fai in modo che l'altro cerchi difetti mancati e ipotesi non supportate.
Per un confronto creativo, riutilizza il brief interattivo sull'acquerello dal nostro test di Claude Fable 5.2. Dai a entrambi i modelli lo stesso progetto esistente e chiedi un nuovo controllo senza rompere quelli attuali. Confronta la correttezza al primo tentativo, il numero di revisioni, la qualità della spiegazione, i token totali e il costo dell'attività completata. Puoi trovare l'accesso a Fable sulla pagina API di Claude Fable 5.2.
Dove puoi utilizzare GPT-6.2 Astra?
ChatGPT Work: GPT-6.2 Astra è disponibile in Work anziché nella normale chat di ChatGPT. L'accesso dipende dal piano, dalle impostazioni dell'area di lavoro e dallo stato del rollout.
Codex: Sì. Scegli Astra nell'app Codex o usa /model nella CLI. È l'opzione consigliata da OpenAI per tracciare bug complessi tra i servizi e completare la correzione e i test.
Claude Code: Non esiste un'opzione nativa per GPT-6.2 Astra. La documentazione del gateway LLM di Anthropic afferma che l'instradamento di Claude Code verso modelli non Claude tramite un gateway non è supportato.
OpenAI API: Usa l'ID modello ufficiale gpt-6.2-astra. OpenAI consiglia l'API Responses per i flussi di lavoro che richiedono l'uso di strumenti.
GPT Proto: Sia GPT-6.2 Astra che GPT-6.2 Sol sono attivi con tariffe inferiori del 20% rispetto ai prezzi standard dei token API di OpenAI. Scegli Astra per ragionamenti complessi e risultati professionali verificabili; scegli Sol per la programmazione di routine, la scrittura e carichi di lavoro a volume più elevato. La cronologia del rollout iniziale di GPT-6.2 Astra documenta gli avvistamenti pre-lancio in Codex.
La seguente richiesta utilizza l'ID del modello Astra attivo. Puoi copiare lo snippet di integrazione più recente direttamente dalla sua pagina modello.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  --header "Authorization: Bearer ${GPTPROTO_API_KEY}" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.2-astra",
    "messages": [
      {
        "role": "user",
        "content": "We sold 12 units at $25 each. Each unit cost $10. Return revenue and gross profit in USD as JSON using the keys revenue and gross_profit."
      }
    ]
  }'
Il ricavo dovrebbe essere di 300 $ e l'utile lordo di 180 $. Per un'esecuzione di routine più economica, passa all'ID modello esatto mostrato nella pagina di GPT-6.2 Sol. Puoi anche consultare la collezione di modelli OpenAI per altri modelli disponibili.
Considerazioni finali
Il vantaggio più convincente di GPT-6.2 Astra non è che può costruire un gioco. È la capacità di combinare ragionamento, codice, strumenti, file e utilizzo del computer su lavori che hanno un traguardo misurabile: un bug corretto e testato, una migrazione che viene compilata correttamente, una cartella di lavoro che riconcilia i dati o un'analisi che espone le proprie ipotesi.
La limitazione è altrettanto pratica. I primi utenti descrivono ripetutamente un modello che può essere brillante nel compito e tuttavia difficile da dirigere o comprendere a lungo termine. Usa Sol per il lavoro di routine. Usa Astra quando il lavoro è abbastanza difficile da giustificarlo, definisci "fatto" con precisione, verifica il risultato e confrontalo con Fable 5.2 sui compiti in cui il giudizio di ricerca e lo stile di collaborazione contano.