GPT-6.2 Astra in vogelvlucht
| Vraag |
Kort antwoord |
| Wat is GPT-6.2 Astra? |
OpenAI's meest capabele GPT-6.2-model voor complexe codering en professioneel werk |
| Releasedatum |
17 november 2026 |
| API-model-ID |
gpt-6.2-astra |
| Contextvenster |
1,05 miljoen tokens |
| Maximale input / output |
922.000 / 128.000 tokens |
| Modaliteiten |
Tekst- en afbeeldingsinput; tekstoutput |
| Standaard OpenAI API-prijs |
$8 input, $0,40 gecachte input en $40 output per 1 miljoen tokens |
| GPT Proto-prijs |
$6,40 input, $0,32 gecachte input en $32 output per 1 miljoen tokens — 20% korting |
| Beste vroege toepassing |
Complexe debugging, code-review, migraties, data-analyse, professionele documenten, wetenschap, CAD en 3D-workflows |
| Beter dagelijks alternatief |
GPT-6.2 Sol voor routinematig coderen, schrijven en goedkoper werk |
De OpenAI-modeldocumentatie vermeldt ondersteuning voor Responses en Chat Completions, plus tools waaronder webzoeken, bestandszoeken, code-interpreter, hosted shell, computergebruik, MCP en het genereren van afbeeldingen. Het model zelf retourneert tekst. Voltooide spreadsheets, dia's, sites of 3D-assets zijn afhankelijk van de tools en de uitvoeringsomgeving eromheen.
Waar praten vroege gebruikers eigenlijk over?
Het gesprek rond de lancering gaat niet primair over benchmarkscores. Het gaat over de kloof tussen ruwe capaciteit en dagelijkse bruikbaarheid.
1. Astra kan uitstekend zijn in het beoordelen en repareren van bestaande systemen
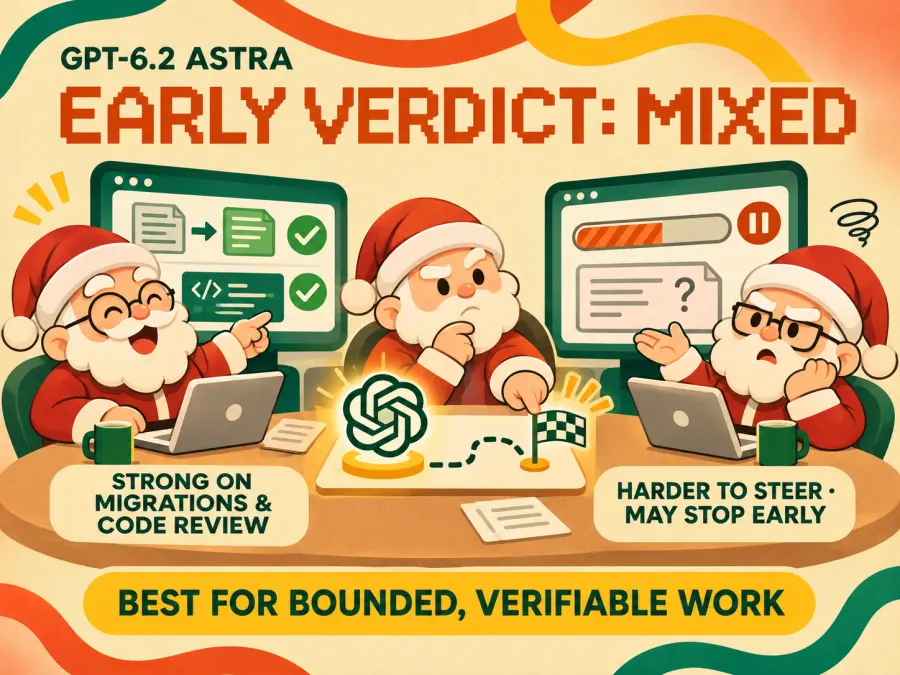
Uit vroege Copilot-tests van GitHub bleek dat GPT-6.2 Astra aanzienlijk meer echte code-review-problemen opspoorde dan GPT-6 Astra, terwijl er minder tokens werden verbruikt. Dat is relevanter voor een productieteam dan weer een one-shot app-demo: het waardevolle werk is vaak het vinden van het defect, het behouden van bestaand gedrag en het bewijzen van de patch met tests.
Engineer Tibor Blaho beschreef het gebruik van Astra in dagelijks infrastructuur- en softwarewerk, waaronder serverbeheer, back-ups, monitoring, onderzoek, administratie, debugging en code-review. Zijn opvallendste voorbeeld was het upgraden van een legacy-applicatie met miljoenen regels code en de bijbehorende oude afhankelijkheden naar een huidige taalversie. Hij rapporteerde een lokaal bruikbaar resultaat na ongeveer drie uur en een geslaagde test na ongeveer zes uur, waarbij hij opmerkte dat er nog meer werk aan de winkel was.
Dit is een anekdote, geen gecontroleerde benchmark. Het is nog steeds een nuttig voorbeeld omdat het een echte codebase, verstreken tijd en een verificatiestap bevat. Het wijst ook op een praktische workflow: Blaho gebruikt Astra en Claude-modellen om elkaars werk te onderzoeken en te beoordelen in plaats van ervan uit te gaan dat één model elk defect opvangt.
2. Lange autonome runs kunnen frustrerend zijn
De negatieve rapporten zijn ook concreet. Dan Shipper’s vroege recensie stelde dat Astra vaak te vroeg stopte bij end-to-end code-builds en zo beknopt kon zijn dat de tekst moeilijk te volgen was. Ethan Mollick noemde het ongelijkmatig en moeilijker aan te sturen: het bouwde met succes een ambitieuze Blender-en-Unity ruimte-lift ervaring, maar toch greep hij er niet naar als zijn dagelijkse model.
Het gedetailleerde verslag van ontwikkelaar Theo is vergelijkbaar verdeeld. Hij prees Astra als code-reviewer, zei dat het nieuwe oplossingen vond en schreef het een reverse-proxy ontwerp toe dat zijn bedrijf $25.000 per maand kon besparen. Hij rapporteerde echter ook lange runs die vastliepen op vragen die hij niet kon beantwoorden, lussen die geen vooruitgang boekten en samenvattingen die moeilijker te begrijpen waren dan de codewijzigingen zelf.
Deze verslagen bewijzen niet dat elke Astra-run zal mislukken. Ze identificeren hetzelfde risico vanuit verschillende invalshoeken: het model is wellicht capabel genoeg om het werk te doen, maar lastig aan te sturen wanneer het doel open einde is.
3. Beknopte output is ofwel efficiëntie ofwel een gebrek aan context
OpenAI’s eigen GPT-6.2 prompting-gids zegt dat Astra standaard beknopter en directer is. Voor een ondersteuningsbericht, een code-review notitie of een executive brief kan dat nuttig zijn. Voor een complexe uitleg kan het voelen alsof het model de redenering heeft overgeslagen die een lezer nodig had.
Dit verklaart waarom vroege reacties tegenstrijdig zijn. Mensen die een strak afgebakende taak testen, zien wellicht minder opvulling en minder tokens. Mensen die Astra gebruiken als medewerker bij een langdurig project, zien wellicht abrupte antwoorden, onverklaarde beslissingen of voortijdige overdrachten.
4. De echte vraag is de vorm van de taak, niet of Astra “slim” is
Het bewijs tot nu toe suggereert een eenvoudige scheidslijn:
| Taakvorm |
Vroege geschiktheid voor Astra |
| Duidelijke doelstelling, tools, tests en eindstreep |
Sterke kandidaat |
| Hoogwaardige review waarbij gemiste defecten duur zijn |
Sterke kandidaat |
| Data uit meerdere bronnen of documentwerk met controleerbare output |
Sterke kandidaat |
| Routine e-mail, notulen of kleine code-aanpassing |
Gebruik meestal eerst Sol |
| Open-ended onderzoek dat oordeelsvermogen vereist over wat belangrijk is |
Vergelijk met Fable 5.2 en behoud menselijke review |
| Urenlange autonome build met ambigue beslissingen |
Test zorgvuldig voordat je erop vertrouwt |
Is GPT-6.2 Astra geschikt voor dagelijks werk?
Ja, maar voor het meeste dagelijkse werk is het niet nodig. Voor notulen van vergaderingen, routinematige e-mails, kort onderzoek, kleine codewijzigingen of een eerste concept is GPT-6.2 Sol het meer natuurlijke startpunt. Dit is het model dat OpenAI positioneert voor dagelijks werk, en de tokentarieven zijn 75% lager dan die van Astra. GPT Proto past dezelfde korting van 20% toe op beide modellen, dus dat prijsverschil blijft ongewijzigd.
Astra wordt nuttig wanneer een gewone werkcategorie verandert in een moeilijke taak met een hoge waarde. “Beoordeel deze pull request” is wellicht geschikt voor Sol; “traceer deze intermitterende fout in drie services, los deze op en voer de getroffen workflows uit” is een taak voor Astra. “Vat deze CSV samen” is routine; “vind de problemen met de datakwaliteit, leg de statistische valkuilen uit en bouw een bewerkbaar beslissingswerkboek” geeft Astra meer ruimte om zijn kosten te rechtvaardigen.
De praktische dagelijkse toepassingen die tot nu toe zijn gerapporteerd, omvatten debugging, serveroperaties, monitoring, back-ups, codebeoordeling, onderzoek uit meerdere bronnen en kantooradministratie. De rode draad is niet het beroep. Het is dat de taak voldoende complexiteit heeft om te profiteren van diepere redenering en voldoende structuur om het resultaat te verifiëren.
Waar is GPT-6.2 Astra goed voor?
Codebeoordeling, analyse van de hoofdoorzaak en modernisering van legacy-systemen
Dit is de duidelijkste praktische use case. Geef Astra de falende workflow, relevante logboeken, repository en testcommando's. Vraag het om de fout over services heen te traceren, de meest nauwkeurige veilige oplossing te implementeren en de getroffen tests uit te voeren. Dat komt overeen met OpenAI's eigen aanbevolen Astra-workflow en de positieve rapporten van GitHub en vroege engineers.
Legacy-upgrades kunnen bijzonder geschikt zijn omdat de taak moeilijk maar verifieerbaar is. Het model kan oude afhankelijkheden inspecteren, code in fasen bijwerken en herhaaldelijk een schone build uitvoeren. De mens moet nog steeds de compatibiliteitsvereisten definiëren en de migratie beoordelen. “Alle tests geslaagd” is alleen bewijs als de testsuite het gedrag dekt dat ertoe doet.
Voor normale pull-request-beoordeling of een kleine revisie is GPT-6.2 Sol wellicht voldoende. OpenAI raadt Sol expliciet aan voor dagelijks coderen, en het kost een kwart van de standaard invoer- en uitvoertarieven van Astra.
Data-analyse, dashboards en bewerkbare werkboeken
Astra's waarde hier is niet alleen het schrijven van een SQL-query. Het kan gegevens inspecteren, kwaliteitsproblemen opmerken, aannames formuleren, analyses uitvoeren en de resultaten omzetten in een werkboek, grafiek of dashboard dat iemand anders kan beoordelen.
Een onafhankelijke Plotly data-analyse-test biedt een nuttig voorbeeld van een echte taak. Astra slaagde voor 41 van de 43 vragen, ontdekte alle geplaatste problemen met datakwaliteit, vermeed alle vijf statistische valkuilen en voltooide de run voor $4,11. De mediaan van de vragen duurde 12,4 seconden, tegenover 26,9 seconden voor GPT-6 Astra. De afweging is belangrijk: het miste twee verborgen patronen, en GPT-6.1 Sol behaalde een perfecte score in die test voor $2,61. Astra was snel en capabel, maar niet automatisch de goedkoopste of meest nauwkeurige optie.
OpenAI's Alderfen waarderingsvoorbeeld toont de documentkant van dezelfde mogelijkheid. Astra bouwde een bewerkbaar DCF-werkboek dat de omzet tot 2031 voorspelde, drie financiële overzichten verzoende, de waarde per aandeel berekende en de belangrijkste drijfveren naast de gevoeligheidstabel plaatste. Behandel dit als een leveranciersdemo, niet als onafhankelijk bewijs. Het is nog steeds een nuttig sjabloon voor een test die u met uw eigen spreadsheet kunt reproduceren.
Financiële, boekhoudkundige, juridische werkzaamheden en professionele documenten
GPT-6.2 Astra is getraind om professionele conventies te volgen in dia's, spreadsheets, memo's en documenten. OpenAI rapporteert winst in financiële, boekhoudkundige, consultancy-, verkoop- en juridische workflows. Resultaten van klanten op de lanceringspagina omvatten minder revisierondes voor apps, dashboards en dia's, evenals kortere doorlooptijden voor langlopende boekhoudkundige werkzaamheden. Dit zijn door de leverancier geselecteerde resultaten, dus ze moeten worden gelezen als veelbelovende use cases in plaats van gegarandeerde uitkomsten.
De beste toepassingen zijn controleerbare resultaten:
Een financieel model waarvan de formules kloppen en correct reageren wanneer aannames veranderen.
Een juridische memo waarvan de claims kunnen worden herleid naar verstrekte autoriteiten en brondocumenten.
Een presentatie die een bestaand sjabloon volgt en elke titel omzet in een onderbouwde conclusie.
Een compliance-tracker die elke vereiste koppelt aan bewijsmateriaal, een eigenaar en een status.
Onafhankelijk bewijs is minder vleiend voor open-ended werk. In Epoch AI’s realistische werkplekevaluatie voldeed geen enkel getest model aan de werknemersnorm van Epoch voor enige taak. GPT-6.2 Astra behaalde gemiddeld 65%, 17 punten onder Claude Fable 5.2. Epoch ontdekte dat Astra was verbeterd ten opzichte van GPT-6 Astra op het gebied van beknopt schrijven, grafisch ontwerp en datacenteronderzoek, maar dat het te voorzichtig kon zijn en conclusies kon weglaten die door het beschikbare bewijsmateriaal werden ondersteund.
Die schijnbare tegenstrijdigheid is precies het punt. Astra kan erg sterk zijn wanneer de beoordelingscriteria en de output expliciet zijn. Wanneer het werk vereist dat er beslissingen worden genomen over wat belangrijk is, dat er gekalibreerde aannames worden gedaan en dat er wordt geïtereerd op een onzeker onderzoeksplan, zijn de modelkeuze en menselijk toezicht belangrijker.
Wetenschappelijke analyse en technisch onderzoek
OpenAI positioneert wetenschap als een belangrijke Astra-use case en rapporteert toonaangevende resultaten op terminal-gebaseerde wetenschappelijke workflows. Een apart vroeg signaal van gebruikers komt van biomedisch onderzoeker Derya Unutmaz, die de voorkeur gaf aan Astra voor wetenschap en langetermijn-programmering, terwijl hij nog steeds de voorkeur gaf aan Opus 5.5 voor ontwerpgevoel en emotionele intelligentie. Hij beschreef zijn eigen biomedische onderzoekservaring met Astra ook als sterk.
Dit betekent niet dat Astra zelfstandig publicatieklaar onderzoek kan produceren. De Epoch-evaluatie wees uit dat grensverleggende modellen nog steeds bestaande ideeën hergebruikten, te zwaar leunden op eerste pogingen en moeite hadden om de belangrijkste bevindingen te identificeren. Gebruik Astra om te zoeken, analyses te coderen, bronnen te vergelijken, een gestelde hypothese te testen of een concept uit te dagen. Behandel een zelfverzekerd onderzoeksverhaal niet als validatie.
CAD, simulatie, 3D-ontwerp en visuele prototypes
Hier zijn de lanceringsvoorbeelden interessanter dan de spellen. OpenAI liet zien hoe Astra voertuigonderdelen modelleerde, een Python-solver schreef voor chassisdynamica, het resultaat animeerde in Blender en een montagehandleiding en onderdelencatalogus maakte voor een op afstand bestuurbare buggy. Deze voorbeelden combineren visueel redeneren, code, computergebruik en documentatie in één workflow.
Die combinatie kan helpen bij vroege technische verkenning: zet referentieafbeeldingen en handleidingen om in een bewerkbaar model, test een revisie in een simulatie en produceer een visuele uitleg voor een beoordelaar. Een fysiek ontwerp heeft nog steeds technische validatie nodig. Een plausibele animatie is geen bewijs dat belastingen, toleranties, materialen of veiligheidseisen correct zijn.
Kan GPT-6.2 Astra games bouwen?
Ja. Meridian Sound Racing is een speelbare browserdemo, en het ruimte-liftproject van Ethan Mollick combineerde Blender, Unity, een browserervaring en gesimuleerde gewichtloze fysica.
Maar "kan een game bouwen" is niet de beste samenvatting van Astra. Deze projecten zijn het bewijs dat het model code, 3D-assets, tools en interactie over een grote build kan coördineren. Dezelfde mogelijkheden zijn nuttig voor simulaties, trainingservaringen, digitale tweelingen, productconfiguratoren en interactieve dataverhalen.
Creatieve consistentie moet ook worden getest. Vroege gebruikers rapporteerden sterke standaard visuele instincten, maar herhalende ontwerppatronen en zwakkere controle over de stijl. Geef Astra een visuele referentie, typografie, doelgroep, interactieregels en expliciete niet-doelen. Beoordeel vervolgens de tweede revisie, niet alleen de eerste screenshot.
Hoe krijg je betere resultaten van GPT-6.2 Astra
De klachten uit de community suggereren dat Astra een explicieter operationeel overzicht nodig heeft dan een normale chatprompt. De gids van OpenAI waarschuwt ook dat het model een volgende stap kan voorstellen en kan wachten wanneer de intentie onduidelijk is.
Gebruik een promptstructuur zoals deze:
Doel:
Voltooi [specifieke oplevering].

Klaar wanneer:

1. [Acceptatiecheck]

2. [Test of bewijs]

3. [Vereist uitvoerformaat]

Autonomie:
Maak redelijke, omkeerbare aannames en ga door zonder te wachten.
Vraag alleen als een beslissing het resultaat materieel zou veranderen of een onomkeerbare actie zou veroorzaken.

Beperkingen:

- Behoud [bestaand gedrag of stijl].

- Verander niets aan [buiten-scope gebied].

- Gebruik [tools, bestanden, bronnen of conventies].

Verificatie:
Voer [tests of checks] uit. Rapporteer expliciet elk ontbrekend bestand, mislukte tool, niet-ondersteunde aanname of onvolledige stap.

Eindoverdracht:
Vat samen wat er is veranderd, wat is geverifieerd, resterende risico's en totaal gebruik/kosten.
Houd voor API-werk met meerdere beurten het eerdere prompt-voorvoegsel ongewijzigd en voeg nieuwe instructies toe. OpenAI zegt dat dit het redeneren behoudt en het hergebruik van de prompt-cache verbetert. Geef voor front-end of visueel werk een echte referentie en noem de typografie en beelden die je wilt. "Maak het modern" is geen design-systeem.
Wat kost GPT-6.2 Astra per taak?
Deze tarieven zijn in USD per miljoen tokens voor verzoeken tot 272.000 input-tokens. De GPT Proto-rijen passen de huidige korting van 20% toe op de standaardtarieven van OpenAI.
| Model en route |
Input |
Gecachte input |
Output |
| GPT-6.2 Astra — OpenAI standaard |
$8,00 |
$0,40 |
$40,00 |
| GPT-6.2 Astra op GPT Proto — 20% korting |
$6,40 |
$0,32 |
$32,00 |
| GPT-6 Astra — OpenAI standaard |
$10,00 |
$1,00 |
$50,00 |
| GPT-6.2 Sol — OpenAI standaard |
$2,00 |
$0,10 |
$10,00 |
| GPT-6.2 Sol op GPT Proto — 20% korting |
$1,60 |
$0,08 |
$8,00 |
Voor een verzoek met 20.000 niet-gecachte input-tokens en 5.000 gefactureerde output-tokens, zouden de standaard tokenkosten $0,36 op GPT-6.2 Astra, $0,45 op GPT-6 Astra en $0,09 op GPT-6.2 Sol bedragen. Tegen de huidige tarieven van GPT Proto kosten dezelfde aantallen tokens $0,288 op Astra of $0,072 op Sol. Een echte agent-taak kan herhaaldelijke modelaanroepen doen, gecachte context hergebruiken, mislukte tools opnieuw proberen of een veel langer resultaat produceren.
Bij meer dan 272.000 input-tokens in één verzoek verdubbelen de input- en cachetarieven van Astra en kosten de output-kosten 1,5 keer het tarief voor korte context voor het gehele verzoek. Het contextvenster van 1,05M is nuttig, maar het achteloos vullen ervan kan leiden tot een hoge rekening. Meet de kosten per voltooide taak, niet alleen de prijs per miljoen tokens.
De Plotly-run geeft een concreet voorbeeld: 43 analysevragen kosten $4,11 op GPT-6.2 Astra, vergeleken met $19,97 op GPT-6 Astra. Toch kostte GPT-6.2 Sol $1,22 en voltooide het slechts één vraag minder. De upgrade van Astra is reëel; het goedkopere model kan voor routinematig productieverkeer nog steeds een betere economische keuze zijn.
Beide routes met korting zijn nu live. Bekijk de GPT-6.2 Astra-modelpagina of GPT-6.2 Sol-modelpagina voor het huidige model-ID en de verzoekindeling voordat u productieverkeer verstuurt. De OpenAI-modelcollectie bevat de rest van de beschikbare OpenAI-modellen.
Is GPT-6.2 Astra beter dan Claude Fable 5.2?
Niet voor elk type werk.
OpenAI rapporteert dat Astra het strikte slagingspercentage van Fable 5.2 op een benchmark voor juridische agenten met meer dan het dubbele heeft overtroffen, tegen ongeveer een zesde van de kosten. In Cognition’s FrontierCode 2.0 scoorde Fable 5.2 echter hoger bij wijzigingen aan bestaande codebases. De open-ended werkplekevaluatie van Epoch gaf ook de voorkeur aan Fable 5.2 met 17 punten.
| Kies GPT-6.2 Astra wanneer… |
Kies Claude Fable 5.2 wanneer… |
| Code review, debugging, toolgebruik of een controleerbaar technisch resultaat centraal staat |
De taak open-ended is en een sterk oordeelsvermogen vereist over wat belangrijk is |
| Je CAD-, simulatie-, 3D- of computergebruik-workflows nodig hebt |
Samenwerkingsstijl en leesbare uitleg in lange vorm belangrijker zijn |
| Herhaalde taakkosten en cache-efficiëntie belangrijk zijn |
Je eigen representatieve tests minder interventies of een betere voltooiing laten zien |
| Je een tweede model wilt om het werk van een andere agent te beoordelen |
Je een tweede model wilt om de aannames en patches van Astra uit te dagen |
Het meest praktische antwoord is wellicht om beide te gebruiken. De vroege cross-review workflow beschreven door Tibor Blaho is geloofwaardiger dan het uitroepen van één universele winnaar: laat het ene model implementeren of onderzoeken, en laat het andere vervolgens zoeken naar gemiste defecten en ongefundeerde aannames.
Voor een creatieve vergelijking kun je de interactieve aquarel-briefing uit onze Claude Fable 5.2-test opnieuw gebruiken. Geef beide modellen hetzelfde bestaande project en vraag om een nieuwe controle zonder de huidige te verbreken. Vergelijk de nauwkeurigheid bij de eerste poging, het aantal revisies, de kwaliteit van de uitleg, het totaal aantal tokens en de kosten per voltooide taak. Je kunt toegang tot Fable vinden op de Claude Fable 5.2 API-pagina.
Waar kun je GPT-6.2 Astra gebruiken?
ChatGPT Work: GPT-6.2 Astra is beschikbaar in Work in plaats van de reguliere ChatGPT Chat. Toegang is afhankelijk van het abonnement, de instellingen van de werkruimte en de uitrolstatus.
Codex: Ja. Kies Astra in de Codex-app of gebruik /model in de CLI. Het is de door OpenAI aanbevolen optie voor het traceren van lastige bugs in verschillende services en het voltooien van de reparatie en tests.
Claude Code: Er is geen native GPT-6.2 Astra-optie. De LLM gateway-documentatie van Anthropic stelt dat het routeren van Claude Code naar niet-Claude-modellen via een gateway buiten de ondersteuning valt.
OpenAI API: Gebruik het officiële model-ID gpt-6.2-astra. OpenAI raadt de Responses API aan voor workflows met tool-calling.
GPT Proto: Zowel GPT-6.2 Astra als GPT-6.2 Sol zijn live tegen 20% onder de standaard API-token-tarieven van OpenAI. Kies Astra voor complexe redeneringen en controleerbare professionele resultaten; kies Sol voor routinematig coderen, schrijven en werklasten met een hoger volume. De eerdere uitroltijdlijn van GPT-6.2 Astra legt de pre-launch Codex-waarnemingen vast.
Het volgende verzoek gebruikt het live Astra-model-ID. Je kunt het nieuwste integratiefragment rechtstreeks van de modelpagina kopiëren.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  --header "Authorization: Bearer ${GPTPROTO_API_KEY}" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.2-astra",
    "messages": [
      {
        "role": "user",
        "content": "We verkochten 12 eenheden voor $25 per stuk. Elke eenheid kostte $10. Retourneer de omzet en brutowinst in USD als JSON met de sleutels revenue en gross_profit."
      }
    ]
  }'
De omzet zou $300 moeten zijn en de brutowinst $180. Voor een goedkopere routinematige uitvoering kun je overschakelen naar het exacte model-ID dat wordt getoond op de GPT-6.2 Sol-pagina. Je kunt ook door de OpenAI-modelcollectie bladeren voor andere beschikbare modellen.
Conclusie
Het meest overtuigende voordeel van GPT-6.2 Astra is niet dat het een game kan bouwen. Het is het vermogen om redeneren, code, tools, bestanden en computergebruik te combineren voor werk met een meetbare eindstreep: een bug opgelost en getest, een migratie die foutloos bouwt, een werkboek dat reconcilieert, of een analyse die zijn aannames blootlegt.
De beperking is even praktisch. Vroege gebruikers beschrijven herhaaldelijk een model dat briljant kan zijn in de taak, maar toch moeilijk aan te sturen of te begrijpen is op de lange termijn. Gebruik Sol voor routinematig werk. Gebruik Astra wanneer de klus moeilijk genoeg is om het te rechtvaardigen, definieer "klaar" nauwkeurig, verifieer het resultaat en vergelijk het met Fable 5.2 voor taken waarbij onderzoeksgerichtheid en samenwerkingsstijl van belang zijn.