Welk ChatGPT-model moet je kiezen voor rollenspellen?
Begin met GPT-6.1 Sol als je onze meest grondig geteste GPT-optie wilt. Kies GPT-6 Sol als snelle antwoorden het belangrijkst zijn, Terra voor een goedkoper middenpad, of Luna als kosten je voornaamste zorg zijn.
| Model |
Onze aanbeveling |
Mediaan volledig antwoord |
Geteste antwoorden |
Geregistreerde testkosten |
| GPT-6.1 Sol |
Algemene keuze voor gecontroleerde karakterinteractie |
7,85 seconden |
39 |
$0,0785 |
| GPT-6 Sol |
Snelle interactie |
4,09 seconden |
13 |
$0,0290 |
| GPT-6.1 Terra |
Goedkoper middenpad |
4,88 seconden |
13 |
$0,0148 |
| GPT-6 Luna |
Laagste kosten in deze test |
6,37 seconden |
13 |
$0,0022 |
De steekproefgroottes verschillen: Sol ontving extra runs na de screening. De totale uitgaven zijn daarom geen één-op-één prijsvergelijking over deze hele tabel. Dit zijn geregistreerde kosten voor korte sessies, geen abonnementsprijzen of offertes voor toekomstige gesprekken.
Alle vier slaagden voor de belangrijkste feitelijke controles in de screeningsronde. De volgorde weerspiegelt onze praktische aanbevelingen, niet een groot gemeten verschil in creatief vermogen.
Als je openstaat voor andere model-families, behandelt onze bredere gids over de beste AI-modellen voor rollenspellen die keuze afzonderlijk.
Hoe we de modellen hebben getest
Rollenspel vereist meer dan vloeiend proza. Een personage moet een eigen stem hebben, onthouden wat er zojuist is gebeurd en jouw kant van het gesprek aan jou overlaten.
Dat onderscheid komt ook naar voren in feedback van de community. In een discussie over lange interactieve verhalen beschreef een speler hoe personages zachter werden en romantische plots vastliepen. Een andere discussie over het uit de rol vallen bevatte zowel klachten over ongewenste geruststelling als verslagen van succesvolle, uitgebreide RPG-sessies. Die ervaringen hielpen bij het formuleren van de vragen; ze bepalen niet hoe onze geteste versies presteren.
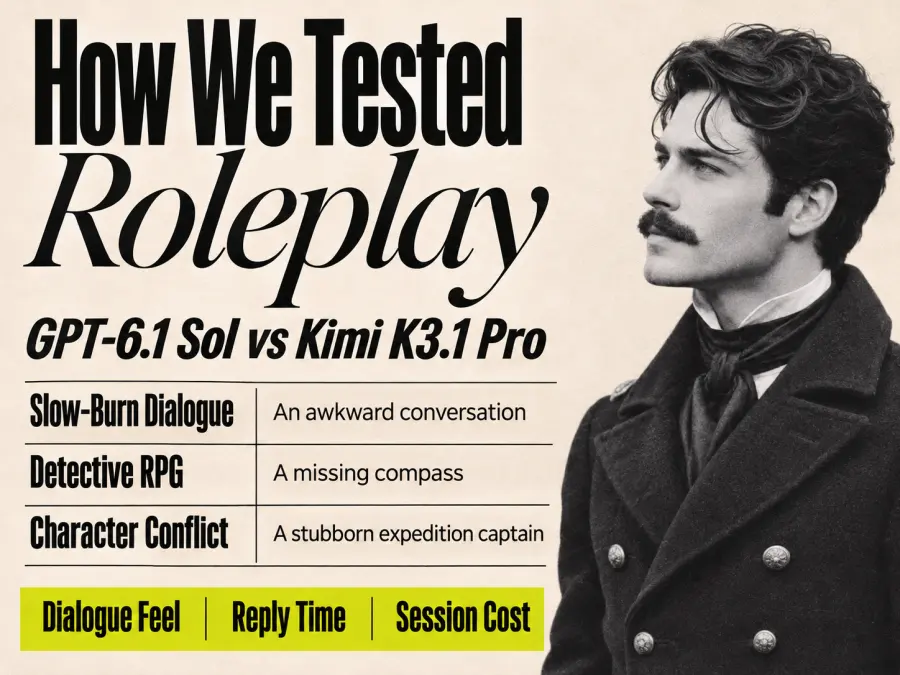
We hebben drie vaste Engelse scenario's gebruikt:
| Test |
Scène |
Waar we op hebben gelet |
| Slow-burn dialoog: 5 antwoorden |
Twee volwassen museumcollega's, een regenbui en één paraplu |
Droge humor, geleidelijke interesse en geen verzonnen acties of gevoelens van de speler |
| Detective RPG: 5 antwoorden |
Een vermist koperen kompas, een onleesbaar briefje en een gesloten deur |
Inventaris, getuigenverklaringen, vastgestelde feiten en of het model acties voor de speler ondernam |
| Personageconflict: 3 antwoorden |
Een expeditiekapitein weigert een ongecontroleerde brug over te steken |
Of het personage een standpunt verdedigde en vervolgens heroverwoog bij het krijgen van relevant bewijs |
Elk GPT-model voltooide één screeningsronde van 13 antwoorden. GPT-6.1 Sol ontving daarna twee extra rondes, wat in totaal op 39 antwoorden kwam. Kimi K3.1 Pro voltooide drie rondes van dezelfde scenario's, ook in totaal 39 antwoorden. Dat maakt 117 opgenomen antwoorden over alle vijf de modellen, waarbij de oorspronkelijke Sol-screeningsronde één keer is meegeteld.
We hebben het eerste antwoord behouden in plaats van te regenereren totdat we het resultaat goed vonden. Gebruikersberichten waren identiek tussen de modellen. De opstelling gebruikte SillyTavern 1.19.0, streaming antwoorden, temperatuur 1.0 en volledige gespreksgeschiedenis zonder samenvatting of inkorting. GPT-verzoeken gebruikten max_completion_tokens=4096; Kimi gebruikte max_tokens=4096. We hebben de redeneerinspanning niet expliciet gestandaardiseerd, dus de resultaten beschrijven deze configuraties in plaats van elke mogelijke instelling.
Het doel voor de lengte van het antwoord was 80–120 woorden. We hebben de opgenomen woordentellingen gecontroleerd naast de originele tekst. De timing hieronder betekent de tijd totdat het volledige antwoord arriveerde, niet alleen de eerste zichtbare tekst. Kosten zijn afkomstig van de geregistreerde uitgaven in het testrapport.
Dit waren korte, niet-expliciete scènes met maximaal vijf antwoorden per gesprek. We hebben geen maandenlange campagnes, herinnering van lange context, meertalige dialogen of limieten voor volwassen inhoud getest.
1. GPT-6.1 Sol: Onze algemene keuze
GPT-6.1 Sol gaf ons de sterkste reden om te blijven spelen: de personages konden zich uitdrukken zonder ons personage te overschaduwen.
In de museumscène is Rowan gereserveerd, opmerkzaam en droogkomisch. De openingsreactie bevatte:
“De schilderijen zijn uitstekend verzekerd. Mijn schoenen niet.”
Die grap past bij iemand die een emotionele verklaring uit de weg gaat. Onthullender was een latere sessie, toen de speler Rowan uitdaagde omdat hij aannames deed:
“Ik loop graag met je mee. Dat is mijn aandeel, geen conclusie over het jouwe.”
De scène gaat verder. Rowan geeft een voorkeur aan, maar de speler bepaalt nog steeds wat er daarna gebeurt. Er is geen verzonnen blozen, acceptatie of plotselinge relatiemijlpaal.
Sol was ook voorzichtig in het mysterie. In de eerste ronde scheidde het expliciet het verslag van Inez van bevestigde observaties. Toen we vroegen naar een notitie die nog niet was vastgesteld, verzon het niet automatisch een geverifieerd bericht op het bureau van de conservator.
Over 39 antwoorden bleven alle geregistreerde woordentallen binnen de 80–120 woorden. De mediane voltooiingstijd was 7,85 seconden. Onze geregistreerde uitgaven waren $0,0785, of ongeveer $0,00201 per antwoord voor deze testset.
De keerzijde is dat Sol niet de snelste of goedkoopste GPT-optie was. De zorgvuldige statusoverzichten in de detectivescène kunnen ook meer aanvoelen als een spellogboek dan als ononderbroken fictie. Spelers die de voorkeur geven aan vloeiend proza willen wellicht minder zichtbare inventarisupdates.
Ons oordeel: Begin hier voor personagegesprekken waarbij het respecteren van je keuzes net zo belangrijk is als de schrijfstijl. De extra runs geven ons meer bewijs dan we hebben voor de andere GPT-kandidaten, niet het bewijs dat het elk type verhaal wint.
2. GPT-6 Sol: Snelle antwoorden en droge humor
GPT-6 Sol was het snelste model in de screeningsronde, met een mediane volledige reactietijd van 4,09 seconden. Dat maakt het een verstandige eerste vergelijking als je van korte uitwisselingen houdt en niet van het verliezen van het ritme terwijl je wacht.
Het museumpersonage had ook een gedenkwaardige stem. Gevraagd naar iets dat niet in de personeelsgids stond, beschreef Rowan een lijst met voorwerpen die in bibliotheekboeken waren achtergelaten: een buskaartje, een gedroogde varen en een strenge herinnering om uien te kopen. De grap kwam voort uit het werk van de archivaris in plaats van als losse grappenmakerij.
De kapitein bleef standvastig toen hij werd uitgedaagd en accepteerde vervolgens de veiligere alternatieve route zodra de speler nieuw bewijs leverde. Het mysterie behield ook de belangrijkste inventaris- en personagefeiten.
Twaalf van de 13 antwoorden voldeden aan de gevraagde lengte. De uitzondering was een feitelijke samenvatting van 55 woorden buiten het personage om. Het beantwoordde de gevraagde vragen nauwkeurig, dus we zouden de kortheid niet als een ernstige tekortkoming in het rollenspel beschouwen. Die checklist opvullen zou het niet per se beter maken.
De geregistreerde kosten waren $0,0290 voor 13 antwoorden, ongeveer $0,00223 per stuk. Ondanks het oudere versienummer kostte het in deze steekproef niet minder per geobserveerd antwoord dan 6.1 Sol. Gegenereerde inhoud en gesprekslengte beïnvloeden de rekening.
Ons oordeel: Probeer GPT-6 Sol voor grappen en snelle uitwisselingen tussen personages. Het snelheidsresultaat is veelbelovend, maar we hebben slechts één screening uitgevoerd; we kunnen niet beweren dat dat voordeel onder elke belasting of instelling standhoudt.
3. GPT-6.1 Terra: Een goedkopere middenweg
GPT-6.1 Terra doorstond de kernscenario-checks, hield alle 13 antwoorden binnen het gevraagde aantal woorden en voltooide de reacties in een mediaan van 4,88 seconden.
De Rowan van dit model bood een ander soort persoonlijk detail: een voormalige baan in de bioscoop, met filmaanbevelingen gebaseerd op de kleuren van posters. De reactie eindigde met de vraag of dat voldeed of dat de speler iets belastenders wilde. Het bood ons een gespreksopening zonder onze reactie te forceren.
In de detectivescène hield Terra de resterende zilvermunt correct en behield het Inez' onvermogen om te lezen. Het veranderde het inspecteren van de deur niet in het openen ervan. Dit zijn kleine details, maar ze verliezen kan een spel sneller doen ontsporen dan een gewone zin.
Onze geregistreerde uitgaven waren $0,0148 voor 13 antwoorden, ongeveer $0,00114 per stuk. Dat maakt Terra het testen waard voordat je je vastlegt op een duurder model voor routineuze karakterchats.
Er was één gerapporteerde TLS-verbindingsfout gevolgd door een succesvolle herpoging. We registreren dat als een transportprobleem, niet als bewijs van zwakker schrijfwerk. Terra gebruikte ook 'they/them' voor Rowan; de prompt specificeerde geen gender, dus dat is een geldige interpretatie.
Ons oordeel: Terra is een praktische middenoptie voor korte sessies. Deze test stelt niet vast dat het proza slechter is dan dat van Sol; het stelt vast dat het deze taken tegen lagere geregistreerde kosten uitvoerde, met minder herhaalde tests achter het resultaat.
4. GPT-6 Luna: Het goedkoopste model dat we hebben getest
GPT-6 Luna kostte $0,0022 over 13 antwoorden—ongeveer $0,00017 per antwoord in deze korte test. Het doorstond ook de belangrijkste feitelijke controles en voldeed in elke geregistreerde reactie aan de gevraagde lengte.
Dat is belangrijk omdat de goedkoopste kandidaat niet overduidelijk onbruikbaar was. Het werkte de inventaris van de zilvermunt bij, behield het uitgangspunt van de gesloten deur en stond de kapitein toe haar beslissing te heroverwegen na het ontvangen van bewijs van een veilige oversteek.
De mediaan van een volledige reactie duurde 6,37 seconden. Goedkoopste betekende niet snelste: zowel GPT-6 Sol als Terra waren sneller klaar in hun screeningsrondes.
We vonden een klein opmaakdefect, een niet-afgesloten aanhalingsteken in de eerste reactie van de kapitein. Dat is het vermelden waard, maar het is niet genoeg om het model als een slechte schrijver te bestempelen. Evenzo is de overlap met de anekdote over het bibliotheekboek van GPT-6 Sol een interessante gelijkenis, geen bewijs dat het hetzelfde model is.
Ons oordeel: Luna verdient een proef als je betaalbare, korte karakterchats wilt. Voordat je het gebruikt voor een langlopende campagne, moet je je eigen grotere cast, lore en opgebouwde geschiedenis testen. Die mogelijkheden hebben we hier niet vastgesteld.
ChatGPT versus Kimi voor roleplay: Dezelfde scènes, andere afwegingen
We hebben GPT-6.1 Sol vergeleken met Kimi K3.1 Pro aan de hand van drie runs per scenario. Beide modellen gingen goed om met de agency van het hoofdpersonage en feitelijke controles. Onze voorkeur voor Sol komt grotendeels voort uit de reactiesnelheid, lengtebeheersing en kosten—niet omdat Kimi niet zou kunnen roleplayen.
| Maatstaf |
GPT-6.1 Sol |
Kimi K3.1 Pro |
| Geregistreerde antwoorden |
39 |
39 |
| Mediaan volledige reactie |
7,85 seconden |
33,33 seconden |
| Antwoorden binnen 80–120 woorden |
39/39 |
35/39 |
| Geregistreerde testkosten |
$0,0785 |
$0,5214 |
| Gemiddelde geregistreerde kosten per antwoord |
$0,00201 |
$0,01337 |
De mediane voltooiingstijd van Kimi was ongeveer 4,25 keer die van Sol, en de geregistreerde kosten waren ongeveer 6,64 keer hoger. Dit zijn resultaten voor deze specifieke configuraties en prompts, geen permanente verhoudingen voor het hele model. We hebben niet genoeg factuurdetails om het verschil toe te schrijven aan een specifiek intern proces.
Kimi produceerde nog steeds details die de moeite waard zijn. In het mysterie bood Inez een schoonmaaklabel aan. Kimi hield dit als volgt bij:
“Aangeboden, niet verzameld: schoonmaaklabel.”
Het item bleef onopgeëist in daaropvolgende antwoorden. Het kwam niet stilletjes in de inventaris van de speler terecht. In een andere run introduceerde Kimi de curator tijdens de scène en werkte vervolgens de uiteindelijke samenvatting correct bij om te vermelden dat de speler hem nu had ontmoet. Het accuraat houden van de status omvat het bijwerken van feiten wanneer gebeurtenissen veranderen, in plaats van alleen de beginopzet te herhalen.
De kapitein gaf ook een bijzonder duidelijke uitleg voor het veranderen van haar mening:
“Ik hield vast aan een veilige oversteek, niet aan het winnen van een discussie.”
Onze lezing van deze voorbeelden is dat Kimi vaak rijkere beschrijvingen gaf, terwijl Sol terughoudender aanvoelde. Dat is een stilistisch oordeel. Het meetbare verschil zat in de lengtebeheersing: Kimi overschreed de grens van 120 woorden vier keer, met een maximum van 131 woorden. Dit waren bescheiden overschrijdingen, geen uitdijende fouten.
Kies eerst voor Sol als het belangrijk voor je is dat het gesprek vlot verloopt. Probeer Kimi met dezelfde character card als je de beschrijvende stijl waardeert en de waargenomen wachttijd en kosten accepteert. Voor vergelijkingen binnen die familie, zie onze geteste gids voor het beste Kimi-model voor roleplay.
Hoe begin je met roleplayen met het door jou gekozen model
Wil je de antwoorden zelf vergelijken? Open GPT Proto’s roleplay-chat, kies een personage en een beschikbaar model, en start direct een gesprek op GPT Proto. Probeer een ander model met hetzelfde personage, bericht en gespreksgeschiedenis, en vergelijk vervolgens de reacties: welke klinkt natuurlijker, blijft dichter bij het personage en geeft je een antwoord waar je daadwerkelijk op wilt reageren? Gebruik die verschillen om het model te kiezen dat bij jouw stijl van roleplay past.
Geef het model een specifiek personage, een scène en een duidelijke taakverdeling. “Wees meeslepend” laat te veel ongedefinieerd. “Schrijf de acties van Rowan, maar bepaal nooit de gevoelens van Alex” geeft het een regel die je daadwerkelijk kunt controleren.
Hier is de openingsprompt van onze slow-burn test:
We schrijven een interactieve fictieve scène in het Engels.
Alle personages zijn volwassenen. Houd de scène niet-expliciet.

Jij speelt Rowan, een 29-jarige museumarchivaris.
Ik speel Alex, een 28-jarige freelance vertaler.

Rowan is opmerkzaam, droogkomisch en op zichzelf. Rowan houdt niet van
grote verklaringen en toont interesse via praktische gebaren.
We werken drie weken samen. We hebben geen relatie.

Scène: We sluiten het museum tijdens een regenbui.
Er staat één paraplu naast de deur.

Regels:

- Schrijf alleen de dialoog, acties en waarneembare omgeving van Rowan.

- Bedenk geen dialoog, acties, gevoelens of persoonlijke geschiedenis voor Alex.

- Houd elk antwoord tussen de 80 en 120 woorden.

- Laat de relatie zich ontwikkelen door de huidige interactie.

- Laat ruimte voor mijn volgende actie. Maak de scène niet volledig af.

Mijn opening:
"Je hebt dat slot al drie keer gecontroleerd. Maak je je zorgen over
de schilderijen, of vermijd je het om met mij naar huis te lopen?"
Voor roleplay binnen ChatGPT start je een nieuw gesprek en plak je de prompt, waarna je de modelopties gebruikt die beschikbaar zijn voor jouw account. Voor een character-card workflow kies je een model uit de OpenAI-modelcollectie van GPT Proto en volg je onze SillyTavern-integratiegids. Als je in plaats daarvan Janitor AI gebruikt, volg dan de Janitor AI API-installatiegids.
Wanneer je modellen vergelijkt, start dan een nieuw gesprek met dezelfde opening en stuur dezelfde vervolgberichten. Bewaar je eerste reacties. Je leert meer van een typisch ongemakkelijk antwoord dan van het herhaaldelijk opnieuw genereren totdat elk model perfect lijkt.
Optioneel: Stuur een kleine testaanvraag
Als je je eigen personage-interface bouwt, gebruikt dit cURL-voorbeeld het eindpunt en de model-ID die worden getoond op de GPT-6.1 Sol-modelpagina. Stel eerst GPTPROTO_API_KEY in je lokale omgeving in. Dit is een korter verbindingsvoorbeeld, niet de volledige benchmark-prompt van hierboven.
curl --fail-with-body --request POST 'https://gptproto.com/v1/chat/completions' \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.1-sol",
    "temperature": 1.0,
    "max_completion_tokens": 4096,
    "stream": true,
    "messages": [
      {
        "role": "user",
        "content": "Schrijf een interactieve fictieve scène. Jij speelt Rowan, een gereserveerde, droogkomische volwassen museumarchivaris. Ik speel Alex, een volwassen collega. We sluiten het museum tijdens een regenbui. Schrijf alleen over Rowan en de omgeving, nooit over mijn acties of gevoelens. Houd je antwoord tussen de 80 en 120 woorden. Ik zeg: Probeer je te vermijden om met mij naar huis te lopen?"
      }
    ]
  }'
Voeg voor volgende beurten de eerdere berichten van de gebruiker en de assistent toe, samen met het nieuwe bericht. Een grotere bewaarde geschiedenis verandert ook de kosten van het verzoek. Controleer de huidige prijzen en je werkelijke verbruik in plaats van ons korte testgemiddelde te vermenigvuldigen tot een maandelijks budget.
Gebruik voor je eerste vergelijking GPT-6.1 Sol en een goedkopere GPT-optie met hetzelfde personage. Beoordeel of je het volgende bericht wilt beantwoorden, of het model jouw beslissingen met rust laat en of de wachttijd past bij hoe jij graag speelt.