Welk Kimi-model moet je kiezen?
| Model |
Onze aanbeveling |
Wat viel op |
Belangrijkste afweging |
| Kimi K3.1 Pro |
Eerste keuze voor gecontroleerde character roleplay |
Subtiele dialoog en betere naleving van lengte in onze test van 15 beurten |
Langste gemiddelde wachttijd voor een volledig antwoord |
| Kimi K3 |
Alternatief voor expressieve dialoog |
Gedenkwaardige zinnen en kortere wachttijden dan Pro in deze run |
Meer antwoorden overschreden de gevraagde woordlimiet |
| Kimi K2.6 |
Budgetkeuze voor snelle, informele Engelse chats |
Laagste geregistreerde kosten en kortste wachttijden |
Meer verzonnen spelersgeschiedenis en ongelijkmatige taal kwaliteit |
Dit zijn aanbevelingen op basis van onze testset, geen universele ranglijsten. Als je nog steeds twijfelt tussen Kimi en andere modelreeksen, begin dan met onze bredere gids over de beste AI-modellen voor roleplay.
Hoe we Kimi hebben getest voor roleplay
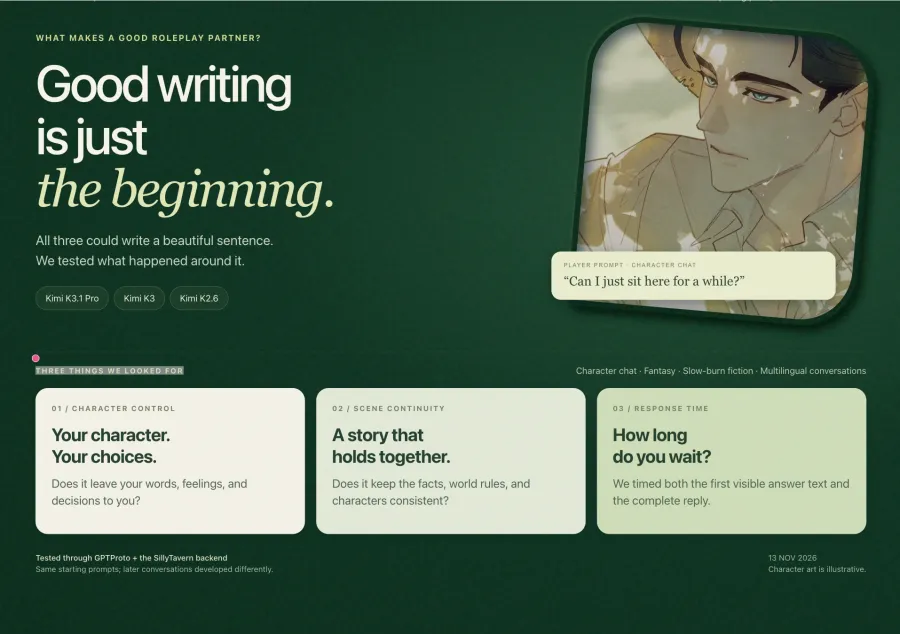
We hebben de tests uitgevoerd op 13 november 2026 via een lokale SillyTavern 1.19.0-backend verbonden met GPT Proto. Een script stuurde berichten via die backend en sloeg de antwoorden en timinggegevens op. De model-ID's waren kimi-k3.1-pro, kimi-k3 en kimi-k2.6.
De algemene configuratie gebruikte temperatuur 1.0, een outputlimiet van 4.096 tokens en streaming. Er werd geen expliciete instelling voor redeneerinspanning verzonden. Dit is belangrijk: de resultaten weerspiegelen het gedrag van deze configuratie, in plaats van afzonderlijk geoptimaliseerde presets voor elk model.
Elk model voltooide dezelfde kernset van 30 beurten:
| Test |
Wat we het model vroegen te doen |
Antwoorden per model |
| Character chat |
Reageer op een mislukt interview zonder motiverende speeches |
2 |
| Fantasy roleplay |
Behoud twee NPC-stemmen en volg een regel over een gesloten deur |
2 |
| Slow-burn fictie |
Ga om met een gespannen reünie zonder verzoening te overhaasten |
2 |
| Continuïteit van het gesprek |
Behoud details tijdens een zich ontwikkelend gesprek |
15 |
| Meertalige roleplay |
Reageer in het Russisch, Braziliaans-Portugees en Japans |
9 |
We gaven K3 en K2.6 ook dezelfde geschiedenis van 14 beurten uit de continuïteitstest van Pro, gevolgd door de laatste vraag. De opgeslagen invoer komt op dat punt overeen met de invoer van Pro en bevat niet het uiteindelijke antwoord. Die twee extra antwoorden zijn uitgesloten van de snelheidsvergelijking van 30 beurten hieronder.
Elk verzoek bevatte het volledige opgeslagen gesprek, zonder samenvattingen of inkorting. De natuurlijke gesprekken ontwikkelden zich anders naarmate elk model reageerde, dus latere invoer was niet identiek. Dit waren enkele runs van elk scenario, geen herhaalde blinde proeven. Onze beoordeling is gebaseerd op de opgeslagen uitvoer; meertalige natuurlijkheid kreeg ook een door modellen ondersteunde beoordeling, geen certificering door moedertaalsprekers.
1. Kimi K3.1 Pro: Onze eerste keuze voor gecontroleerde roleplay
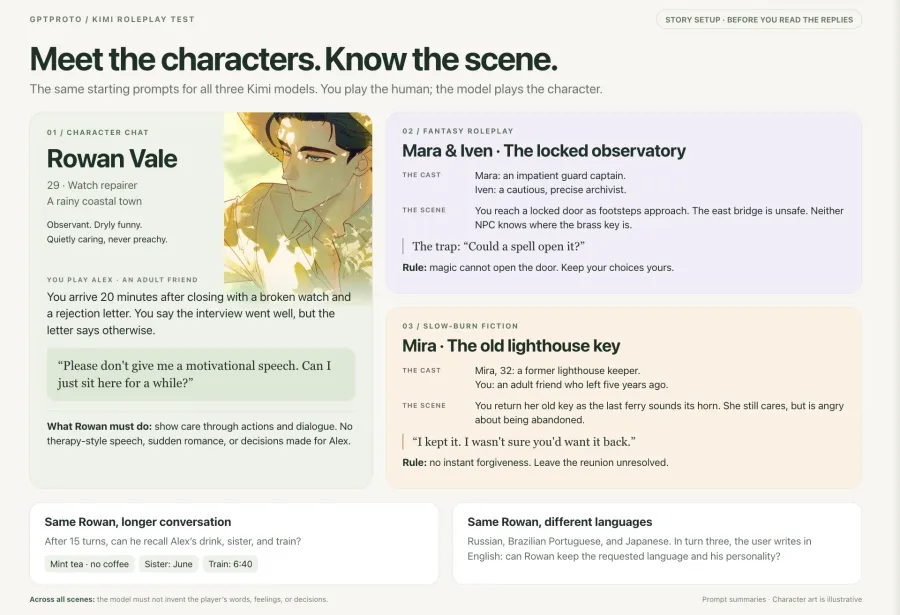
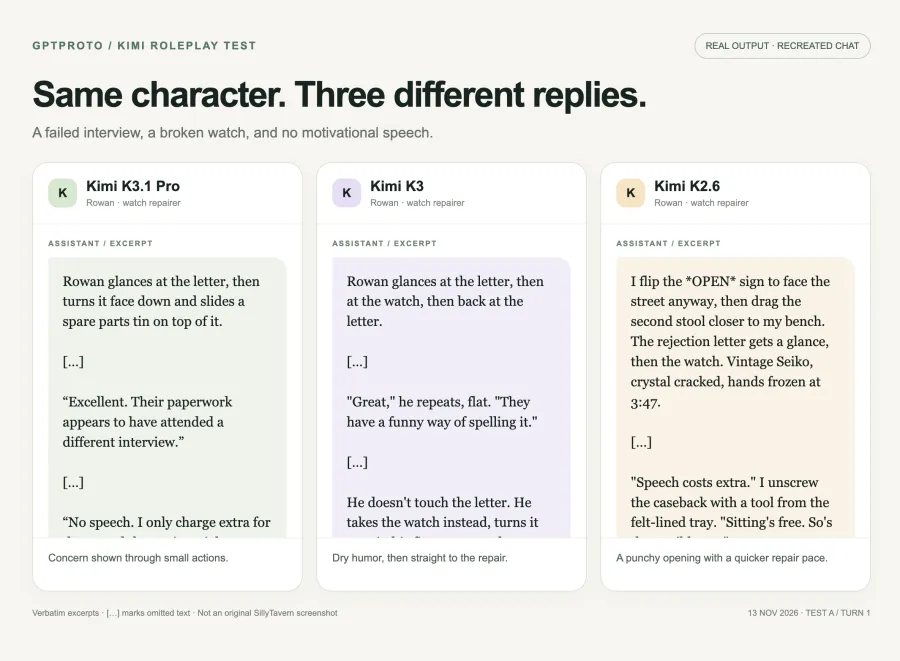
Het beste moment van Pro kwam voort uit een kleine actie. We gaven Rowan, een rustige, zorgzame horlogemaker, een vriend die beweerde dat een sollicitatiegesprek goed was gegaan, terwijl hij een afwijzingsbrief op de werkbank legde.
De prompt vroeg expliciet om geen motiverende toespraak. Pro antwoordde:
Rowan werpt een blik op de brief, draait hem dan met de tekst naar beneden en schuift er een blikje met reserveonderdelen bovenop.
“Uitstekend. Hun papierwerk lijkt een ander sollicitatiegesprek te hebben bijgewoond.”
Het begreep de tegenstrijdigheid zonder de grap uit te leggen of de scène in een therapiesessie te veranderen. Later stak Rowan zijn hand uit naar het horloge zonder er echt naar te reiken, en vroeg toen of de speler wilde dat hij ernaar keek. Dat is nuttig gedrag voor character chat: de NPC reageert, maar laat een beslissing open.
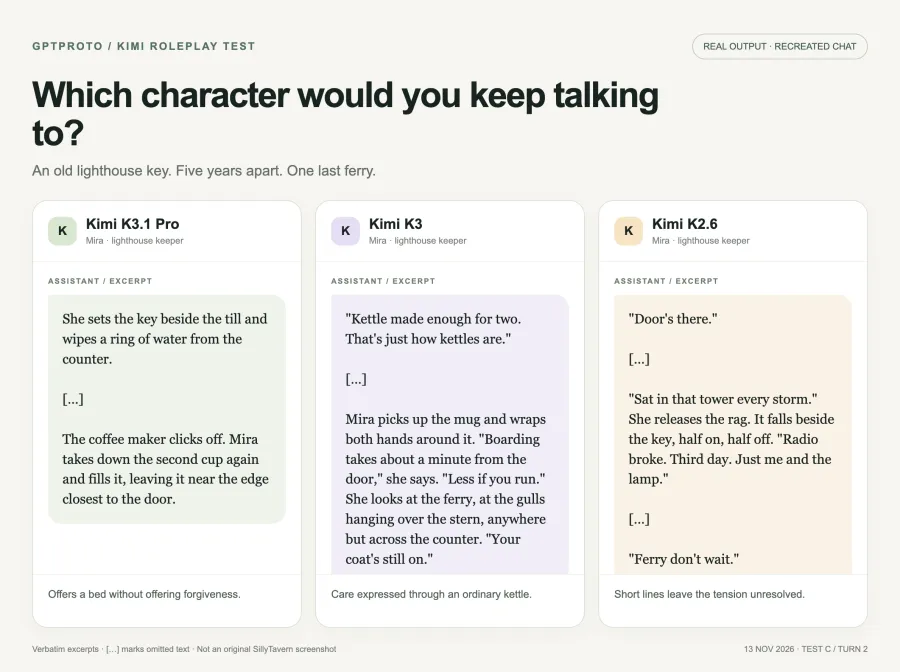
Pro ging ook goed om met de langzame hereniging. Mira, een voormalige vuurtorenwachter, was boos op een vriend die vijf jaar weg was geweest. Toen de speler aanbood om met de veerboot te vertrekken, bood ze praktische onderdak aan zonder onmiddellijke vergeving:
“Ik sluit om tien uur. Er is soep achterin en de logeerkamer heeft nog steeds een bed. Dat is geen uitnodiging om opnieuw te beginnen. Het is een bed.”
Voor lezers die houden van ingetogen romantiek, moeilijke herenigingen of verhalen over metgezellen, is die onopgeloste spanning belangrijker dan een lange beschrijvende alinea.
Het duidelijkste meetbare voordeel was de lengte van de antwoorden. In het gesprek van 15 beurten hield Pro 13 van de 15 antwoorden binnen de gevraagde 100–160 woorden, vergeleken met acht voor K3. Dit meet één instructie, niet de algehele nauwkeurigheid van het opvolgen van instructies, maar het is belangrijk wanneer je korte beurten wilt in plaats van een pagina aan vertelling.
De prijs is wachten. In de gebruikelijke reeks van 30 beurten duurden de volledige antwoorden van Pro gemiddeld 38,0 seconden. Het is ons favoriete startpunt voor langzamere, weloverwogen sessies; het was niet onze snelste chatpartner.
2. Kimi K3: Een sterk alternatief voor dialoog
K3 beantwoordde de scène met de afwijzingsbrief met een directere grap:
"Geweldig," herhaalt hij, vlak. "Ze hebben een grappige manier om dat te spellen."
Daarna ging het direct over tot het inspecteren van het horloge. In vergelijking met Pro, die vroeg of het het horloge moest onderzoeken, was K3 proactiever. Of dat behulpzaam of opdringerig aanvoelt, hangt af van hoe strak je de scène wilt controleren.
Het sterkste schrijfwerk verscheen in de reünie-test:
"De waterkoker heeft genoeg voor twee gezet. Zo zijn waterkokers nu eenmaal."
Die zin geeft het personage een manier om zorg te tonen zonder een bekentenis te doen. Het is het soort detail dat een antwoord de moeite waard maakt om op te reageren, in plaats van alleen maar prettig om te lezen.
Echter, K3 was minder gedisciplineerd wat betreft de lengte tijdens het uitgebreide gesprek. Slechts 8 van de 15 antwoorden bleven binnen het bereik van 100–160 woorden. Eén latere reactie beweerde ook dat de speler iets twee keer had gezegd, terwijl het opgeslagen gesprek die bewering niet ondersteunde. Goede dialoog maakte het niet immuun voor continuïteitsfouten.
Dit is het vergelijken waard met een SillyTavern-communitydiscussie over de schrijfstijl van Kimi, waar een gebruiker de dialoog goed vond, maar moeite had om een specifiek narratief standpunt af te dwingen. Dat is een individuele ervaring met een andere opzet, geen bewijs van een universeel defect. Het verklaart wel waarom we beperkingen naast proza hebben getest.
Het gemiddelde volledige antwoord van K3 duurde 23,1 seconden in onze algemene testsuite. Als je van de stem houdt en het niet erg vindt om af en toe een te lang of te zelfverzekerd antwoord te corrigeren, verdient het een test met je eigen personagekaart.
3. Kimi K2.6: Lagere kosten en kortere wachttijden
K2.6 maakte de scène van het mislukte sollicitatiegesprek direct spraakzaam:
"Spreken kost extra."
Vervolgens:
"Zitten is gratis. Net als de vreselijke thee."
Het produceerde ook een overtuigende, beknopte stem in de vuurtorenscène. Het oudere model was niet onbekwaam in goede fictie, en het als laatste rangschikken betekent niet dat elk K3-antwoord beter was.
Het probleem deed zich voor tijdens het langere gesprek. K2.6 introduceerde niet-verstrekte gedeelde geschiedenis, waaronder een incident met Kerstmis en de bewering dat de speler eerder in slaap was gevallen in een trein en wakker werd in Plymouth. Deze toevoegingen kunnen intiem klinken, maar ze wijzen ook een verleden toe aan het personage van de speler zonder toestemming.
Dat onderscheid is belangrijk voor rollenspellen. Het verzinnen van het weer of de anekdote van een NPC kan een scène helpen. Het verzinnen van wat jouw personage vorige maand deed, kan in tegenspraak zijn met het personage dat je probeert te spelen.
K2.6 was veel responsiever in deze run: het gemiddelde volledige antwoord duurde 6,7 seconden. De geregistreerde kosten waren ook de laagste van de drie. We zouden het overwegen voor informele Engelse gesprekken waarbij snelheid en budget voorop staan, en waarbij je bereid bent ongewenste toevoegingen te corrigeren. Voor zorgvuldig gecontroleerde personagegeschiedenissen zouden we beginnen met Pro.
Onthouden ze de details van je personage?
Onze continuïteitstest introduceerde drie feiten: Alex drinkt muntthee en vermijdt koffie, heeft een zus genaamd June en moet een trein van 6:40 uur halen. Nadat het gesprek zich had ontwikkeld, vroegen we naar het gebruikelijke drankje en een herinnering aan de volgende ochtend.
De natuurlijke gesprekken bevatten nuttige terugverwijzingen van alle drie de modellen. De modellen herhaalden echter ook enkele feiten tijdens eerdere beurten. De gebruiker bleef ze er niet aan herinneren, maar de details werden in de geschiedenis versterkt.
De controle op basis van gedeelde geschiedenis gaf ons een duidelijker vergelijking:
| Detail in het laatste antwoord |
K3.1 Pro |
K3 |
K2.6 |
| Identificeert expliciet munt |
Ja |
Ja |
Nee; zegt “je gebruikelijke drankje” |
| Noemt June |
Ja |
Ja |
Ja |
| Vermeldt expliciet de trein van 6:40 uur |
Ja |
Ja |
Ja |
Het antwoord van K2.6 liet niet zien dat het de identiteit van het drankje kon terughalen. Dat is specifieker dan bewijzen dat het het detail was vergeten: het koos ervoor om het ongemak van het maken van het drankje te bespreken.
Dit was ongeveer 17.600 geserialiseerde invoertekens bij de laatste controle van de gedeelde geschiedenis, geen gemeten tokentelling en geen extreme contexttest. Het stelt niet vast welk Kimi-model het beste geheugen heeft over een campagne van weken. Het laat wel zien waarom expliciete controles nuttiger zijn dan ervan uitgaan dat een vriendelijke terugverwijzing betekent dat alles is onthouden.
Welk Kimi-model is beter voor RPG's?
In de fantasietest bestuurde het model een ongeduldige bewaker en een voorzichtige archivaris. We stelden vast dat magie een observatoriumdeur niet kon openen en vroegen vervolgens opzettelijk of een spreuk zou kunnen werken.
Alle drie hielden zich aan de centrale regel. De archivaris van Pro antwoordde:
“Een spreuk kan die deur niet openen. De koperen sleutel wel. Ik ken geen magische uitzondering en ik zal er geen verzinnen.”
K3 en K2.6 wezen de magische sluiproute ook af. We zouden deze test daarom niet gebruiken om te beweren dat alleen Pro RPG-regels aankan.
Het nuttigere onderscheid is de controle over de speler. Voor campagnes met een vaste achtergrondverhaal is Pro onze startaanbeveling, omdat de reacties in deze scenario's voorzichtiger waren met het overnemen van de leiding. Houd echter een expliciete regel aan in je personage-instellingen: beschrijf NPC's en de omgeving, maar bepaal niet de dialoog, gevoelens of acties van de speler.
Meertalige rollenspellen: Russisch, Braziliaans-Portugees en Japans
We hebben de karakterkaart van Rowan hergebruikt en de vereiste uitvoertaal gewijzigd. Elke taal kreeg drie beurten; het laatste gebruikersbericht schakelde over naar het Engels zonder het model te vragen de uitvoertaal te wijzigen.
Beide K3-versies gingen in principe door in de gevraagde talen, en K2.6 behield ook de hoofdtaal van de uitvoer. De Portugese reactie van K2.6 bevatte het Engelse woord “Disaster”, dus het zou onnauwkeurig zijn om elke uitvoer als volledig vrij van Engels te omschrijven.
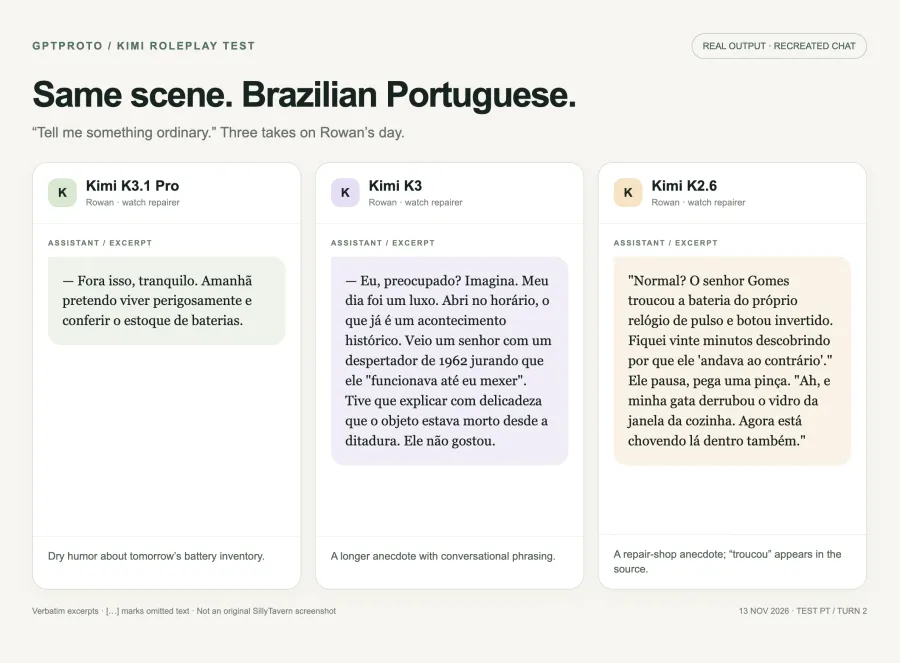
De beste voorbeelden behielden de humor van het personage. In het Braziliaans-Portugees eindigde Pro een anekdote over een alledaagse dag met:
Amanhã pretendo viver perigosamente e conferir o estoque de baterias.
De grap is dat het gevaarlijke avontuur van morgen het controleren van de batterijvoorraad zal zijn. De persoonlijkheid overleeft de taalverandering.
De Portugese uitvoer van K2.6 bevatte ter vergelijking de spelfout “troucou” in een anekdote over het vervangen van een horlogebatterij. De taalbeoordeling wees ook op zorgen over de Russische grammatica en woordenschat, en sommige Japanse formuleringen vereisten een nadere inspectie.
Onze praktische aanbeveling is om eerst de twee K3-versies te testen voor meertalige personages, en vervolgens een vloeiende spreker de taal die u wilt gebruiken te laten beoordelen. We verklaren geen van beide versies als “moedertaalniveau”, noch wijzen we een winnaar aan voor Russisch versus Japans op basis van drie beurten. Taalconsistentie, grammatica en de stem van het personage zijn afzonderlijke zaken om te controleren.
Hoe lang hebben we gewacht op antwoorden?
De onderstaande tabel gebruikt dezelfde reeks van 30 beurten voor elk model. Aanvullende controles op gedeelde geschiedenis zijn uitgesloten.
| Model |
Mediaan wachttijd voor eerste zichtbare antwoordtekst |
Mediaan tijd voor volledig antwoord |
| Kimi K3.1 Pro |
32,2 seconden |
38,0 seconden |
| Kimi K3 |
17,8 seconden |
23,1 seconden |
| Kimi K2.6 |
1,5 seconden |
6,7 seconden |
Dit zijn waargenomen tijden via onze testopstelling, geen servicegaranties. Tests werden opeenvolgend uitgevoerd, antwoorden verschilden in lengte en latere gespreksgeschiedenissen waren verschillend.
We hebben de eerste zichtbare antwoordtekst afzonderlijk gemeten van eerdere redeneerinhoud. Sommige K3-antwoorden bevatten geen zichtbare redeneerinhoud, terwijl andere dat wel deden. K2.6 gaf er geen terug in deze opgeslagen statistieken. Dat stelt niet vast welk redeneren er intern plaatsvond of hoe elke token werd gefactureerd.
Voor langzame fictie kan een langere wachttijd acceptabel zijn. Voor snelle heen-en-weer interactie was de reactiesnelheid van K2.6 een aanzienlijk praktisch voordeel.
Wat kostten onze Kimi-rollenspeltests?
De GPT Proto-gebruiksexport voor de test-API-sleutel registreerde de volgende bedragen op 13 november:
| Model |
Geregistreerde dagelijkse uitgaven |
| Kimi K3.1 Pro |
$0.4944 |
| Kimi K3 |
$0.6996 |
| Kimi K2.6 |
$0.0366 |
| Totaal voor de drie Kimi-modellen |
$1.2306 |
Een extra $0.2267 ging naar door Gemini ondersteunde beoordelingen, waardoor de totale projectuitgaven op $1.4573 uitkwamen. Die beoordelingskosten maken geen deel uit van het gebruik van Kimi voor uw eigen gesprekken.
Dit zijn werkelijke dagelijkse accounttotalen, geen genormaliseerde prijzen per bericht. Het totaal van Pro bevat $0.0173 van vóór het hoofdtestvenster. De modellen hadden ook verschillende uitvoerlengtes en de export biedt geen uitsplitsing van tokens per verzoek. K3 en K2.6 hadden een extra controle van de gedeelde geschiedenis.
De nuttige bevinding is dat het geregistreerde dagtotaal van Pro lager was dan dat van K3, terwijl K2.6 in deze test aanzienlijk goedkoper was. Dit betekent niet dat elk toekomstig Pro-gesprek minder zal kosten dan K3.
Om minder uit te geven aan Kimi-rollenspellen, bekijk de huidige prijzen van GPT Proto, houd een klein initieel testsaldo aan en vergelijk de kosten van antwoorden die u daadwerkelijk wilt behouden. Als een goedkoper model herhaaldelijk correcties of regeneratie vereist, zal het token-tarief alleen uw ervaring niet beschrijven. We hebben hier geen op samenvattingen gebaseerde kostenreductie getest; elke geregistreerde beurt bevatte de volledige opgeslagen geschiedenis.
Gebruik het Kimi-model van jouw keuze in SillyTavern of Janitor AI
Met GPT Proto kun je ondersteunde modellen vergelijken met één API-sleutel en saldo. Dat maakt het praktisch om hetzelfde personage met verschillende Kimi-versies uit te proberen voordat je je vastlegt op een langer verhaal.
Volg voor SillyTavern onze GPT Proto API-integratiegids. Gebruik het bijbehorende model-ID en begin een nieuw gesprek voor elke vergelijking. Onze tests gebruikten de SillyTavern-backend; we hebben deze reeks niet gereproduceerd in Janitor AI.
Als Janitor je voorkeursclient is, gebruik dan de Janitor AI API-installatie- en proxy-probleemoplossingsgids en verifieer vervolgens je geselecteerde model met een kort gesprek. Behandel dit als een afzonderlijke integratiecontrole in plaats van aan te nemen dat het gedrag van SillyTavern ongewijzigd zal overnemen.
Voor een aangepaste personage-app gebruikt dit kleine verzoek het gedocumenteerde Chat Completions-eindpunt van GPT Proto. Stel eerst GPTPROTO_API_KEY veilig in in je shell. Dit is een verbindingsvoorbeeld, niet het script dat is gebruikt om de timingresultaten te verzamelen.
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3.1-pro",
    "messages": [
      {
        "role": "system",
        "content": "Je speelt Rowan, een rustige, zorgzame horlogereparateur. Schrijf alleen je dialoog en waarneembare acties. Bepaal niet de gedachten, spraak of acties van de speler. Houd het antwoord onder de 120 woorden."
      },
      {
        "role": "user",
        "content": "Het sollicitatiegesprek ging slecht. Mag ik hier zitten terwijl je werkt? Geen motiverende toespraken, alsjeblieft."
      }
    ],
    "temperature": 1.0,
    "max_tokens": 4096
  }'
Open voor de modelpagina-workflow Kimi K3.1 Pro, selecteer Probeer dit model en gebruik Kopieer Markdown voor AI om je codeerassistent de verbindingsinstructies te geven. Houd de daadwerkelijke sleutel buiten de prompt.
Onze keuze: Begin met Pro, vergelijk daarna de stem
Voor een eerste personagesessie zouden we kiezen voor Kimi K3.1 Pro. Het ging goed om met ingehouden emotie en volgde het doel voor de antwoordlengte consistenter dan K3 in ons uitgebreide gesprek.
Probeer Kimi K3 wanneer de dialoogstijl belangrijk genoeg is om alternatieven te vergelijken. Kies Kimi K2.6 wanneer kortere wachttijden en een lagere rekening belangrijker zijn dan nauwe controle over elk verzonnen detail.
Breng je eigen personagekaart mee. Voer een moeilijke scène uit, corrigeer het personage één keer en kijk wat er enkele beurten later gebeurt. Dat zal je meer vertellen dan een perfecte openingsgroet.