Overzicht van Qwen 4 Max: Van de "Qoduck" blindtest tot de 14-daagse preview
Als je een praktisch overzicht van Qwen 4 Max wilt, begin dan bij de vier dagen voordat de naam openbaar werd. Tussen 7 november en 10 november 2026 verscheen een anoniem model met de codenaam Qoduck in Qoder, een agent-gebaseerde programmeer-IDE. Ontwikkelaars die Qoduck testten, merkten een ongebruikelijk patroon op: in plaats van een snelle code-snippet in één keer terug te geven en te wachten op menselijke feedback, besteedde het model tien tot vijftien minuten aan het opstarten van shell-checks, het vanaf nul schrijven van aangepaste SVG-assets en het uitvoeren van unit-tests op zijn eigen diffs voordat het een definitief antwoord gaf.
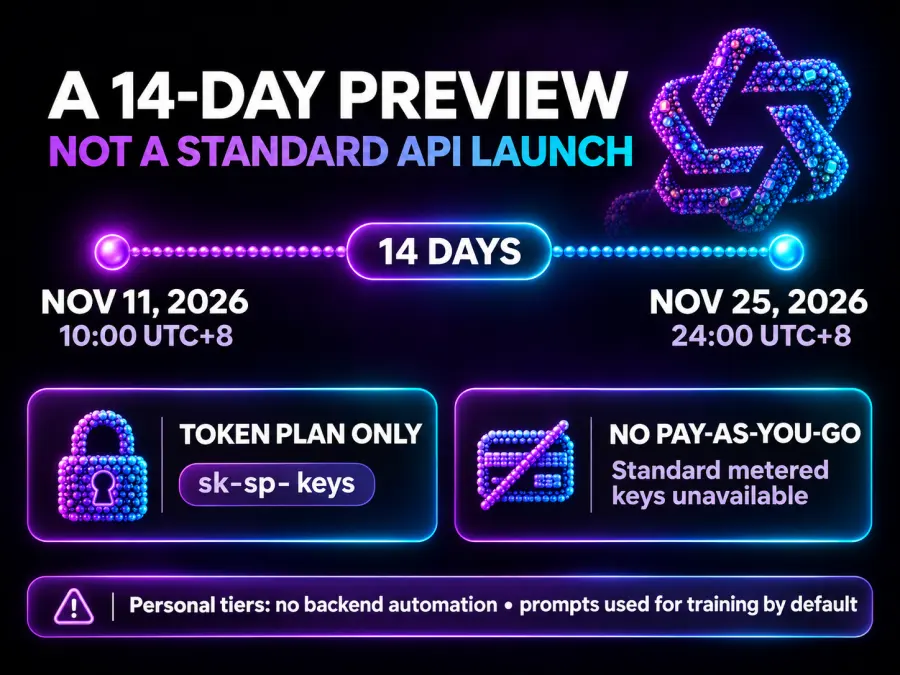
Op 11 november 2026 om 10:00 UTC+8 bevestigde Alibaba dat Qoduck het nieuwste Qwen-model was, Qwen 4 Max, en stelde het beschikbaar in Alibaba Cloud Model Studio onder de modelnaam qwen4-max-preview (verwezen als qwen4.0-max-preview in bepaalde clientconfiguraties). In plaats van een volledige commerciële lancering met lijstprijzen per token te organiseren, kaderde Alibaba de uitrol—vaak beschreven in ontwikkelaarsdocumentatie als de introductie van Qwen 4 Max via een 14-daagse Qwen 4 Max-preview—als een manier om agent-gebaseerde workflows in ontwikkelaarstools zoals Claude Code, Cursor, Cline en Qoder te stresstesten.
| Specificaties |
Bevestigde status (qwen4-max-preview) |
Bron / Technische opmerking |
| Officieel model-ID |
qwen4-max-preview |
Alibaba Cloud Model Studio / Bailian-documentatie |
| Preview-periode |
11 nov 2026 (10:00) – 25 nov 2026 (24:00 UTC+8) |
Strikte 14-daagse beperkte preview |
| Contextvenster |
1.000.000 tokens (max. invoer: 967.000 tokens) |
Geverifieerd via CN- en internationale documentatie |
| Max. output-tokens |
393.216 totaal (131.072 definitieve output + 262.144 redenering) |
max_tokens omvat zowel denken als output |
| Invoer- / uitvoermodaliteiten |
Invoer: Tekst, Afbeelding, Video · Uitvoer: Tekst |
Geen native audio-invoer in de preview-route |
| Redeneercontrole |
reasoning_effort: low, medium, xhigh |
Denken standaard AAN; standaard ingesteld op xhigh |
| Ondersteunde API-protocollen |
OpenAI Chat Completions, Responses API, Anthropic Messages |
Vereist een toegewezen sk-sp- Token Plan-eindpunt |
| Parametergrootte & gewichten |
Niet bekendgemaakt (Gesloten commerciële preview) |
2.4T / 95B-cijfers online behoren tot Qwen3.8-Max |
| Officiële benchmarktabel |
Niet gepubliceerd bij de preview-lancering |
De circulerende 49.9 GameFeel-score is Qwen-4-Flash-Early |
Het begrijpen van qwen 4 max uitgelegd als een generatiesprong komt neer op hoe het rekenkracht besteedt tijdens de inferentiefase. Waar eerdere releases tool-aanroepen als een optionele hulp zagen, bouwt de kern van de qwen 4 max-upgrade een zelfverificatie-loop in het standaard redeneertraject. Wanneer het model wordt gevraagd om een webapplicatie te bouwen of een opdrachtregel-utility te patchen, koppelt het routinematig tientallen tool-aanroepen aan elkaar—het inspecteren van mappenstructuren, het uitvoeren van pytest of lokale headless browsers, het opvangen van eigen syntax- of lay-outfouten en het herschrijven van de defecte regels voordat de gebruiker de output ooit ziet.
Architectuur, modelgrootte en de realiteit van benchmarks
Twee vormen van desinformatie domineren momenteel de zoekresultaten voor qwen 4 max size en qwen 4 max benchmark. Deze ophelderen is de snelste manier om te begrijpen wat Alibaba daadwerkelijk heeft uitgebracht en wat nog niet bekend is gemaakt.
Ten eerste heeft Alibaba het totale of actieve aantal parameters voor alibaba qwen 4 max niet bekendgemaakt. Verschillende externe blogs vermelden het als een Mixture-of-Experts (MoE)-model met 2,4 biljoen parameters en 95 miljard actieve parameters per token. Die exacte cijfers horen bij het vorige vlaggenschip, Qwen3.8-Max, dat in september 2026 werd uitgebracht. Hoewel Qwen 4 Max vrijwel zeker een sparse MoE-backbone gebruikt om economisch een contextvenster van 1 miljoen tokens te bedienen, is elk specifiek cijfer in biljoenen parameters dat je in november 2026 leest, een onbevestigde overblijfsel uit de 3.8-generatie.
Wat we wel weten over de architectuur komt uit de technische release van augustus 2026 van Qwen3.8-Flash-Next door Alibaba, die het Qwen-team expliciet aanwees als een testomgeving om de belangrijkste architecturale upgrades voor de Qwen 4-serie te valideren. Dat voorlopige rapport documenteerde vier structurele wijzigingen die verklaren hoe qwen4-max-preview omgaat met workloads van een miljoen tokens:
Hybride GDN + QSA Attention: Het combineren van Gated DeltaNet (GDN) lineaire attention-lagen met Qwen Sparse Attention (QSA) verkort de prefill-latentie van de tijd-tot-eerste-token (TTFT) bij een context van 1.000.000 tokens met maximaal 7,6x in vergelijking met standaard full attention.
4-Stream Gated Residual Connections: Het uitbreiden van de breedte van de residual stream met geleerde gates verbetert de gradiëntstroom en de routing van kenmerken tussen lagen tijdens diepgaande redeneringen in meerdere stappen.
N-gram Embedding Layers: Het direct injecteren van lokale context met meerdere tokens in de embedding-fase ontlast de vroege attention-blokken van lexicale patroonherkenning.
Muon Optimizer Training: Het overschakelen van grootschalige pretraining-optimalisatie naar Muon verbeterde de sample-efficiëntie op corpora van code en formele logica.
Ten tweede, als je zoekt naar qwen 4 max benchmark resultaten, zul je waarschijnlijk beweringen tegenkomen dat Qwen 4 Max 49,9 scoorde op GameFeel Bench v1.4, waarmee het Claude Opus 5.5 met 47,2 nipt versloeg. Ik heb het klassement en de onderliggende commit-logs gecontroleerd: die score van 49,9 werd geregistreerd door een vroege, lichtgewicht test-checkpoint genaamd Qwen-4-Flash-Early (interne codenaam hawk), niet qwen4-max-preview. Per 13 november 2026 heeft Alibaba geen officiële MMLU-Pro, SWE-bench Verified of AIME klassementstabel gepubliceerd voor Qwen 4 Max.
Wat je op dit moment wel kunt verifiëren, is de werking van het qwen 4 max contextvenster en het outputbudget ervan—en dit is waar migrerende ontwikkelaars tegen een muur aanlopen. Hoewel het contextvenster 1.000.000 tokens bevat (met een gedocumenteerd prompt-plafond van 967.000 tokens), staat de maximale output op het internationale portaal vermeld als 393.216 tokens, en op het binnenlandse portaal uitgesplitst als 262.144 redeneertokens plus 131.072 tokens voor het definitieve antwoord.
Dit is het addertje onder het gras: de max_tokens API-parameter in qwen4-max-preview bepaalt de sum van reasoning_content en content. Omdat het model standaard is ingesteld op reasoning_effort: "xhigh" (de hoogste van drie beschikbare instellingen: low, medium en xhigh), kan een complexe programmeer-prompt gemakkelijk 15.000 tot 40.000 tokens verbruiken in het verborgen denkblok. Als uw bestaande clientcode max_tokens: 4096 of 8192 doorgeeft, zal het model zijn volledige limiet halverwege het denkproces bereiken en een lege content string retourneren. Om stille afkapping te voorkomen, verhoogt u max_tokens tot boven de 65.536 of verlaagt u expliciet de reasoning_effort naar medium voor routinetaken.
Praktische Qwen 4 Max-review: Wat tests van de community en media daadwerkelijk aantonen
Omdat Alibaba geen traditioneel persbericht met benchmarks uitbracht, zijn de meest betrouwbare gegevens uit een qwen 4 max-review afkomstig van engineeringteams die qwen4-max-preview tijdens de eerste 48 uur van de preview in live agent-harnassen hebben gekoppeld. Hun logs laten een duidelijk patroon zien: elke sprong in outputkwaliteit gaat gepaard met een merkbare latentie en hogere tokencosten.
Op 11 november publiceerde het Japanse AI-adviesbureau WEEL een driedelige evaluatie waarin het preview-model werd getest op het gebied van frontend-synthese, onderzoek uit meerdere bronnen en debugging op repository-niveau binnen Claude Code:
908-regelige aangepaste SVG-landingspagina (vs Qwen 3.8 Max): Bij een identieke prompt om een responsive landingspagina te bouwen voor een fysiotherapiepraktijk met een bosthema, was Qwen3.8-Max in ongeveer 9,5 minuut klaar, maar haalde het willekeurige externe stockfoto's op die het grid braken of niet konden worden geladen. qwen4-max-preview deed er ongeveer 17 minuten over—bijna twee keer zo lang. In plaats van kwetsbare externe URL's te koppelen, riep het tientallen keren op de achtergrond de Code Interpreter aan om programmatisch aangepaste SVG-illustraties van boomkruinen, de architectuur van de kliniek en personeelsiconen te tekenen, wat resulteerde in een HTML-bestand van 908 regels zonder kapotte assets.
Autonome CLI-debugging in Claude Code (36/36 tests geslaagd): WEEL richtte Claude Code (aangedreven door qwen4-max-preview via het Anthropic-compatibele eindpunt) op een lokale Python-CLI voor huishoudelijke boekhouding (kakeibo) en vroeg het om --export-csv en --month filter-flags toe te voegen met unit tests. De uitvoering duurde 11 minuten en 48 seconden. Na het schrijven van de initiële implementatie voerde het model pytest uit, ontdekte 2 falende tests—waaronder een edge case waarbij een negatieve valutastring zoals -100日元 door Python's argparse werd geïnterpreteerd als een command-line flag—en patchte de parser zelfstandig. Zonder daarom gevraagd te worden, voegde het ook een utf-8-sig BOM-header toe zodat Japanse karakters niet onleesbaar zouden worden in Microsoft Excel, en ontsnapte het aan leidende =, +, - en @ karakters om CSV-formule-injectie te blokkeren. Alle 36 tests slaagden, waarbij slechts 0,4% van het maandelijkse Lite-planquotum werd verbruikt.
Zelf-geverifieerd beleidsonderzoek: Met de taak om een vergelijkingstabel voor Japanse MKB-subsidies voor 2026 samen te stellen, besteedde het model 2 minuten aan het uitvoeren van meer dan een dozijn webquery's via ministeriële portalen en nog eens 5 minuten aan het uitvoeren van grep en Python-validatiescripts om te verifiëren dat er geen kolommen in de Markdown-tabel waren verschoven voordat het resultaat van 8 minuten werd gepresenteerd.
Twee dagen later, op 13 november, voerde de Chinese techpublicatie Silicon Star (GuiXingRen) een visuele en 3D-engineeringtest uit tegen qwen4-max-preview. Toen het model werd gevraagd om de klassieke SVG-animatie van een "pelikaan op een fiets" te genereren, articuleerde het de trapbeweging en de parallax-schaduwen van bomen, terwijl het uit zichzelf een snelheidsregelaar van 0,5x–1,75x en een dag/schemering/nacht-themawisselaar toevoegde. In een moeilijkere Three.js-test—het bouwen van een speelbaar 3D-spel met papieren vliegtuigjes genaamd Paper Skies waarbij het vliegtuig door een slaapkamerraam naar een tuin vliegt—merkten recensenten op dat de physics en obstakelafhandeling overeenkwamen met de creatieve Claude Fable 5.1 van Anthropic, hoewel het nog steeds achterbleef bij de nieuwere Claude Fable 5.2 wat betreft shader-afwerking. Toen het model werd gevraagd om de eigen responsive homepage van Silicon Star opnieuw te ontwerpen, startte het een lokale browser, merkte op dat externe artikel-thumbnails 403-hotlinkfouten gaven, verving deze automatisch door gestileerde SVG-gradiënt-placeholders en voltooide in 5 minuten een tweede ronde van redactionele lay-outrevisies.
Ontwikkelaarsfeedback op X (voorheen Twitter) en Japanse ontwikkelaarsforums voegt belangrijke nuances toe aan elk qwen 4 max-kenmerk-hoogtepunt. Ontwikkelaar @round_boys demonstreerde hoe het model een volledige 3D-scène rendert met Java en Three.js in één keer, maar merkte op dat de uitvoering ongeveer 69.000 tokens verbruikte. Andere vroege gebruikers die de ruwe doorvoer maten, rapporteerden streamingsnelheden van rond de 33 tokens per seconde onder de standaard xhigh-instelling, en merkten op dat de trajecten voor tool-gebruik via reinforcement learning (RL) soms te lang stilstaan bij eenvoudige bestandlezingen—een herinnering dat het -preview-achtervoegsel letterlijk moet worden genomen.
Qwen 4 Max prijzen, Token Plan-regels en productieblokkades
Als je zoekt naar qwen 4 max pricing in de verwachting een standaard "$X per miljoen input-tokens" tabel te vinden, dan zul je die niet vinden. Alibaba biedt geen gemeten pay-as-you-go facturering voor qwen4-max-preview. De enige manier om verzoeken te verzenden is via een actief Alibaba Cloud Model Studio Token Plan abonnement (voorheen het Coding Plan genoemd), dat factureert in abstracte maandelijkse "Credits" in plaats van in ruwe dollars per token.
Op het internationale QwenCloud-portaal is het Token Plan opgesplitst in persoonlijke en team-niveaus:
Lite Plan (3 voor de eerste maand voor nieuwe gebruikers): Inclusief 20.000 Credits per maand, beheerd door een strikte doorlopende limiet van 1.200 Credits per venster van 5 uur en 9.000 Credits per week.
Pro Plan (15 voor de eerste maand): Inclusief 100.000 Credits per maand, met een limiet van 6.000 Credits per venster van 5 uur en 45.000 Credits per week. (Op het binnenlandse Chinese portaal van Alibaba staan Lite en Pro genoteerd voor 39 RMB en 199 RMB per maand, met promoties van de halve prijs voor de eerste maand op 19,5 RMB en 99,5 RMB.)
14-daagse preview-korting (11 nov – 25 nov 2026): Tijdens het preview-venster van twee weken verbruiken oproepen overdag (08:00–22:00 UTC+8) slechts 20% van het standaard Credit-gewicht, terwijl oproepen buiten de piekuren 's nachts (22:00–08:00 UTC+8) daarbovenop een extra korting van 80% ontvangen—waardoor het effectieve Credit-verbruik daalt tot slechts 4% van de normale tarieven.
Voor een individuele ontwikkelaar die 's nachts in een IDE knutselt voor $3, is die promotionele rekensom moeilijk te verslaan. Voor een engineeringteam dat een product bouwt of geautomatiseerde CI/CD-agents draait, introduceert het Token Plan echter drie harde productieblokkades:
Verbod op backend-automatisering en API-integratie: De voorwaarden van het Alibaba Token Plan beperken persoonlijke Lite- en Pro-sleutels (sk-sp-) expliciet tot door mensen geactiveerde, interactieve codering binnen ondersteunde IDE-plug-ins. Het gebruik van een abonnementssleutel om een geautomatiseerd backend-script, een klantgerichte SaaS-functie of een batch-datapijplijn aan te sturen, schendt de servicevoorwaarden en leidt tot schorsing van het account.
Verplichte datatraining op persoonlijke niveaus: Volgens de regels van het Token Plan schrijven persoonlijke Lite- en Pro-abonnementen standaard alle prompts, repository-context en modelvoltooiingen in voor het modeltrainingsverbeteringsprogramma van Alibaba—en er is geen schakelaar om je af te melden. Alleen het zakelijke Team Plan ($40 per seat/maand) biedt een garantie voor nul dataretentie / geen training.
Doorlopende limieten van 5 uur en de stopzetting op 25 november: Zelfs als je workflow puur intern is, kan een doorlopend plafond van 1.200 Credits per 5 uur geen pieken van meerdere ontwikkelaars opvangen, en het qwen4-max-preview eindpunt wordt gepland om te sluiten op 25 november 2026 om 24:00 UTC+8.
Directe vergelijkingen: Qwen 4 Max vs Qwen 3.8 Max, Kimi K3.1 Pro, GLM-5.3 en Claude Opus 5.5
Omdat je qwen4-max-preview momenteel niet in een productie-backend kunt integreren, is de praktische vraag achter elke vergelijking welk pay-as-you-go vlaggenschip dezelfde agentische workload van 1M context aankan zonder vast te zitten aan een abonnement of blootstelling aan datatraining.
| Model |
Facturering & Beschikbaarheid |
Contextvenster |
Maximale output |
Ondersteunde invoermodaliteiten |
GPT Proto Metered Rate (Input / Output per 1M) |
Qwen4-Max-Preview (qwen4-max-preview) |
Alleen 14-daagse preview (eindigt 25 nov); Token Plan-abonnement ($6–$30/maand) |
1.000.000 |
393.216 (incl. 262K CoT) |
Tekst, Afbeelding, Video |
Niet gehost (geen metered upstream API) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
Productie Pay-As-You-Go |
1.000.000 |
65.536+ |
Tekst, Afbeelding, Video, Audio, Document |
4,20 (30% onder officiële lijstprijs) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
Productie Pay-As-You-Go |
1.048.576 (1,05M) |
131.072 |
Tekst, Afbeelding, Document |
10,00 ($0,20 gecachte input) |
GLM-5.3 (glm-5.3) |
Productie Pay-As-You-Go |
1.050.000 (1,05M) |
128.000 |
Tekst, Afbeelding, Document |
3,74 (15% onder officiële lijstprijs) |
Claude Opus 5.5 (claude-opus-5-5) |
Productie Pay-As-You-Go |
1.000.000 |
128.000 |
Tekst, Afbeelding, Document |
18,00 (10% onder officiële lijstprijs) |
Qwen 4 Max vs Qwen 3.8 Max
Bij het evalueren van qwen 4 max vs qwen 3.8 max, is de afweging die tussen autonome verificatietijd versus productiestabiliteit en bredere ondersteuning voor modaliteiten. Zoals de landingpage-test van 17 minuten versus 9,5 minuut van WEEL aantoonde, is Qwen 4 Max bereid om dubbel zoveel tijd te besteden aan het uitvoeren van Python-checks op de achtergrond en het synthetiseren van aangepaste SVG's. Echter, qwen4-max-preview laat native audio- en documentbestand-parsing vallen in zijn preview-route en kan niet per token worden aangeroepen.
Als je pipeline al afhankelijk is van Alibaba's prompt-opmaak, meertalige tokenisatie of multimodale visie, dan is qwen3.8-max-0902 het productieklare vlaggenschip om vandaag vast te leggen. Het biedt hetzelfde contextvenster van 1.000.000 tokens en accepteert invoer van tekst, afbeeldingen, video, audio en documenten. Op GPT Proto draait qwen3.8-max-0902 tegen 4,20 per 1M output-tokens—30% onder de officiële metered lijstprijs van Alibaba—en je kunt het vergelijken met kleinere open-weight varianten in de Qwen model hub.
Qwen 4 Max vs Kimi K3.1 Pro
De qwen 4 max vs kimi k3.1 pro vergelijking werd rechtstreeks getest in de Blender MCP- en WebGL-benchmarks van Silicon Star op 13 november, en het verschil tussen de twee modellen is opmerkelijk duidelijk: Qwen 4 Max denkt als een structureel werktuigbouwkundig ingenieur, terwijl Kimi K3.1 Pro denkt als een industrieel ontwerper.
In de Blender-prompt ("Jupiter Orbital Megaship Maintenance Dock") en de WebGL deep-sea gate test ("Gate of Ten Thousand Tides") bouwde qwen4-max-preview dichtere interne dragende ribben, complexe dokarmen en een werkende UI-schuifregelaar voor het getijdenniveau die dynamisch de waterhoogte en drukwaarden herrekende. Toch gaven reviewers kimi-k3.1-pro consistent hogere scores voor visuele compositie, water-shader belichting en kleurharmonie. Als u vandaag de dag gebruikersgerichte frontends, interactieve 3D-webervaringen of document-agents met een lange context bouwt die een contextvenster van 1.048.576 tokens (1,05M) en 131.072 maximale output-tokens nodig hebben, is Kimi K3.1 Pro beschikbaar op GPT Proto voor 10,00 per 1M output (waarbij gecachte input daalt naar $0,20 per 1M).
Qwen 4 Max vs GLM-5.3
Ontwikkelaars die zoeken naar qwen 4 max vs glm5.3 zijn meestal op zoek naar efficiëntie in codering en tool-gebruik op grote schaal tegen een scherpe prijs. Hoewel de Lite-promotie van $3 voor de eerste maand van Qwen 4 Max er op papier goedkoop uitziet, maken de doorlopende kredietlimiet van 5 uur en het verbod op geautomatiseerde scripts het onbruikbaar voor vloten van achtergrond-agents.
Z.ai's glm-5.3 lost dat exacte probleem op via een gemeten API. Het overtreft Qwen 4 Max zelfs licht in totale contextcapaciteit—met een 1,05M contextvenster gecombineerd met een 128K output-plafond—en accepteert tekst-, afbeeldings- en document-inputs. Met 3,74 per 1M output-tokens op GPT Proto (15% onder het officiële tarief van Z.ai), is GLM-5.3 het meest kosteneffectieve pay-as-you-go werkpaard voor geautomatiseerde PR-reviewbots, tool-routing met hoge gelijktijdigheid en het genereren van code voor meerdere bestanden.
Qwen 4 Max vs Claude Opus 5.5
Alibaba heeft native Anthropic Messages API-compatibiliteit ingebouwd in qwen4-max-preview om specifiek ontwikkelaars aan te trekken die kijken naar qwen 4 max vs claude opus 5.5 binnen Claude Code. Zoals de Python CLI-test van WEEL bewees, kan Qwen 4 Max al een 12 minuten durende pytest reparatielus uitvoeren en subtiele argparse en CSV-injectiefouten opsporen.
Waar claude-opus-5-5 een beslissende voorsprong behoudt, is in traject-efficiëntie, streaming-responsiviteit en betrouwbaarheid van de productie-SLA. Community-testers merkten op dat de RL-tuning in een vroeg stadium van Qwen 4 Max ertoe kan leiden dat het redundante shell-checks doorloopt met ~33 tokens/s onder xhigh redenering. Wanneer u bedrijfskritieke productierepository's refactort waar verspilde tool-beurten of training op persoonlijke data onacceptabel zijn, levert Claude Opus 5.5 een contextvenster van 1M en 128K maximale output met volwassen instructie-opvolging. Via GPT Proto kunt u claude-opus-5-5 aanroepen voor 18,00 per 1M output—10% onder de officiële Anthropic-prijzen.
Hoe je productie-alternatieven aanroept via een Unified API
Als je de vier bovenstaande productie-flagships wilt draaien zonder afzonderlijke vendor-SDK's, abonnementskredietvensters of sk-sp- regionale eindpunten te beheren, stelt GPT Proto ze allemaal beschikbaar achter één OpenAI-compatibele route (https://gptproto.com/v1/chat/completions).
Eén authenticatiedetail dat het vermelden waard is voordat je het fragment kopieert: zoals gedocumenteerd in onze authenticatiegids en quickstart-pagina, moet je je sleutel altijd doorgeven in de Authorization header met het Bearer voorvoegsel (Authorization: Bearer $GPTPROTO_API_KEY). Hieronder staat een op documentatie gebaseerd voorbeeld dat laat zien hoe je qwen3.8-max-0902 aanroept en direct overschakelt naar glm-5.3, kimi-k3.1-pro of claude-opus-5-5 door één string te wijzigen:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Audit deze Python CLI-parser op botsingen met negatieve getallen-vlaggen en risico's op CSV-formule-injectie."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# Wissel model-ID vrijelijk uit tussen productie 1M-context flagships:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Audit deze Python CLI-parser op botsingen met negatieve getallen-vlaggen en risico's op CSV-formule-injectie.",
        }
    ],
)

print(response.choices[0].message.content)