Cara Kami Memeringkat Model untuk SillyTavern
Bukti utamanya adalah September 2026 AI Roleplay Bench, yang menguji 14 model resmi di 10 kategori dan menilai 840 balasan. Kategorinya mencakup obrolan pendamping, perilaku Game Master, suara karakter yang ketat, penjahat, ketahanan, tema dewasa, dan batasan keamanan. Kimi K3, GLM-5.3, dan DeepSeek V4.1 Flash memiliki selisih kurang dari dua poin, sehingga tolok ukur itu sendiri menyarankan untuk menganggapnya sebagai hasil seri yang efektif daripada memperlakukan angka desimal sebagai kemenangan yang menentukan.
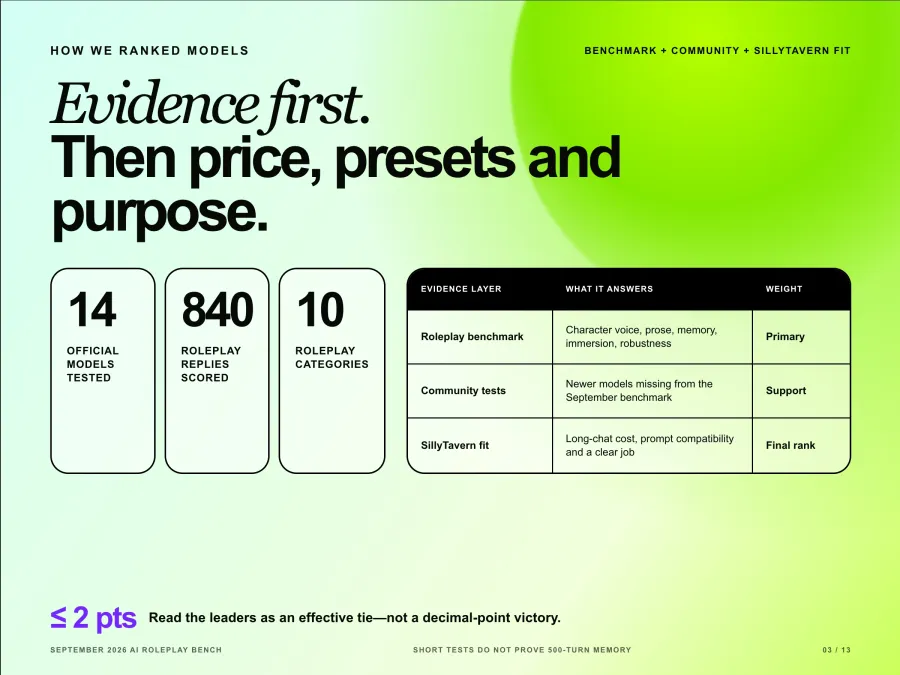
Tolok ukur ini juga memiliki batasan. Metodologi yang diterbitkan menggunakan skenario multi-giliran yang singkat, tidak mengukur penyimpangan selama ratusan pesan, dan tidak menyertakan fine-tune komunitas. Rilis yang lebih baru seperti Gemini 4 Argon juga hadir setelah pengujian tersebut. Untuk model-model tersebut, saya menggunakan perbandingan komunitas sebagai bukti pendukung dan menandai rekomendasi tersebut sebagai kurang pasti.
Peringkat akhir menambahkan tiga faktor khusus SillyTavern:
Ekonomi obrolan panjang. Token input biasanya mendominasi giliran berikutnya karena SillyTavern mengirimkan kartu karakter, instruksi, pengetahuan yang relevan, dan riwayat percakapan lagi.
Kompatibilitas prompt dan preset. Chat Completion, Text Completion, templat instruksi, sampler, dan kontrol penalaran tidak dapat dipertukarkan.
Pekerjaan yang jelas untuk setiap model. Model yang lebih murah mendapatkan tempat hanya jika memiliki peran yang berguna, bukan sekadar karena harganya yang rendah.
8 Model AI Terbaik untuk Roleplay SillyTavern
1 Kimi K3 Model SillyTavern Terbaik Secara Keseluruhan
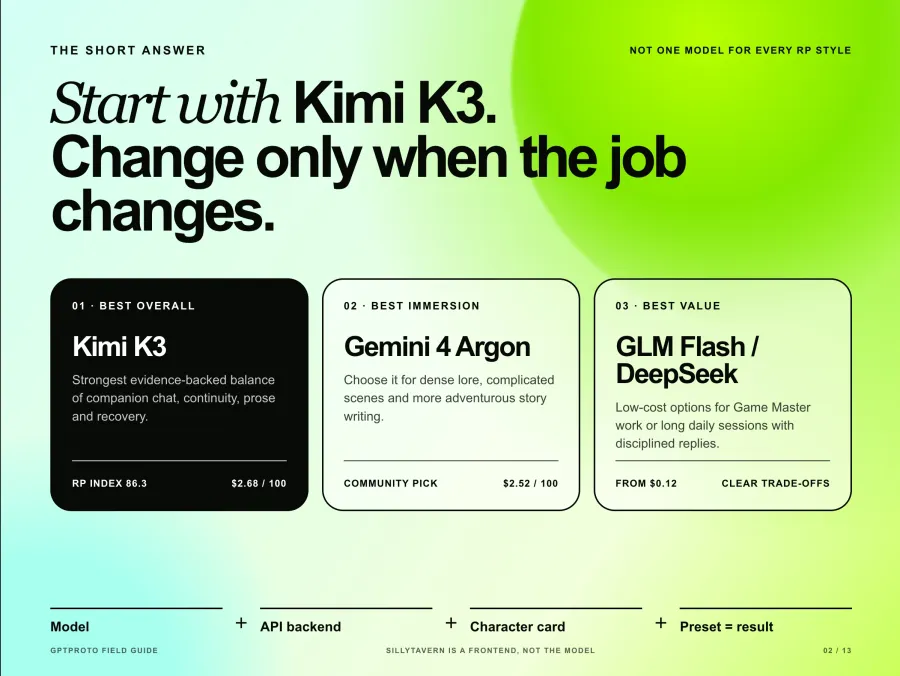
Kimi K3 adalah pilihan pertama yang paling aman jika Anda belum mengetahui gaya roleplay mana yang Anda sukai. Model ini mencetak 86,3 secara keseluruhan, 90,0 untuk Pendamping, dan 88,3 untuk Ketahanan dalam tolok ukur roleplay. Model ini juga memimpin penilaian tolok ukur untuk karakter, prosa, memori, dan imersi.
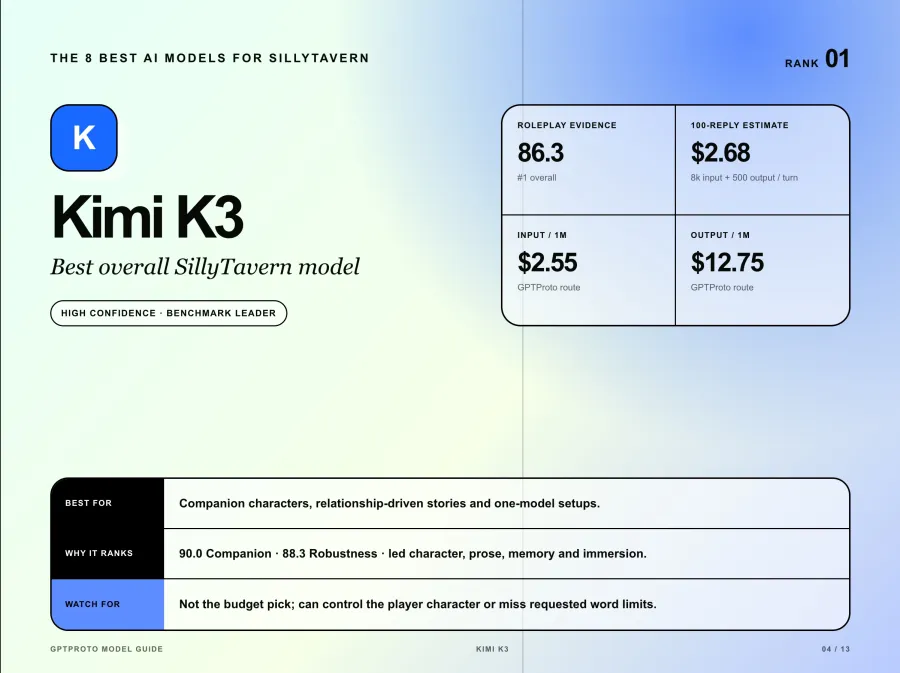
Keseimbangan itu lebih penting di SillyTavern daripada satu balasan yang mencolok. Kimi menangani pesan pengguna satu kata, mengingat detail yang ditanamkan, dan menjaga karakter tetap aktif alih-alih berubah menjadi asisten umum. Kelemahannya konkret: terkadang ia mengendalikan karakter pemain sebagai Game Master dan melewatkan batasan kata yang diminta.
Kesesuaian terbaik: karakter pendamping, cerita yang didorong oleh hubungan, dan pengguna yang menginginkan satu model untuk beberapa gaya RP. Titik awal SillyTavern: gunakan Chat Completion, ID model kimi-k3 yang tepat, dan panjang respons sedang sebelum menambahkan aturan preset yang lebih kompleks. Dengan harga $2,55 input dan $12,75 output per juta token, ini bukan pilihan yang hemat anggaran.
2 Gemini 4 Argon Terbaik untuk Roleplay yang Imersif
Gemini 4 Argon adalah favorit komunitas terbaru yang paling kuat untuk lore yang padat, adegan yang rumit, dan penulisan cerita panjang. Pengguna SillyTavern memuji presisinya dengan prompt besar dan kemampuannya untuk menambahkan detail adegan yang berguna alih-alih hanya memparafrase kartu karakter. Satu diskusi komunitas yang mendetail tentang penggunaan cerita panjang menggambarkan peningkatan yang jelas setelah cerita yang sama terasa membosankan di model lain.
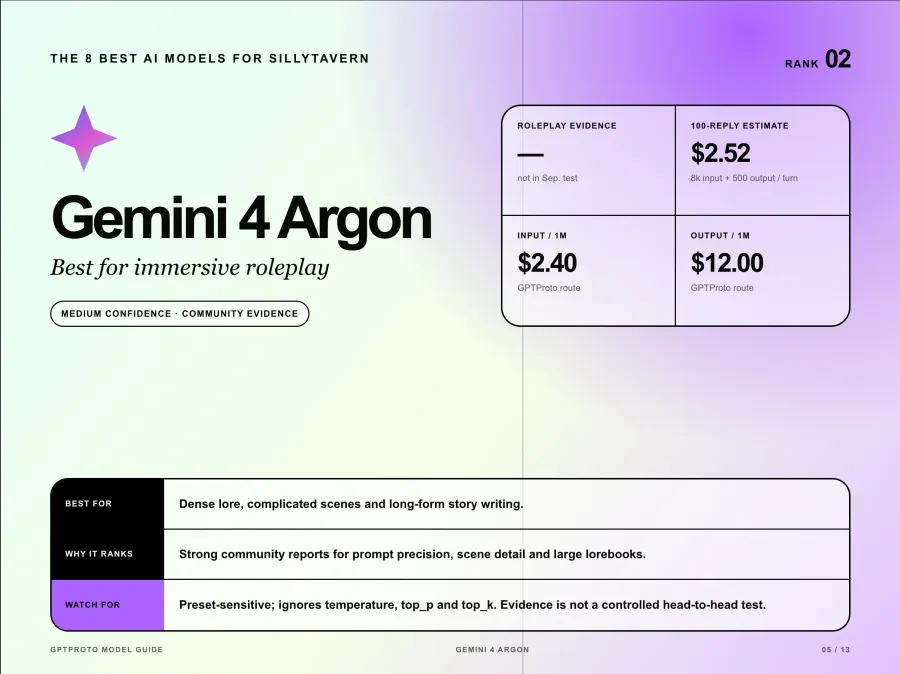
Tingkat kepercayaan lebih rendah daripada Kimi atau GLM karena Argon tidak disertakan dalam tolok ukur roleplay bulan September. Antusiasme komunitas adalah buktinya, tetapi ini bukan tes head-to-head yang terkontrol.
Argon juga memerlukan preset-nya sendiri. API-nya mengabaikan temperature, top_p, dan top_k, jadi menyalin preset Gemini lama yang berat pada sampler hanya menciptakan ilusi kontrol tanpa mengubah nilai-nilai tersebut. Mulailah dengan thinking tingkat menengah untuk obrolan karakter satu lawan satu dan coba thinking tingkat tinggi hanya untuk RPG yang sarat aturan atau lorebook besar. Sisi negatifnya adalah biaya: tarif input $2,40 dan output $12 membuat tes 100 balasan tetap berada di kisaran $2,52 sebelum riwayat meluas.
3 GLM 5.3 Model Cerita Paling Seimbang
GLM-5.3 adalah alternatif paling meyakinkan untuk Kimi K3 jika Anda ingin model tersebut lebih banyak membawa alur cerita. Model ini mencetak 85,1 secara keseluruhan, 92,5 untuk Strict Voice, dan 85,8 untuk Robustness. Tolok ukur tersebut menggambarkannya sangat efektif untuk roleplay berbasis cerita, fiksi gelap, dan bot petualangan.
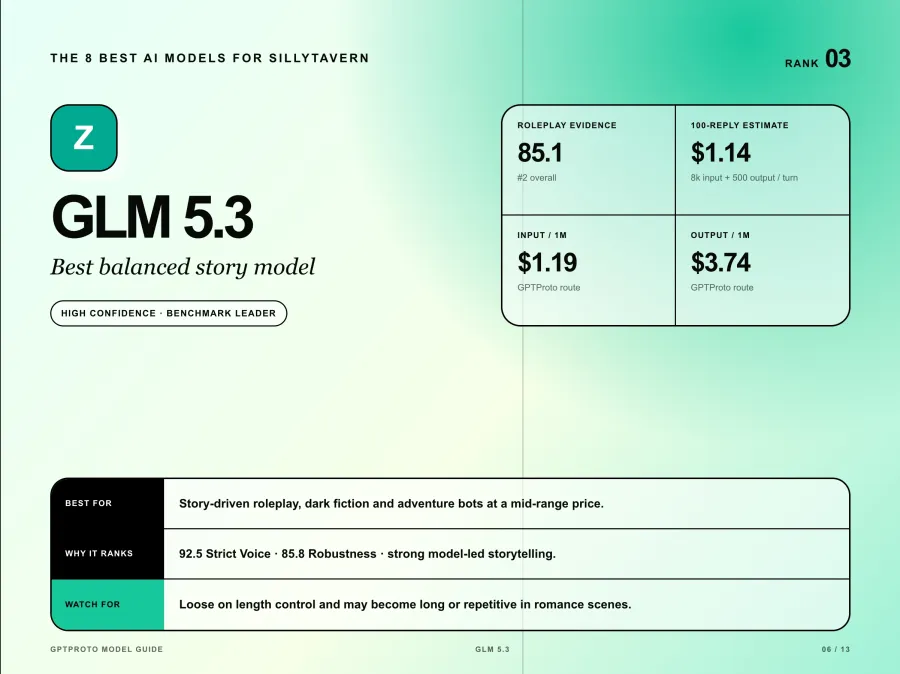
Komprominya adalah kontrol atas panjang dan tempo. GLM-5.3 adalah yang paling longgar di antara model terkemuka terkait batasan kata dan berkinerja jauh lebih buruk dalam skenario romansa pada tolok ukur tersebut, di mana balasan menjadi panjang dan berulang. Panjang respons maksimum yang ketat dan instruksi pasca-riwayat yang jelas sangat membantu, tetapi tidak menjamin output yang ringkas.
Dengan biaya input $1,19 dan output $3,74 per juta token, GLM-5.3 menelan biaya kurang dari setengah harga Kimi K3 dalam contoh 100 balasan tetap. Gunakan ID model glm-5.3. Ini adalah pilihan default yang masuk akal bagi pengguna yang menginginkan kualitas roleplay yang kuat tanpa harus membayar tarif model premium di setiap giliran.
4 DeepSeek V4.1 Flash Terbaik untuk Sesi Panjang yang Terjangkau
DeepSeek V4.1 Flash menawarkan argumen kualitas-terhadap-biaya paling bersih dalam daftar ini. Model ini mencetak skor 84,4 secara keseluruhan, tetap berada dalam batas kata pada semua 28 dari 28 balasan roleplay inti, dan menempati posisi pertama dalam kategori Penjahat (Villain). Tarif input $0,24 dan output $0,96 miliknya membuat contoh 100 balasan tetap berada di angka sekitar $0,24.
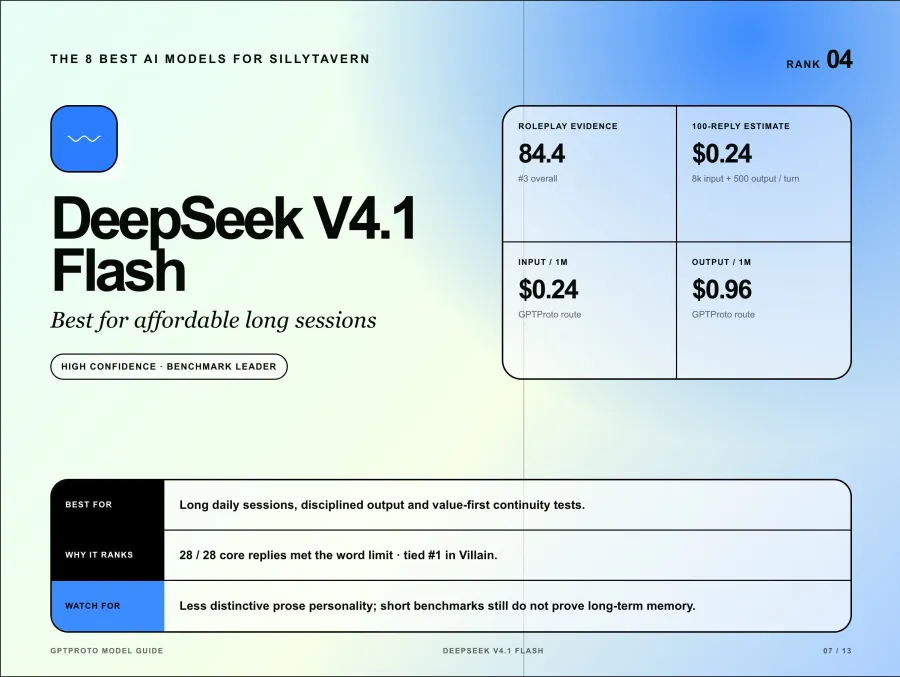
Model ini kurang menonjol sebagai penata prosa dibandingkan Kimi, Argon, atau Opus. Hal itu bisa menjadi keuntungan jika kartu karakter sudah memiliki suara yang kuat: model ini cenderung tidak akan menimpanya dengan gaya khasnya sendiri. Model ini juga berguna saat Anda mengharapkan sesi harian yang panjang dan ingin menyimpan model yang lebih mahal untuk adegan-adegan penting.
Gunakan deepseek-flash di SillyTavern. Penilaian saya adalah ini merupakan uji nilai pertama terbaik untuk obrolan jangka panjang, namun tolok ukur tersebut masih menggunakan skenario pendek. Anda harus menjalankan uji kontinuitas 30 hingga 50 giliran Anda sendiri sebelum menganggap harganya yang murah sebagai bukti memori jangka panjang.
5 GLM 5.3 Flash Game Master Murah Terbaik
GLM-5.3 Flash adalah spesialis anggaran. Model ini mencetak skor 89,2 sebagai Game Master dan 98,3 untuk Suara Ketat (Strict Voice), skor kategori tunggal tertinggi dalam tolok ukur bulan September. Dengan $0,1275 untuk input dan $0,425 untuk output per juta token, contoh 100 balasan tetap menelan biaya sekitar $0,12.
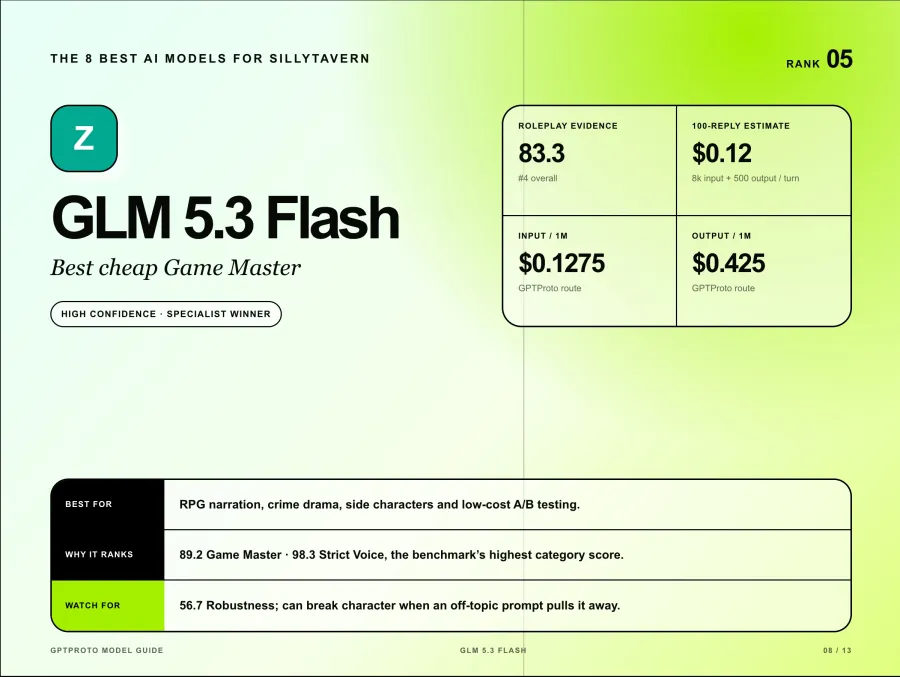
Titik lemahnya sama pentingnya. GLM-5.3 Flash hanya mencetak skor 56,7 untuk Ketahanan (Robustness) setelah keluar dari karakter untuk menjawab permintaan di luar topik layaknya asisten umum. Model ini juga melewatkan lebih banyak batas kata roleplay inti dibandingkan pemimpin lainnya.
Pilih model ini untuk narasi RPG, drama kriminal, karakter sampingan, atau pengujian A/B yang murah. Jangan berasumsi bahwa harganya yang murah menjadikannya model pendamping terbaik. Di SillyTavern, simpan aturan karakter di dekat akhir prompt dan uji upaya penyimpangan yang disengaja sebelum melakukan obrolan panjang dengannya. ID modelnya adalah glm-5.3-flash.
6 Gemini 3.8 Flash Model Cepat Terbaik untuk Sehari-hari
Gemini 3.8 Flash layak mendapatkan tempat penuh dalam daftar ini daripada sekadar disebutkan sepintas. Sebuah tolok ukur roleplay komunitas baru-baru ini menguji hingga 64 respons per model di delapan bab dan memberikan Gemini 3.8 Flash skor kualitas 91,9. Tes tersebut memberikan bobot 75 persen pada preferensi penulisan dan 25 persen pada ketangguhan. Ini adalah bukti yang berguna, namun skornya tidak dapat dibandingkan secara langsung dengan AI Roleplay Bench karena prompt dan metode penilaiannya berbeda.
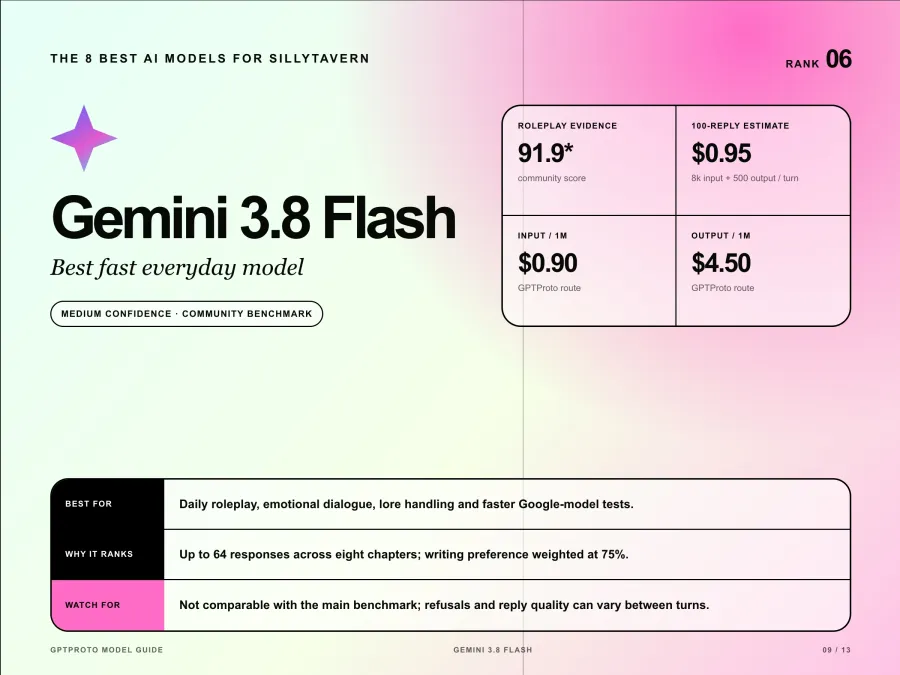
Laporan komunitas juga memuji dialog emosional, penanganan lore, dan ritme percakapan model ini. Sisi kekurangannya adalah konsistensi: beberapa pengguna melaporkan penolakan acak atau balasan yang tidak merata bahkan ketika giliran sebelumnya berjalan dengan baik.
Gunakan gemini-3.8-flash dan mulailah dengan pemikiran tingkat menengah. Tarif input $0,90 dan output $4,50 membuatnya jauh lebih murah daripada Argon, meskipun contoh 100 balasan tetap memakan biaya sekitar $0,95. Pilih model ini jika Anda menginginkan model Google untuk penggunaan sehari-hari tetapi tidak memerlukan penalaran premium Argon di setiap giliran.
7 Claude Opus 5.5 Model Prosa Premium Terbaik
Claude Opus 5.5 adalah pilihan prosa premium, bukan pemenang universal. Pengguna yang menyukainya menunjuk pada kesadaran spasial, pengetahuan dunia, tempo, dan kemampuan untuk membuat latar terasa hidup. Sebuah laporan komunitas SillyTavern yang mendetail merekomendasikannya untuk roleplay cerita umum sambil beralih ke model lain saat sebuah adegan memerlukan penanganan konten yang berbeda.
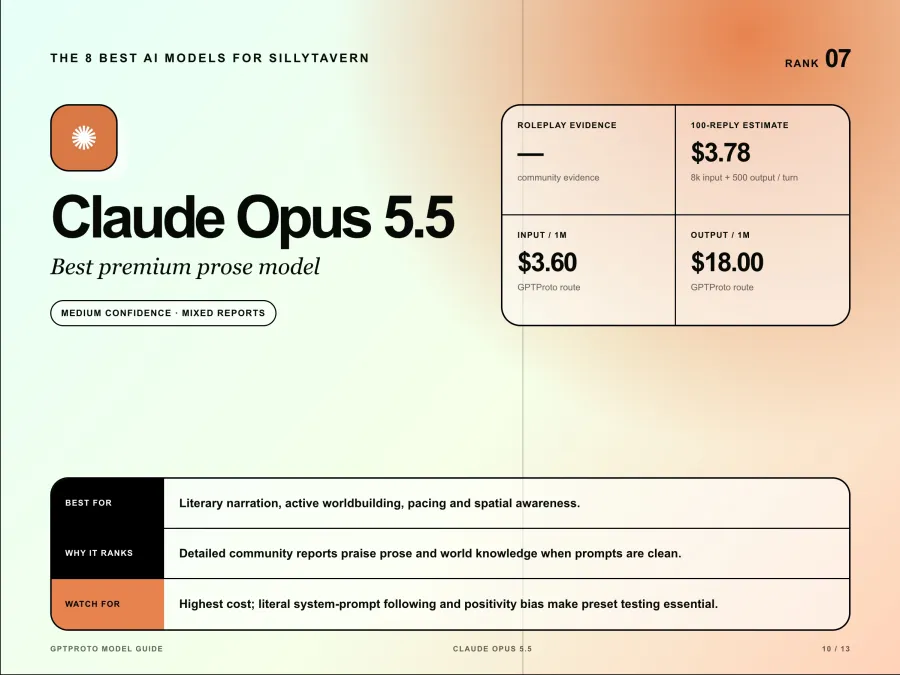
Pengguna lain melaporkan bahwa Opus mengikuti prompt sistem yang besar secara harfiah sehingga instruksi yang bertentangan dalam kartu karakter atau preset dapat mendistorsi karakter tersebut. Bias positif adalah keluhan lain yang sering muncul. Perbedaan pendapat itu menjelaskan mengapa saya tidak akan menempatkannya di atas pemimpin tolok ukur tanpa menguji kartu yang tepat.
Harganya adalah kelemahan yang paling jelas: $3,60 untuk input dan $18 untuk output per juta token, atau sekitar $3,78 dalam contoh 100 balasan tetap. Gunakan claude-opus-5-5, mulailah dengan prompt yang bersih, dan hapus aturan preset warisan yang tidak dapat Anda jelaskan. Opus layak diuji untuk narasi sastra. Sulit untuk membenarkan penggunaannya untuk obrolan santai bervolume tinggi.
8 GPT 6 Luna Model GPT Ultra Murah Terbaik
GPT-6 Luna adalah alasan mengapa GPT tidak boleh absen dari panduan SillyTavern, meskipun model ini bukan model roleplay terbaik secara keseluruhan. Luna mencetak skor 71,1 secara keseluruhan, jauh di bawah empat pemimpin tolok ukur, dengan 68,3 untuk Companion, 60,0 untuk Strict Voice, dan 54,2 untuk Robustness. Sifatnya yang terlalu berhati-hati berulang kali membuatnya keluar dari alur fiksi.
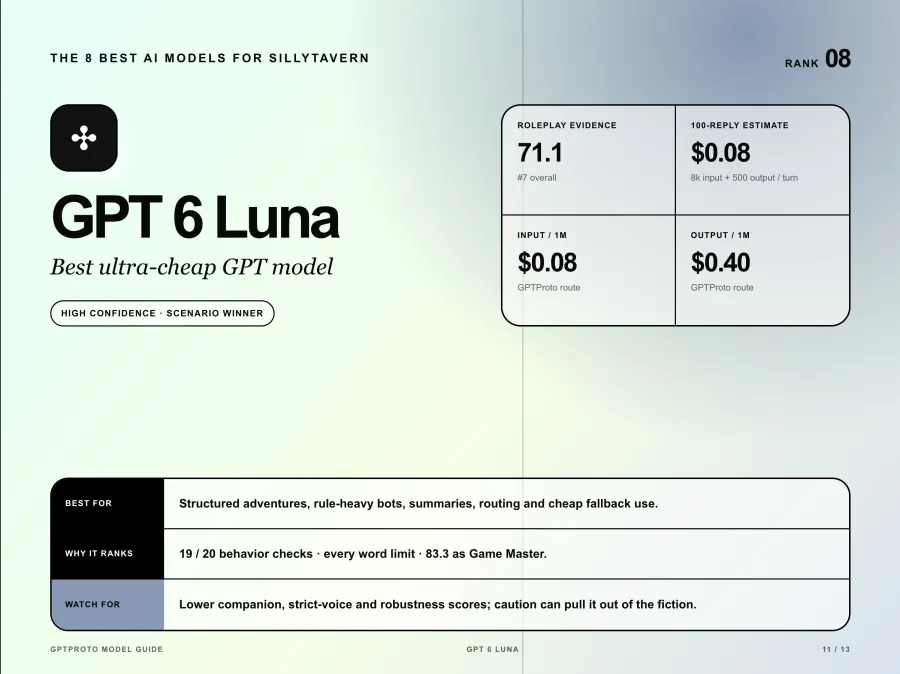
Separuh hasil lainnya cukup berguna. GPT-6 Luna berhasil melewati 19 dari 20 pemeriksaan perilaku, memenuhi setiap batasan kata yang diuji, dan mencetak skor 83,3 sebagai Game Master. Dengan harga $0,08 untuk input dan $0,40 untuk output per satu juta token, contoh 100 balasan tetap menelan biaya sekitar delapan sen.
Gunakan gpt-6-luna untuk petualangan terstruktur, bot yang sarat aturan, ringkasan, perutean, atau sebagai cadangan murah. Jangan memilihnya dibandingkan Kimi, GLM, atau Gemini jika imersi emosional adalah tujuan utamanya. Ini adalah pemenang untuk skenario tertentu, bukan klaim terselubung bahwa model peringkat ketujuh dalam tolok ukur ini adalah yang terbaik secara keseluruhan.
Mengapa Tidak Ada Lebih Banyak Model GPT, Claude, dan Gemini
Peringkat yang berguna tidak boleh menyediakan ruang yang sama untuk setiap penyedia. Setiap model tambahan memerlukan bukti roleplay yang kuat atau pekerjaan yang jelas berbeda.
| Keluarga model |
Pilihan daftar utama |
Model lain yang layak diuji |
Mengapa alternatif tidak diberi peringkat secara terpisah |
| GPT |
GPT-6 Luna |
GPT-6.1 Terra dengan harga $0,80 / $4,00 |
Terra memiliki harga yang menarik dan kemampuan menulis umum, tetapi belum ada tolok ukur roleplay yang sebanding |
| Claude |
Claude Opus 5.5 |
Claude Sonnet 5.5 dengan harga $1,80 / $9,00 |
Ini adalah opsi Claude yang lebih murah, tetapi bukti spesifik RP saat ini terlalu tipis untuk klaim pemenang yang terpisah |
| Claude |
Claude Opus 5.5 |
Claude Haiku 5.5 dengan harga $0,09 / $0,45 |
Haiku diposisikan untuk pekerjaan ringan bervolume tinggi; harga murah saja tidak menjamin prosa yang kuat atau konsistensi sesi yang panjang |
| Gemini |
Gemini 4 Argon dan 3.8 Flash |
Varian Gemini Flash Lite |
Model Lite yang lebih murah tidak memiliki bukti komunitas spesifik RP yang sama |
| Kimi |
Kimi K3 |
Kimi K3.1 Pro dengan harga $2,00 / $10,00 |
Model ini lebih baru dan menjanjikan, tetapi belum menggantikan K3 dalam tolok ukur spesialis |
Inilah alasan mengapa GPT-6 Luna berada di peringkat kedelapan alih-alih menghilang. Model ini memiliki bukti untuk pekerjaan yang spesifik. Terra mungkin akan melampauinya nanti, tetapi membuat klaim tersebut sekarang akan mencampuradukkan kemampuan umum dengan kinerja roleplay yang telah diuji.
Model Lokal Terbaik untuk SillyTavern berdasarkan VRAM
Menjalankan SillyTavern secara lokal tidak berarti model bahasanya juga lokal. Frontend-nya sendiri memiliki kebutuhan yang sederhana, sementara inferensi lokal membutuhkan memori GPU yang cukup untuk bobot model dan cache konteks. Ikhtisar resmi SillyTavern merekomendasikan setidaknya 6 GB VRAM sebagai titik awal untuk inferensi lokal.
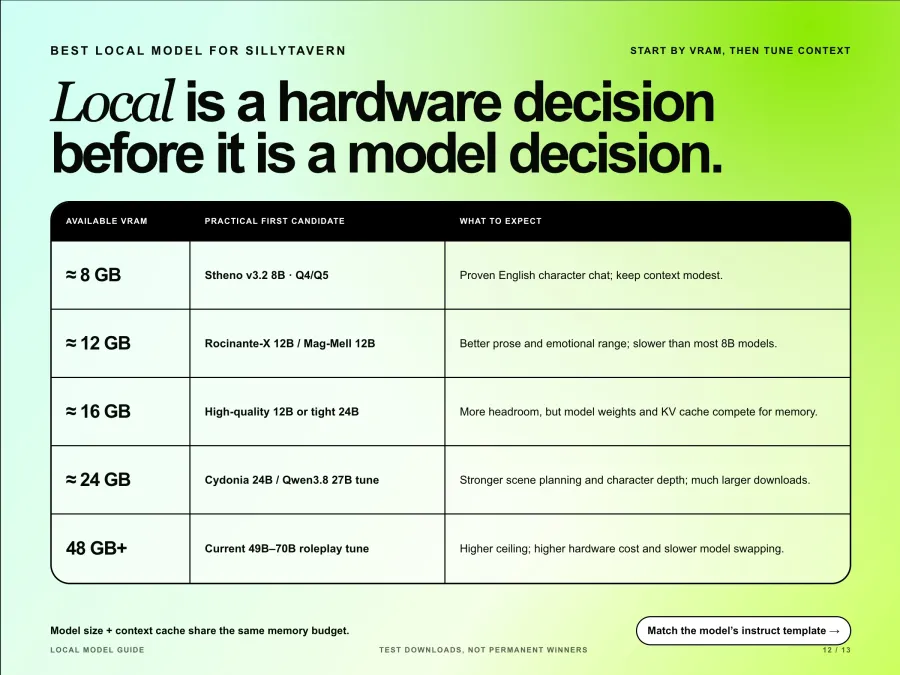
Rekomendasi model lokal berubah dengan cepat, jadi anggap ini sebagai unduhan pertama untuk pengujian, bukan sebagai pilihan permanen. Direktori model roleplay Hugging Face saat ini berisi ribuan varian komunitas dengan templat dan kuantisasi yang sangat berbeda.
| VRAM yang Tersedia |
Kandidat awal yang praktis |
Apa yang diharapkan |
| Sekitar 8 GB |
Stheno v3.2 8B dalam Q4 atau Q5 |
Titik awal yang terbukti untuk obrolan karakter bahasa Inggris, tetapi konteks harus tetap sederhana |
| Sekitar 12 GB |
Rocinante-X 12B atau Mag-Mell 12B |
Prosa dan jangkauan emosional yang lebih baik daripada kebanyakan model 8B, dengan pembuatan teks yang lebih lambat |
| Sekitar 16 GB |
Kuantisasi 12B berkualitas lebih tinggi, atau model 24B dengan konteks pendek dan offload parsial |
Lebih banyak ruang kualitas, tetapi file model yang pas di VRAM tidak menjamin cache KV yang besar akan muat |
| Sekitar 24 GB |
Cydonia 24B atau tune roleplay Qwen3.8 27B |
Perencanaan adegan dan kedalaman karakter yang lebih baik, dengan unduhan yang jauh lebih besar |
| 48 GB ke atas |
Tune roleplay 49B hingga 70B saat ini |
Batas atas yang lebih tinggi, tetapi biaya perangkat keras yang besar dan pertukaran model yang jauh lebih lambat |
Untuk kartu 8 GB, pertukaran utamanya sederhana: ukuran model dan konteks bersaing untuk memori yang sama. Mulailah dengan konteks yang lebih kecil, konfirmasikan suara karakter, lalu tingkatkan batasnya sambil memantau VRAM dan kecepatan pembuatan teks.
Untuk backend Penyelesaian Teks lokal, pilih templat instruksi model yang sebenarnya. Dokumentasi Mode Instruksi SillyTavern memperingatkan bahwa templat yang dipilih harus sesuai dengan format yang diharapkan oleh model. Fine-tune yang kuat dengan templat yang salah bisa terlihat lebih buruk daripada model yang lebih kecil yang dikonfigurasi dengan benar.
Model Terbaik untuk Roleplay Jangka Panjang
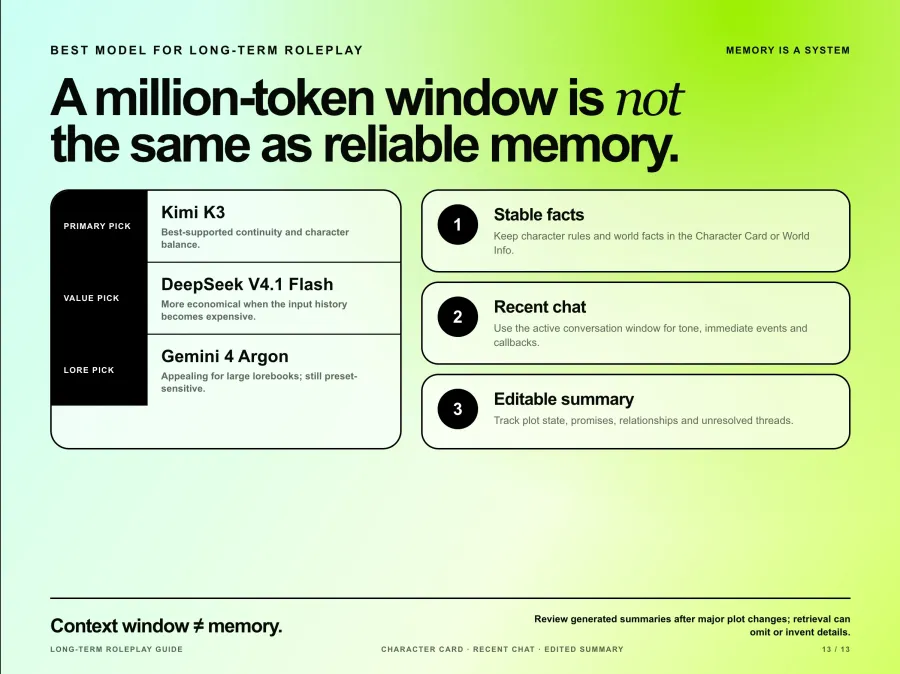
Kimi K3 adalah pilihan terkuat yang didukung bukti untuk kesinambungan karakter jangka panjang, sementara DeepSeek V4.1 Flash adalah pilihan yang lebih ekonomis saat riwayat percakapan menjadi mahal. Gemini 4 Argon menarik untuk lorebook yang besar, namun jendela satu juta token tidak boleh disalahartikan sebagai memori yang andal.
Dokumentasi konteks SillyTavern menjelaskan bahwa hanya pesan di dalam rentang konteks aktif yang dikirim ke model. Informasi karakter, prompt sistem, World Info, ringkasan, dan ruang respons semuanya menggunakan anggaran yang sama. Begitu pesan lama berada di luar rentang tersebut, model tidak dapat mengingatnya kecuali Anda memasukkan kembali fakta yang relevan.
Gunakan tiga lapisan alih-alih hanya mengandalkan ukuran konteks:
Simpan fakta karakter dan aturan dunia yang stabil di kartu karakter atau World Info.
Gunakan riwayat obrolan terbaru untuk nada bicara dan peristiwa langsung.
Pertahankan ringkasan singkat yang dapat diedit untuk status plot, hubungan, janji, dan alur yang belum terselesaikan.
Ekstensi Summarize dapat mengotomatiskan lapisan ketiga, tetapi dokumentasinya sendiri memperingatkan bahwa ringkasan yang dihasilkan model mungkin menghilangkan detail atau mengarangnya. Tinjau ringkasan setelah perubahan plot besar. Vektorisasi Obrolan bersifat eksperimental dan dapat membuat pengambilan data kurang efektif, jadi fitur ini harus diuji alih-alih langsung diaktifkan begitu saja.
Cara Mengganti Model di SillyTavern
Beralih model tidak menghapus obrolan, tetapi dapat mengubah suara, pemformatan, perilaku penolakan, dan cara pesan sebelumnya diinterpretasikan. Simpan preset terpisah untuk setiap keluarga model alih-alih memaksakan satu preset untuk digunakan di seluruh model GPT, Claude, Gemini, dan penyelesaian teks lokal.
Untuk GPT Proto, pengaturan singkatnya adalah:
Buka API Connections di SillyTavern.
Pilih Chat Completion dan Custom OpenAI compatible.
Atur Base URL ke https://gptproto.com/v1. Jangan tambahkan /chat/completions; SillyTavern akan menambahkannya secara otomatis.
Tempel kunci API dan masukkan ID model yang tepat seperti kimi-k3, glm-5.3-flash, atau gemini-3.8-flash.
Mulailah dengan Prompt Post-Processing yang diatur ke None, hubungkan, dan jalankan Test Message.
Panduan integrasi API SillyTavern yang diilustrasikan mencakup instalasi, kartu karakter, tangkapan layar, dan kesalahan koneksi umum.
Jika Anda ingin memverifikasi kunci dan model yang sama di luar SillyTavern, permintaan ini menggunakan rute yang kompatibel dengan OpenAI yang identik:
export GPTPROTO_API_KEY="YOUR_KEY"

curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3",
    "messages": [
      {"role": "user", "content": "Reply in character with one short sentence."}
    ],
    "max_tokens": 120
  }'
Setelah beralih, uji setidaknya lima putaran dengan kartu karakter yang sama. Sertakan satu balasan singkat, satu prompt di luar topik, satu instruksi tentang panjang balasan, dan satu panggilan balik ke detail sebelumnya. Hal itu akan menangkap lebih banyak masalah daripada sekadar menilai pesan pembuka saja.
Model SillyTavern Mana yang Harus Anda Pilih
Pilih Kimi K3 jika Anda menginginkan satu pilihan standar yang didukung oleh bukti.
Pilih Gemini 4 Argon untuk lore yang kompleks dan pengembangan adegan yang imersif, dengan menerima biaya yang lebih tinggi dan kepastian benchmark yang lebih rendah.
Pilih GLM-5.3 jika Anda menginginkan pencerita yang kuat dengan harga kelas menengah.
Pilih DeepSeek V4.1 Flash untuk sesi panjang yang terjangkau dan output yang disiplin.
Pilih GLM-5.3 Flash untuk narasi RPG hemat biaya dan suara karakter yang ketat.
Pilih Gemini 3.8 Flash untuk Gemini yang lebih cepat dan murah dengan pengujian komunitas yang menjanjikan.
Pilih Claude Opus 5.5 jika kualitas prosa cukup penting untuk membenarkan biayanya.
Pilih GPT-6 Luna untuk RP terstruktur, ringkasan, atau perutean cadangan yang paling murah.
Pilih fine-tune roleplay lokal jika privasi, penggunaan offline, dan pembuatan tanpa batas lebih penting daripada waktu pengaturan dan kualitas model cloud.
Anda dapat membandingkan sinyal penggunaan saat ini dan harga model di halaman model SillyTavern GPT Proto, lalu uji karakter dan riwayat yang sama di berbagai model melalui playground API roleplay.