Jika Anda sedang menentukan pilihan antara GPT 6.1 Terra vs Sonnet 5.5 hari ini, berikut adalah aturan keputusan singkat yang saya gunakan sebelum menjalankan tolok ukur:
Pilih GPT-6.1 Terra jika alur kerja Anda menjalankan inspeksi tangkapan layar bervolume tinggi, otomatisasi formulir dan faktur, debugging tata letak UI, atau tugas pengodean terbatas di mana tarif token $0,80/$4,00 dan eksekusi tugas yang 3x lebih cepat lebih penting daripada kedalaman refaktorisasi otonom puncak—dan input permintaan tunggal Anda tetap berada pada atau di bawah 272K token.
Tetap gunakan Claude Sonnet 5.5 jika agen Anda menjalankan migrasi repositori multi-file, debugging terminal mendalam di mana kesalahan edit lebih mahal daripada tagihan token, atau prompt sekali jalan antara 300K dan 900K token di mana biaya tambahan konteks panjang OpenAI menghapus keunggulan harga input Terra.
Anda dapat memeriksa tarif katalog langsung atau menjalankan volume token bulanan Anda sendiri melalui pusat perbandingan model GPT Proto sebelum memilih salah satu jalur. Semua yang ada di bawah ini adalah perbandingan berbasis dokumentasi dan tolok ukur yang diverifikasi pada 5 November 2026; tolok ukur yang dilaporkan vendor diberi label terpisah dari pengukuran independen oleh Artificial Analysis dan umpan balik pengembang awal.
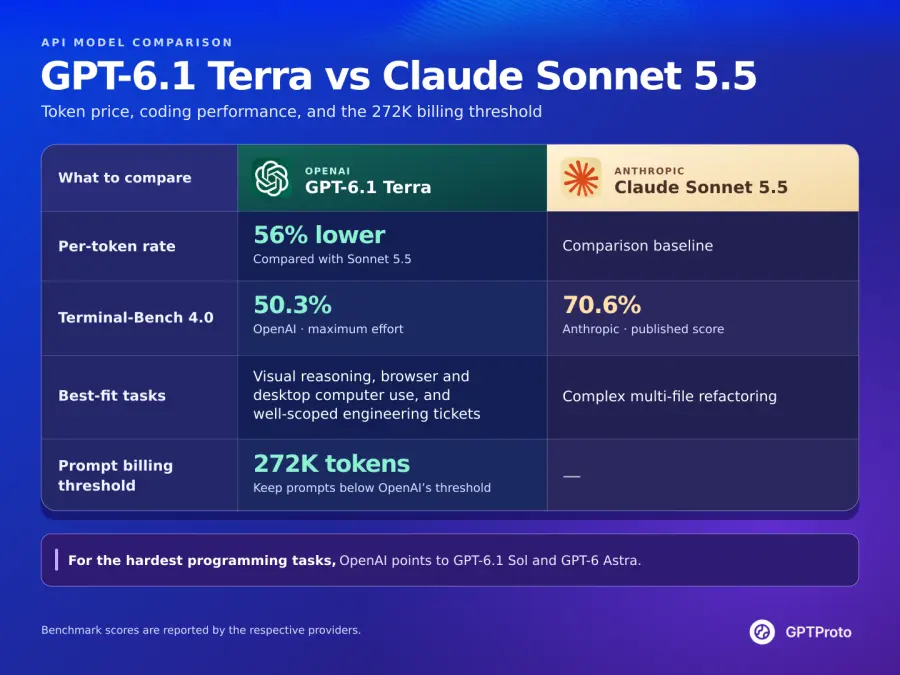
Sekilas Perbandingan GPT-6.1 Terra vs Claude Sonnet 5.5
Pengembang yang mencari perbandingan ChatGPT 6.1 Terra vs Sonnet 5.5 atau Anthropic Claude Sonnet 5.5 vs GPT 6.1 Terra sering kali menemukan lembar spesifikasi yang bertentangan karena kedua vendor menyusun kontrol penalaran, titik akhir alat (tool endpoints), dan biaya tambahan konteks panjang dengan cara yang berbeda. Tabel di bawah ini menyelaraskan kedua model tersebut dengan dokumentasi resmi gpt-6.1-terra OpenAI, ikhtisar Claude Sonnet 5.5 dari Anthropic, dan tarif katalog GPT Proto secara langsung.
| Spesifikasi |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| Penyedia |
OpenAI |
Anthropic |
| Tanggal rilis |
26 Oktober 2026 |
28 September 2026 |
| Input / output standar resmi (per 1 juta token) |
$1,00 / $5,00 |
$2,00 / $10,00 |
| Input / output GPT Proto (per 1 juta token) |
$0,80 / $4,00 (−20% vs resmi) |
$1,80 / $9,00 (−10% vs resmi) |
| Pembacaan input cache resmi (per 1 juta token) |
$0,05 (5% dari input dasar) |
$0,10 (dipotong dari $0,20 pada 7 Okt 2026) |
| Penulisan cache resmi (per 1 juta token) |
$1,25 (TTL 30m) / $2,50 (TTL 12j) |
$2,50 (TTL 5m) |
| Pembacaan / penulisan cache GPT Proto (per 1 juta token) |
$0,04 / $1,00 |
$0,09 / $2,25 (verifikasi halaman model langsung) |
| Jendela konteks |
1.050.000 token |
1.000.000 token |
| Aturan harga konteks panjang |
>272K input menagih permintaan penuh pada 2x input/cache dan 1,5x output |
Tarif tetap di seluruh jendela konteks 1 juta penuh |
| Token output maksimum |
128.000 token |
128.000 token |
| Modalitas input / output |
Teks, Gambar, Dokumen masuk → Teks keluar |
Teks, Gambar, Dokumen masuk → Teks keluar |
| Batas pengetahuan |
1 Juni 2026 |
Awal hingga pertengahan 2026 (mempertahankan tokenizer Sonnet 5) |
| Kontrol penalaran / upaya |
none, low, medium (default), high, xhigh, max |
Pemikiran adaptif aktif secara default; medium, high (default API), max, between_tools |
| Titik akhir yang diperlukan untuk pemanggilan alat |
/v1/responses diperlukan oleh dokumen OpenAI |
/v1/messages (asli) atau /v1/chat/completions yang kompatibel dengan OpenAI |
| Ketersediaan klien & IDE |
ChatGPT Work & Codex (bukan Chat biasa), GitHub Copilot, Claude Code (via API) |
Claude.ai, Claude Code, GitHub Copilot, Cursor |
| Indeks Kecerdasan AA (v4.3.2) |
41 (medium) / 48 (max) |
56 (max, Default Fallback) |
| Biaya tugas evaluasi rata-rata AA |
$0,10 (`medium`) / $0,40 (max) |
$5,46 (max, Default Fallback) |
| Terminal-Bench 4.0 (dilaporkan vendor) |
50,3% (max effort) |
70,6% |
Tiga baris dalam tabel tersebut melakukan hampir semua pekerjaan saat Anda menganggarkan aplikasi. Pertama, pada permintaan standar di bawah 272K token, GPT-6.1 Terra 56% lebih murah per token di GPT Proto untuk input dan output, sehingga penyelesaian yang panjang tidak mengubah peringkat biaya. Kedua, Sonnet 5.5 memegang keunggulan 20,3 poin persentase pada Terminal-Bench 4.0, yang melacak dengan cermat bagaimana kedua model berperilaku pada pengeditan repositori yang tidak dipandu. Ketiga, tidak seperti GPT-6.1 Sol, GPT-6.1 Terra memulihkan dukungan untuk reasoning.effort: "none", memberikan pengembang OpenAI jalur cepat non-penalaran yang sejati kembali.
Rincian Harga dan Biaya: Mana yang Lebih Mahal dan Mana yang Lebih Hemat Biaya?
Ketika pengembang mencari "GPT 6.1 Terra vs Sonnet 5.5 mana yang lebih mahal" atau "mana yang lebih hemat biaya," mereka biasanya mencoba menyelaraskan dua angka yang berbeda: tarif per satu juta token di halaman harga dan biaya dolar aktual dari tugas agen yang selesai. Kedua rasio tersebut tidak sama.
Pada tingkat per-token, Claude Sonnet 5.5 adalah model dengan harga lebih tinggi dengan selisih yang lebar. Harga resmi Anthropic adalah $2,00 per satu juta token input dan $10,00 per satu juta token output—dua kali lipat dari harga daftar OpenAI sebesar $1,00/$5,00 untuk Terra. Karena GPT Proto menerapkan diskon 20% pada GPT-6.1 Terra ($0,80 input / $4,00 output) dan diskon 10% pada Claude Sonnet 5.5 ($1,80 input / $9,00 output), Sonnet 5.5 berharga 2,25x lipat lebih mahal per token di platform ini. Kedua vendor sekarang menetapkan harga baca input yang di-cache sebesar 5% dari input dasar ($0,05 resmi untuk Terra vs $0,10 resmi untuk Sonnet 5.5 setelah Anthropic memangkas harga baca cache Sonnet pada Oktober 2026), dan keduanya mengenakan biaya 1,25x input dasar untuk penulisan cache standar ($1,25 vs $2,50 resmi). Perhatikan bahwa prompt panjang sekali pakai yang ditulis ke cache sebenarnya menambahkan biaya tambahan 25% pada model mana pun jika Anda tidak pernah membaca prefiks tersebut untuk kedua kalinya.
Pada tingkat per-tugas, kesenjangan menjadi jauh lebih curam. Dalam Artificial Analysis's Intelligence Index v4.3.2 (diterbitkan 26–27 Oktober 2026), konfigurasi Claude Sonnet 5.5 (max effort dengan Default Fallback) yang diuji mencatat biaya rata-rata tertimbang sebesar $5,46 per tugas evaluasi. Dalam rangkaian evaluasi yang sama, [GPT-6.1 Terra pada upaya `max`](https://artificialanalysis.ai/models/gpt-6-1-terra) rata-rata $0,40 per tugas, dan GPT-6.1 Terra pada upaya medium rata-rata hanya $0,10 per tugas. Itu adalah perbedaan 13,6x pada upaya max dan perbedaan 54,6x saat membandingkan pengaturan tertinggi Sonnet dengan pengaturan medium default Terra.
Mengapa perbedaan 2x per-token berubah menjadi kesenjangan tagihan 13x hingga 54x? Model penalaran menagih token pemikiran sebagai token output. Ketika Sonnet 5.5 berjalan pada upaya tinggi atau maksimum pada tolok ukur terbuka, ia menghasilkan rantai penalaran yang panjang dengan harga $10,00 per satu juta token ($9,00 di GPT Proto). Pengumuman Terra juga mencatat bahwa pada upaya maksimum di Agents' Last Exam, Terra menggunakan kurang dari sepertiga jumlah token dibandingkan Claude Opus 5.5. Yang lebih penting lagi adalah temuan Pareto-frontier dari Artificial Analysis: untuk GPT-6.1 Terra, pengaturan upaya low dan medium adalah Pareto-optimal untuk kecerdasan versus biaya. Meningkatkan Terra ke max mendorong skornya dari 41 menjadi 48, yang menyamai GPT-6.1 Sol pada upaya medium—kecuali Sol medium berharga $0,21 per tugas sementara Terra `max` berharga $0,40. Singkatnya, jika Anda menginginkan pengaturan yang paling hemat biaya di Terra, tetap gunakan low atau medium; jika suatu tugas cukup sulit untuk menuntut upaya max, Anda seharusnya sudah menguji Sol atau Sonnet 5.5.
Perhitungan Biaya yang Dihasilkan: Dua Skenario Produksi Nyata
Untuk melihat di mana tarif token yang lebih murah benar-benar memberikan keuntungan—dan di mana hal itu justru menjadi bumerang—mari kita lakukan perhitungan yang tepat berdasarkan tarif katalog langsung GPT Proto ($0,80/$4,00 untuk Terra; $1,80/$9,00 untuk Sonnet 5.5), dengan asumsi permintaan tanpa cache di bawah 272K token.
Skenario A adalah loop agen QA visual dan ekstraksi formulir sebanyak 20 langkah. Setiap langkah mengirimkan tangkapan layar dan cuplikan DOM dengan total 15.000 token input dan menghasilkan 1.500 token output (termasuk medium token penalaran). Selama 20 langkah, satu alur kerja mengonsumsi 300.000 token input (0,3 juta) dan 30.000 token output (0,03 juta):
GPT-6.1 Terra di GPT Proto: (0,3 * $0,80) + (0,03 * $4,00) = $0,24 + $0,12 = $0,36 per alur kerja.
Claude Sonnet 5.5 di GPT Proto: (0,3 * $1,80) + (0,03 * $9,00) = $0,54 + $0,27 = $0,81 per alur kerja.
Dengan 10.000 alur kerja per bulan, Terra menelan biaya $3.600 dibandingkan dengan $8.100 untuk Sonnet—penghematan bulanan sebesar $4.500. Bahkan jika Terra gagal dalam validasi pada 20% dari prosesnya dan harus mengulang 2.000 alur kerja tersebut dari awal (menambah $720), total tagihan Anda adalah $4.320, yang masih menghemat $3.780 per bulan dibandingkan dengan menjalankan Sonnet tanpa pengulangan.
Skenario B adalah refaktor backend multi-file dalam pull request yang aktif. Misalkan setiap upaya membaca 80.000 token input dan mengeluarkan 10.000 token output. Satu kali proses bersih pada Sonnet 5.5 memakan biaya (0,08 * $1,80) + (0,01 * $9,00) = $0,234. Satu kali proses pada Terra memakan biaya (0,08 * $0,80) + (0,01 * $4,00) = $0,104. Anda menghemat 13 sen pada panggilan API. Masalahnya adalah jika Terra melewatkan dependensi tipe lintas modul—yang selaras dengan kesenjangan Terminal-Bench 50,3% vs 70,6%—dan memaksa tiga kali pengulangan ditambah 12 menit waktu insinyur senior dengan biaya $90/jam ($18,00 untuk tenaga kerja), penghematan token sebesar 13 sen itu justru merugikan tim Anda sebesar $18,18. Singkatnya: Terra menang telak pada loop yang dapat diulang dan diverifikasi oleh mesin, sementara Sonnet 5.5 membayar tarifnya yang lebih tinggi setiap kali pengeditan yang gagal menghabiskan waktu peninjauan manusia.
Konteks Jendela (1,05 Juta vs 1 Juta): Mengapa Melewati 272K Mengubah Biaya
Di atas kertas, perbandingan GPT 6.1 Terra vs Sonnet 5.5 konteks jendela terlihat seimbang dengan sedikit keunggulan bagi OpenAI: Terra menerima 1.050.000 token input dan menghasilkan hingga 128.000 token output, sedangkan Claude Sonnet 5.5 menerima 1.000.000 token input dan menghasilkan hingga 128.000 token output. Sebagian besar tabel perbandingan berhenti di situ.
Namun, jika Anda membaca dokumentasi model gpt-6.1-terra OpenAI, terdapat batas penagihan pada 272.000 token input yang benar-benar mengubah ekonomi konteks panjang. Setiap kali prompt melebihi 272K token input pada GPT-6.1 Terra, OpenAI menagih seluruh permintaan—bukan hanya token di atas 272K—sebesar 2x lipat tarif input dan cache serta 1,5x lipat tarif output.
Berikut adalah apa yang terjadi pada tarif resmi per satu juta token saat prompt Anda melewati batas dari 272.000 token menjadi 272.001 token:
| Kategori Konteks |
GPT-6.1 Terra (Tarif Resmi) |
Claude Sonnet 5.5 (Tarif Resmi) |
Hubungan Harga Input |
| Prompt standar (≤272K token input) |
$1,00 input / $5,00 output / $0,05 baca cache |
$2,00 input / $10,00 output / $0,10 baca cache |
Terra 50% lebih murah untuk input dan output |
| Prompt konteks panjang (>272K hingga 1Juta+ token input) |
$2,00 input / $7,50 output / $0,10 baca cache |
$2,00 input / $10,00 output / $0,10 baca cache |
Tarif input dan baca cache identik ($2,00 / $0,10) |
Berbeda dengan model Haiku 5.5 yang lebih kecil dari Anthropic (yang menerapkan biaya tambahan 5x di atas 100K token), Claude Sonnet 5.5 mempertahankan harga tetap di seluruh jendela konteks 1.000.000 token miliknya.
Mari hitung audit repositori 400.000 token yang menghasilkan 10.000 token output dengan tarif daftar resmi:
GPT-6.1 Terra (memicu aturan >272K 2x/1,5x): (0,4 * $2,00) + (0,01 * $7,50) = $0,80 + $0,075 = $0,875.
Claude Sonnet 5.5 (tarif tetap): (0,4 * $2,00) + (0,01 * $10,00) = $0,80 + $0,10 = $0,900.
Setelah prompt Anda melewati 272K token, diskon input 50% milik Terra hilang sepenuhnya, menyisakan perbedaan total $0,025 pada panggilan 400K token. Rekomendasi saya sederhana: jangan pernah mengirim prompt monolitik >272K token ke GPT-6.1 Terra dengan harapan mendapatkan ekonomi setengah harga. Entah bagi/ambil konteks Anda di bawah 272K token agar Terra tetap berada di braket $1,00 ($0,80 GPT Proto), atau arahkan dump repositori 300K–900K langsung ke Claude Sonnet 5.5, di mana Anda membayar tarif input resmi yang sama dan mendapatkan pemahaman kode jangka panjang yang lebih kuat. (Sebelum menjalankan prompt >272K dalam produksi melalui GPT Proto, konfirmasikan dengan dukungan platform bagaimana penyesuaian tingkat 272K upstream tercermin pada saldo akun Anda.)
Tolok Ukur dan Umpan Balik Komunitas: Pengodean, Frontend, dan Pekerjaan Agen
Skor komposit utama menyembunyikan di mana setiap model sebenarnya berhasil. Pada Artificial Analysis Intelligence Index v4.3.2, Claude Sonnet 5.5 (max, Default Fallback) mencetak skor 56, GPT-6.1 Sol (max) mencetak skor 52, dan GPT-6.1 Terra mencetak skor 48 pada upaya max dan 41 pada upaya medium. (Pada snapshot indeks 3 November 2026 yang ditampilkan di kartu perbandingan GPT Proto, Sonnet 5.5 mencatat 54,2 dan Terra max mencatat 51—selisih 3,2 poin yang lebih sempit yang masih mengunggulkan Sonnet.) Untuk membuat keputusan perutean praktis untuk kode, UI frontend, atau loop agen, kita harus memecah agregat tersebut berdasarkan jenis tugas dan membandingkannya dengan apa yang dilaporkan pengembang di lapangan.
1. Pengodean Backend dan Terminal (GPT 6.1 Terra vs Sonnet 5.5 untuk kode)
Untuk rekayasa perangkat lunak murni dari baris perintah, Anthropic masih memegang keunggulan yang jelas. Pada Terminal-Bench 4.0, Anthropic melaporkan 70,6% untuk Claude Sonnet 5.5 (naik dari 10,3% pada Sonnet 5), sedangkan OpenAI melaporkan 50,3% untuk GPT-6.1 Terra pada upaya maksimal (naik dari 21,5% pada GPT-5.6 Terra). Dalam Coding Agent Index v2.0 yang baru dirilis oleh Artificial Analysis, Terra mencetak skor 48—17 poin di depan GPT-6 Luna versi ringan (31), tetapi 6 poin di belakang GPT-6.1 Sol (54). Artificial Analysis juga mencatat bahwa khusus untuk agen pengodean, pengaturan upaya rendah dan sangat tinggi Terra berada pada batas efisiensi biaya, sementara pengaturan upaya lainnya tertinggal.
Pengujian dunia nyata tahap awal menunjukkan batasan yang tepat antara kedua model tersebut:
Catatan rilis GitHub Copilot tanggal 26 Oktober 2026 melaporkan bahwa dalam pengujian internal tahap awal, GPT-6.1 Terra menyelesaikan tugas terminal dan pengodean C# secara nyata lebih banyak daripada GPT-5.6 Terra, menambahkan observasi perilaku yang krusial: "Model ini bekerja dalam langkah-langkah yang terfokus dan terkonsolidasi pada tugas-tugas dengan cakupan yang jelas." GitHub tidak memublikasikan persentase tingkat keberhasilan mentah dalam catatan tersebut, jadi anggaplah ini sebagai temuan platform kualitatif alih-alih tolok ukur terkontrol.
Di sisi Claude, sebuah uji coba pengembang head-to-head tahap awal di r/ClaudeAI (menjalankan sepuluh tugas pengodean pribadi tiga kali per konfigurasi pada upaya tinggi di Claude Code dan pi-agent) menemukan bahwa Sonnet 5.5 secara konsisten menyelesaikan implementasi dalam putaran percakapan yang lebih sedikit dan token output yang lebih sedikit daripada pendahulunya, sebagian besar karena Sonnet 5.5 melakukan batch panggilan alat paralel secara lebih agresif. Demikian pula, pada evaluasi CursorBench 4.0 eksternal Cursor, Sonnet 5.5 pada upaya tinggi mencetak skor 47,8% dengan biaya $1,67 per tugas.
Kesimpulan bagi pengembang backend: jika tiket memiliki cakupan yang jelas—menulis metode layanan C#, menambahkan pengujian unit, atau memperbaiki skrip CLI yang terisolasi—Terra pada upaya rendah atau sedang akan menyelesaikannya dengan cepat dengan harga kurang dari setengah harga token. Jika tiket memerlukan pelacakan status di sepuluh file di mana satu putaran percobaan ulang tambahan merusak alur kerja, kompetensi terminal 70,6% milik Sonnet 5.5 membenarkan tarif yang lebih tinggi. Jika komputasi ilmiah terlibat, OpenAI juga melaporkan bahwa pada Terminal-Bench-Science 0.1 (seperti menulis kode untuk melacak pembelahan sel dalam video selang waktu), Terra pada upaya maksimal justru melampaui GPT-6.1 Sol dan berada dalam jarak lima poin dari Claude Opus 5.5 dengan biaya kurang dari seperlima dari perkiraan biaya.
2. GPT-6.1 Terra vs Sonnet 5.5 untuk Coding Frontend
Mencari GPT 6.1 Terra vs Sonnet 5.5 untuk Coding Frontend layak mendapatkan jawabannya sendiri karena rekayasa frontend adalah dua pekerjaan berbeda yang disatukan: pekerjaan tata letak visual/DOM dan logika status/arsitektur.
Ketika OpenAI memperkenalkan skor 50,3% GPT-6.1 Terra pada Terminal-Bench 4.0, satu-satunya contoh coding konkret yang disorot dalam pengumuman tersebut adalah bug frontend: "memperbaiki halaman web yang tata letaknya bergeser saat dimuat" (Cumulative Layout Shift, atau CLS). Pada saat yang sama, OpenAI melaporkan bahwa pada MMMU-Pro—tolok ukur untuk penalaran visual atas diagram, tangkapan layar, dan tata letak yang padat—GPT-6.1 Terra mengungguli GPT-5.6 Terra di semua tingkat upaya dan hampir menyamai GPT-6 Astra dan GPT-6.1 Sol yang terdepan dengan harga yang jauh lebih murah. Dalam utas hari peluncuran di forum Komunitas Pengembang OpenAI, salah satu reaksi pengembang pertama merangkum Terra sebagai "sangat sepadan dengan harganya, terutama dalam hal pemahaman visual. Cukup bagus juga dalam hal coding."
Pembagian tersebut memberikan tim frontend pembagian kerja yang jelas:
Gunakan GPT-6.1 Terra untuk pekerjaan frontend visual dan lapisan UI: mengubah tangkapan layar Figma atau wireframe menjadi markup Tailwind/HTML awal, membandingkan tangkapan layar Playwright yang dirender dengan spesifikasi desain untuk menemukan node DOM yang tumpang tindih atau regresi breakpoint seluler, dan mendiagnosis pergeseran tata letak CSS. Karena Terra memproses gambar secara native, berjalan lebih dari 3x lebih cepat daripada GPT-6.1 Sol dan Astra pada tolok ukur tindakan visual, dan berharga $0,80/$4,00 di GPT Proto, pipeline CI Anda mampu menjalankan pemeriksaan regresi visual pada setiap commit.
Gunakan Claude Sonnet 5.5 untuk arsitektur frontend yang berat logika: melakukan refactoring pada pohon status server-action React/Next.js yang kompleks, menyelesaikan batasan generik TypeScript yang rumit, atau memigrasikan penyimpanan Redux lama tanpa merusak hidrasi. Jika tidak ada tangkapan layar untuk diperiksa dan kesulitannya murni terletak pada koherensi status multi-file, Sonnet 5.5 tetap menjadi pilihan yang lebih aman.
3. Pekerjaan Agen, Penggunaan Komputer, dan Faktualitas (untuk pekerjaan agen)
Jika definisi Anda tentang GPT 6.1 Terra vs Sonnet 5.5 untuk pekerjaan agen berpusat pada otomatisasi GUI, penguraian dokumen, dan penggunaan komputer back-office, GPT-6.1 Terra bisa dibilang merupakan rilis bernilai terkuat dari OpenAI di tahun 2026.
Dalam evaluasi yang dilaporkan vendor OpenAI pada Agents' Last Exam v1 (yang menguji alur kerja profesional multi-langkah seperti mengubah gambar arsitektur menjadi model 3D atau mencatat kode waktu per bidikan di seluruh film animasi), GPT-6.1 Terra pada upaya sedang mencetak skor 15 poin persentase lebih tinggi daripada GPT-5.6 Terra dengan biaya sekitar sepertiganya, menyamai GPT-6 Astra unggulan dengan sepersepuluh harga token. Pada upaya maksimal, OpenAI melaporkan bahwa Terra lebih dari 3x lipat lebih efisien dalam penggunaan token dibandingkan Claude Opus 5.5 dan 1/4 dari harganya per token, menghasilkan biaya per tugas yang kira-kira 9x lebih rendah sambil menyelesaikan alur kerja lebih dari 3x lebih cepat daripada GPT-6 Astra dan GPT-6.1 Sol.
Pada OSWorld 2.1 (kontrol aplikasi desktop), OpenAI melaporkan bahwa Terra pada upaya sedang mengalahkan skor terbaik GPT-5.6 Terra dengan sebagian kecil dari biaya per tugas. Agar tetap seimbang, skor OSWorld 2.1 (offline) yang dipublikasikan Anthropic untuk Claude Sonnet 5.5 adalah 83,9% yang sangat tinggi (diungkapkan dalam tabel tolok ukur Haiku 5.5 Anthropic Oktober 2026). Kedua model tersebut adalah mesin penggunaan komputer tingkat atas; perbedaannya adalah agen screen-scraping mengirimkan tangkapan layar baru pada setiap klik, yang menghabiskan token input dengan cepat dan membuat tarif input GPT Proto Terra sebesar $0,80/M jauh lebih mudah dipertahankan dalam skala besar.
Sama pentingnya bagi agen otonom adalah mengetahui kapan model tidak mengetahui sesuatu. Dalam tolok ukur independen AA-Omniscience dari Artificial Analysis, tingkat halusinasi GPT-6.1 Terra (seberapa sering model menebak ketika kurang memiliki pengetahuan) turun sebesar 50 poin persentase—dari 88% pada GPT-5.6 Terra menjadi 38%—sembari secara bersamaan memperoleh 2 poin dalam akurasi keseluruhan. Pengukuran independen tersebut mendukung evaluasi faktualitas internal OpenAI (dijelaskan lebih lanjut dalam Kartu Sistem GPT-6.1 Terra), di mana tingkat kesalahan faktual upaya rendah pada prompt yang sulit turun dari 53,6% menjadi 16,7% (dan turun menjadi 4,3% pada upaya maksimal). Tingkat halusinasi yang lebih rendah berarti lebih sedikit panggilan alat yang rusak di hilir.
Pengalaman Pengembang dan Jebakan API (GPT 6.1 Terra vs Sonnet 5.5 untuk pengembang)
Beralih antara gpt-6.1-terra dan claude-sonnet-5-5 dalam produksi jarang sekali bisa dilakukan hanya dengan penggantian string satu baris. Jika Anda sedang mengevaluasi ergonomi GPT 6.1 Terra vs Sonnet 5.5 untuk pengembang, empat batasan tingkat API akan menentukan pekerjaan integrasi Anda.
Pertama, GPT-6.1 Terra mendukung reasoning.effort: "none", sedangkan GPT-6.1 Sol tidak. Ketika OpenAI meluncurkan GPT-6.1 Sol pada 29 September 2026, mereka menghapus tingkatan penalaran none dan minimal, memaksa setiap permintaan ke tingkat low atau lebih tinggi, serta merusak temperature dan top_p secara menyeluruh. Menurut panduan migrasi dan prompting OpenAI's official gpt-6.1-terra prompting and migration guide, Terra mendukung spektrum penuh: none, low, medium (default), high, xhigh, dan max. Jika Anda mengatur reasoning_effort: "none", Terra berjalan tanpa menghasilkan token penalaran tersembunyi dan mengizinkan parameter pengambilan sampel standar. Namun, saat Anda menggunakan low, medium, high, xhigh, atau max, Anda harus menghapus temperature, top_p, top_logprobs, dan logprobs dari payload permintaan Anda, atau API akan menolak panggilan tersebut dengan error HTTP 400.
Kedua, OpenAI mewajibkan Responses API (/v1/responses) untuk pemanggilan alat (tool calling) pada GPT-6.1 Terra. Meskipun prompt teks dan gambar biasa berfungsi pada /v1/chat/completions, dokumentasi model OpenAI menyatakan secara eksplisit bahwa pemanggilan alat memerlukan /v1/responses. Setelah menggunakan Responses API, Terra mendukung kesembilan alat bawaan asli OpenAI—Pencarian web, Pencarian file, Pembuatan gambar, Interpreter kode, Hosted shell, apply_patch, Skills, Penggunaan komputer, MCP, dan Pencarian alat—ditambah async: true pada alat fungsi kustom sehingga model dapat terus menalar saat alat latar belakang yang lambat sedang berjalan. Selain itu, Terra mendukung pengiriman item input configuration_update di tengah percakapan untuk menaikkan atau menurunkan reasoning.effort pada giliran yang sulit tanpa menulis ulang awalan prompt atau membatalkan cache prompt 30 menit Anda (prompt_cache_options.ttl: "30m").
Ketiga, Claude Sonnet 5.5 memiliki jebakan error 400-nya sendiri. Menurut panduan migrasi Sonnet 5.5 Anthropic, Sonnet 5.5 menggunakan pemikiran adaptif secara default (default ke upaya high pada API dan medium di Claude Code, sebagaimana dicatat dalam dokumentasi konfigurasi Claude Code Anthropic). Jika integrasi Claude lama Anda mengirim thinking: {"type": "disabled"}, Anda harus memperbaruinya ke between_tools untuk pengaturan pemikiran terendah. Lebih penting lagi, Sonnet 5.5 menolak pilihan alat paksa (tool_choice: {"type": "any"} atau alat bernama yang dipaksakan) dengan error 400 saat pemikiran adaptif aktif; Anda harus menggunakan auto dan memandu pemilihan alat dalam prompt. Anda juga perlu mengurai blok konten respons berdasarkan type alih-alih berasumsi bahwa content[0] adalah teks, karena blok pertama sering kali merupakan blok thinking.
Keempat, integrasi IDE dan CLI sudah terhubung untuk keduanya. Perhatikan bahwa dalam langganan konsumen, catatan rilis OpenAI mengonfirmasi bahwa GPT-6.1 Terra diluncurkan ke ChatGPT Work dan Codex (untuk paket Plus, Pro, Business, Enterprise, dan Edu), bukan antarmuka ChatGPT Chat standar, dan tidak mendukung residensi inferensi UEA (meskipun mode Cepat mendukung residensi data UE). Bagi pengembang yang bekerja di terminal lokal, kedua model dapat dihubungkan ke Claude Code dan OpenAI Codex melalui GPT Proto. Pada halaman model GPT-6.1 Terra, mengeklik Coba model ini akan membuka panel Mulai Cepat di mana Anda dapat memilih Claude Code atau ChatGPT (Codex) di bawah Biarkan AI menyelesaikan integrasi, atau klik Salin Markdown untuk AI agar asisten pengodean Anda menyiapkan variabel lingkungan secara otomatis.
Membangun Aplikasi: Cara Merutekan Kedua Model dengan Satu Kunci API
Ketika tim bertanya tentang GPT 6.1 Terra vs Sonnet 5.5 untuk membangun aplikasi, arsitektur terbaik hampir tidak pernah memilih satu model untuk 100% lalu lintas. Karena kedua model berada di bawah satu saldo prabayar di GPT Proto, Anda dapat melakukan perutean berdasarkan langkah, bukan berdasarkan vendor: kirim inspeksi visual frekuensi tinggi, klasifikasi tangkapan layar, dan perbaikan UI terbatas ke gpt-6.1-terra dengan harga $0.80/$4.00, dan eskalasikan sintesis kode multi-file ke claude-sonnet-5-5 dengan harga $1.80/$9.00.
1. Pemeriksaan cURL Panggilan Pertama (Chat Completions yang Kompatibel dengan OpenAI)
Kedua model dapat dipanggil untuk analisis teks dan visual melalui titik akhir /v1/chat/completions GPT Proto yang terpadu dan kompatibel dengan OpenAI menggunakan token Bearer standar. Beralih di antara keduanya hanya memerlukan perubahan string "model" saja:
# Panggilan 1: GPT-6.1 Terra ($0.80 input / $4.00 output per 1 juta token di GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "Periksa aturan CSS ini dan jelaskan dalam dua kalimat mengapa aturan ini memicu pergeseran tata letak di seluler: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# Panggilan 2: Claude Sonnet 5.5 ($1.80 input / $9.00 output per 1 juta token di GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Tulis helper TypeScript yang memvalidasi tanda tangan webhook menggunakan Web Crypto API dengan perbandingan waktu konstan."
      }
    ]
  }'
2. Contoh Python Step-Router untuk Pipeline Frontend & Aplikasi
Berikut adalah pola Python praktis yang menggunakan SDK openai standar yang diarahkan ke https://gptproto.com/v1. Dalam alur kerja ini, Langkah 1 menggunakan gpt-6.1-terra untuk melakukan triase laporan bug UI (di mana volume token tinggi dan diagnosis visual/DOM murah), dan Langkah 2 secara dinamis merutekan patch kode aktual ke gpt-6.1-terra (untuk perbaikan CSS komponen tunggal yang terisolasi) atau claude-sonnet-5-5 (ketika triase menandai perubahan status lintas file atau ketika prompt mendekati batas 272K):
import os
import json
from openai import OpenAI

# Satu kunci API dan saldo bersama di seluruh model OpenAI dan Anthropic
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # Langkah 1: Selalu jalankan triase visual/DOM pada GPT-6.1 Terra ($0.80 / $4.00 per 1 juta token)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "Anda adalah agen triase QA frontend. Periksa tangkapan layar dan DOM. "
                    "Kembalikan JSON dengan kunci: 'root_cause', 'scope' ('isolated_css' atau 'multi_file_state'), "
                    "dan 'target_files' (array string)."
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"Snapshot DOM: {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # Langkah 2: Rute berdasarkan cakupan tugas DAN batas penagihan konteks panjang 272K
    # Jika perbaikan menyentuh status multi-file ATAU melebihi 272K token input, eskalasikan ke Sonnet 5.5
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"Diagnosis triase: {json.dumps(triage_data)} | "
                    f"Hasilkan patch minimal yang siap produksi untuk DOM/komponen: {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"Patch diarahkan ke: {result['routed_to']}")
    print(result["patch"])
Catatan pra-penyebaran (diperlukan uji asap): Verifikasi string model yang tepat (gpt-6.1-terra dan claude-sonnet-5-5) terhadap panel Penggunaan API langsung di halaman model GPT Proto sebelum menyebarkan loop yang dapat ditagih. Jika agen Anda mengandalkan alat API Respons asli OpenAI (apply_patch, Hosted shell, atau pemanggilan fungsi async: true) atau parameter pemikiran adaptif /v1/messages asli Anthropic (output_config.effort), jalankan uji asap cepat terhadap titik akhir asli GPT Proto (/v1/responses dan /v1/messages) untuk mengonfirmasi penerusan parameter pada rute Anda.
Putusan: Mana yang Harus Anda Gunakan?
Jika Anda menginginkan satu tabel untuk ditempelkan ke dalam dokumen tinjauan arsitektur, sesuaikan beban kerja utama Anda dengan mode kegagalan dan batasan penagihan yang paling Anda perhatikan:
| Beban Kerja / Skenario |
Model yang Direkomendasikan |
Pengaturan yang Direkomendasikan |
Mengapa Model Ini Unggul |
| QA tangkapan layar volume tinggi, pembacaan faktur/formulir, & penggunaan komputer berbasis browser |
GPT-6.1 Terra |
low atau medium effort |
Tarif token GPT Proto 56% lebih rendah ($0,80/$4,00), penyelesaian tugas >3x lebih cepat daripada Sol/Astra, dan visi MMMU-Pro setingkat Astra. |
| Debugging UI frontend (pergeseran tata letak CLS, Figma-ke-CSS, regresi visual) |
GPT-6.1 Terra |
medium effort |
Dibuat untuk inspeksi visual + DOM; secara eksplisit diuji pada perbaikan pergeseran tata letak halaman web. |
Klasifikasi latensi rendah, perutean, atau ekstraksi JSON di mana temperature diperlukan |
GPT-6.1 Terra |
reasoning.effort: "none" |
Mengembalikan tingkat none non-penalaran yang dihapus oleh GPT-6.1 Sol, menjaga latensi dan jumlah token output tetap minimal. |
| Refactoring backend multi-file & perubahan status TypeScript/React yang kompleks |
Claude Sonnet 5.5 |
medium atau high effort |
70,6% vs 50,3% pada Terminal-Bench 4.0; memproses panggilan alat dalam lebih sedikit giliran, menghemat waktu peninjauan pengembang yang mahal. |
| Analisis repositori konteks panjang satu permintaan (300K hingga 900K token input) |
Claude Sonnet 5.5 |
medium atau high effort |
Terra memicu biaya tambahan 2x input / 1,5x output di atas 272K token (melonjak menjadi $2,00 input resmi), menghapus keunggulan harganya. |
Pengodean terminal asli OpenAI terdalam saat Terra max tidak mencukupi |
GPT-6.1 Sol |
medium effort |
Mencetak skor 54 vs 48 milik Terra pada AA Coding Agent Index v2.0, dan Sol medium ($0,21/tugas) sebenarnya lebih murah per tugas daripada Terra `max` ($0,40/tugas). |
Singkatnya, tanpa keraguan: mulailah setiap langkah visual, penggunaan komputer, dan pengodean terbatas yang berulang pada GPT-6.1 Terra dengan upaya low atau medium untuk mendapatkan tarif $0,80/$4,00, dan gunakan Claude Sonnet 5.5 untuk langkah pengodean multi-file dan prompt >272K-token di mana akurasi putaran pertama yang lebih tinggi dan harga konteks 1M yang tetap akan terbayar dengan sendirinya. Untuk memasukkan rasio input dan output bulanan Anda sendiri, buka kalkulator perbandingan GPT Proto dan uji kedua model secara berdampingan pada satu saldo.