Tổng quan về GPT-6.2 Astra
| Câu hỏi |
Câu trả lời ngắn gọn |
| GPT-6.2 Astra là gì? |
Mô hình GPT-6.2 có năng lực cao nhất của OpenAI dành cho lập trình phức tạp và công việc chuyên môn |
| Ngày phát hành |
17 tháng 11, 2026 |
| ID mô hình API |
gpt-6.2-astra |
| Cửa sổ ngữ cảnh |
1,05 triệu token |
| Đầu vào / đầu ra tối đa |
922.000 / 128.000 token |
| Các phương thức |
Đầu vào văn bản và hình ảnh; đầu ra văn bản |
| Giá API tiêu chuẩn của OpenAI |
$8 cho đầu vào, $0,40 cho đầu vào đã lưu vào bộ nhớ đệm và $40 cho đầu ra trên mỗi 1 triệu token |
| Giá GPT Proto |
$6,40 cho đầu vào, $0,32 cho đầu vào đã lưu vào bộ nhớ đệm và $32 cho đầu ra trên mỗi 1 triệu token — Giảm giá 20% |
| Phù hợp nhất cho |
Gỡ lỗi phức tạp, đánh giá mã, di chuyển hệ thống, phân tích dữ liệu, tài liệu chuyên môn, khoa học, CAD và quy trình làm việc 3D |
| Lựa chọn mặc định tốt hơn cho hàng ngày |
GPT-6.2 Sol cho lập trình thông thường, viết lách và các công việc chi phí thấp hơn |
Tài liệu mô hình OpenAI liệt kê các hỗ trợ cho Phản hồi và Hoàn thành trò chuyện, cùng với các công cụ bao gồm tìm kiếm web, tìm kiếm tệp, trình thông dịch mã, shell được lưu trữ, sử dụng máy tính, MCP và tạo hình ảnh. Bản thân mô hình trả về văn bản. Các bảng tính, trang trình bày, trang web hoặc tài sản 3D hoàn chỉnh phụ thuộc vào các công cụ và môi trường thực thi xung quanh nó.
Người dùng sớm đang thực sự thảo luận về điều gì?
Cuộc thảo luận khi ra mắt không chủ yếu xoay quanh điểm số chuẩn. Nó xoay quanh khoảng cách giữa năng lực thô và khả năng sử dụng hàng ngày.
1. Astra có thể rất xuất sắc trong việc đánh giá và sửa chữa các hệ thống hiện có
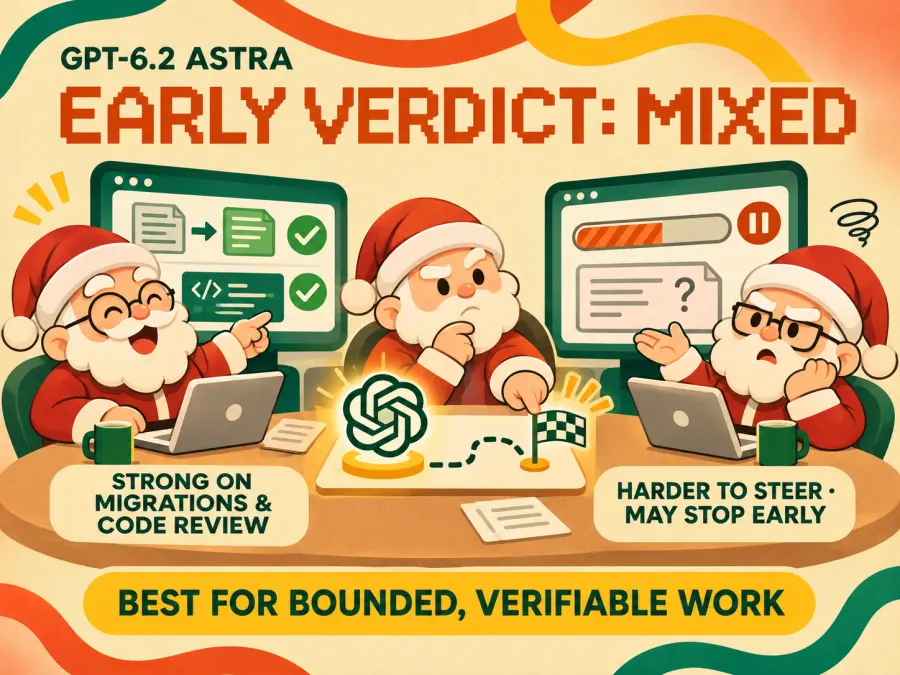
Thử nghiệm Copilot sớm của GitHub cho thấy GPT-6.2 Astra phát hiện được nhiều vấn đề đánh giá mã thực tế hơn đáng kể so với GPT-6 Astra trong khi sử dụng ít token hơn. Điều đó có ý nghĩa hơn đối với một nhóm sản xuất so với một bản demo ứng dụng dùng một lần khác: công việc có giá trị thường là tìm ra lỗi, bảo toàn hành vi hiện có và chứng minh bản vá bằng các bài kiểm tra.
Kỹ sư Tibor Blaho đã mô tả việc sử dụng Astra trong công việc cơ sở hạ tầng và phần mềm hàng ngày, bao gồm quản lý máy chủ, sao lưu, giám sát, nghiên cứu, quản trị, gỡ lỗi và đánh giá mã. Ví dụ nổi bật của anh ấy là nâng cấp một ứng dụng cũ với hàng triệu dòng mã và các phụ thuộc cũ của nó lên phiên bản ngôn ngữ hiện tại. Anh ấy đã báo cáo kết quả có thể sử dụng cục bộ sau khoảng ba giờ và vượt qua bài kiểm tra kiểm tra sạch sau khoảng sáu giờ, đồng thời lưu ý rằng vẫn còn nhiều việc phải làm.
Đây là một giai thoại, không phải là một điểm chuẩn được kiểm soát. Nó vẫn là một ví dụ hữu ích vì nó bao gồm một cơ sở mã thực tế, thời gian đã trôi qua và một bước xác minh. Nó cũng chỉ ra một quy trình làm việc thực tế: Blaho sử dụng các mô hình Astra và Claude để nghiên cứu và đánh giá công việc của nhau thay vì giả định rằng một mô hình sẽ bắt được mọi lỗi.
2. Các phiên chạy tự động dài có thể gây thất vọng
Các báo cáo tiêu cực cũng rất cụ thể. Bài đánh giá sớm của Dan Shipper cho biết Astra thường dừng lại quá sớm trong các bản dựng mã hóa đầu cuối và có thể quá ngắn gọn đến mức khó theo dõi nội dung. Ethan Mollick gọi nó là không đồng nhất và khó điều khiển hơn: nó đã xây dựng thành công trải nghiệm thang máy không gian đầy tham vọng bằng Blender và Unity, nhưng anh ấy vẫn không thấy mình sử dụng nó như một mô hình hàng ngày.
Tường thuật chi tiết của nhà phát triển Theo cũng có những ý kiến trái chiều tương tự. Anh ấy khen ngợi Astra với tư cách là một người đánh giá mã, cho biết nó đã tìm ra các giải pháp mới lạ và ghi nhận nó với thiết kế reverse-proxy có thể giúp công ty của anh ấy tiết kiệm 25.000 đô la mỗi tháng. Anh ấy cũng báo cáo về các phiên chạy dài bị chặn bởi những câu hỏi mà anh ấy không thể trả lời, các vòng lặp không tiến triển và các bản tóm tắt khó hiểu hơn cả những thay đổi trong mã.
Những báo cáo này không chứng minh rằng mọi phiên chạy của Astra đều sẽ thất bại. Chúng xác định cùng một rủi ro từ các góc độ khác nhau: mô hình có thể đủ khả năng để thực hiện công việc nhưng lại khó giám sát khi mục tiêu không được xác định rõ ràng.
3. Đầu ra ngắn gọn là sự hiệu quả hay là thiếu ngữ cảnh
Hướng dẫn gợi ý (prompting guide) GPT-6.2 của OpenAI cho biết Astra mặc định ngắn gọn và trực tiếp hơn. Đối với phản hồi hỗ trợ, ghi chú đánh giá mã hoặc bản tóm tắt điều hành, điều đó có thể hữu ích. Đối với một lời giải thích phức tạp, nó có thể tạo cảm giác như mô hình đã bỏ qua phần lập luận mà người đọc cần.
Điều này giải thích tại sao các phản ứng ban đầu lại trái ngược nhau. Những người thử nghiệm một sản phẩm đầu ra có phạm vi hẹp có thể thấy ít nội dung thừa và ít token hơn. Những người sử dụng Astra như một cộng tác viên trong một dự án dài hơi có thể thấy các câu trả lời đột ngột, các quyết định không được giải thích hoặc việc bàn giao sớm.
4. Câu hỏi thực sự là hình thái tác vụ, không phải liệu Astra có “thông minh” hay không
Bằng chứng cho đến nay cho thấy một ranh giới phân chia đơn giản:
| Hình thái tác vụ |
Mức độ phù hợp ban đầu với Astra |
| Mục tiêu, công cụ, kiểm thử và đích đến rõ ràng |
Ứng viên tiềm năng |
| Đánh giá giá trị cao nơi các lỗi bị bỏ sót gây tốn kém |
Ứng viên tiềm năng |
| Công việc với dữ liệu hoặc tài liệu từ nhiều nguồn với đầu ra có thể kiểm tra được |
Ứng viên tiềm năng |
| Email thông thường, ghi chú cuộc họp hoặc chỉnh sửa mã nhỏ |
Thường nên dùng Sol trước |
| Nghiên cứu mở đòi hỏi sự phán đoán về những gì quan trọng |
So sánh với Fable 5.2 và giữ lại sự đánh giá của con người |
| Bản dựng tự động kéo dài hàng giờ với các quyết định mơ hồ |
Kiểm tra kỹ lưỡng trước khi dựa vào nó |
GPT-6.2 Astra có phù hợp cho công việc hàng ngày không?
Có, nhưng hầu hết công việc hàng ngày không cần đến nó. Đối với ghi chú cuộc họp, email thông thường, nghiên cứu ngắn, chỉnh sửa mã nhỏ hoặc bản nháp đầu tiên, GPT-6.2 Sol là điểm khởi đầu tự nhiên hơn. Đây là mô hình mà OpenAI định vị cho công việc hàng ngày và mức phí token của nó thấp hơn 75% so với Astra. GPT Proto áp dụng cùng mức giảm giá 20% cho cả hai mô hình, vì vậy khoảng cách giá đó vẫn không thay đổi.
Astra trở nên hữu ích khi một danh mục công việc thông thường chuyển thành một nhiệm vụ khó khăn, có giá trị cao. “Xem xét yêu cầu kéo (pull request) này” có thể phù hợp với Sol; “truy vết lỗi gián đoạn này trên ba dịch vụ, sửa lỗi và chạy các quy trình bị ảnh hưởng” là công việc dành cho Astra. “Tóm tắt tệp CSV này” là việc thường ngày; “tìm các vấn đề về chất lượng dữ liệu, giải thích các bẫy thống kê và xây dựng một sổ làm việc quyết định có thể chỉnh sửa” mang lại cho Astra nhiều không gian hơn để xứng đáng với chi phí của nó.
Các ứng dụng thực tế hàng ngày được báo cáo cho đến nay bao gồm gỡ lỗi, vận hành máy chủ, giám sát, sao lưu, đánh giá mã, nghiên cứu đa nguồn và quản trị văn phòng. Điểm chung không nằm ở nghề nghiệp. Đó là công việc có đủ độ phức tạp để hưởng lợi từ khả năng suy luận sâu hơn và đủ cấu trúc để xác minh kết quả.
GPT-6.2 Astra phù hợp cho việc gì?
Đánh giá mã, phân tích nguyên nhân gốc rễ và hiện đại hóa hệ thống cũ
Đây là trường hợp sử dụng thực tế rõ ràng nhất. Hãy cung cấp cho Astra quy trình làm việc bị lỗi, nhật ký liên quan, kho lưu trữ và các lệnh kiểm thử. Yêu cầu nó truy vết lỗi trên các dịch vụ, thực hiện bản sửa lỗi an toàn nhất và chạy các kiểm thử bị ảnh hưởng. Điều đó phù hợp với quy trình làm việc Astra được OpenAI khuyến nghị và các báo cáo tích cực từ GitHub cũng như các kỹ sư đời đầu.
Nâng cấp hệ thống cũ có thể là một lựa chọn đặc biệt phù hợp vì nhiệm vụ này khó nhưng có thể xác minh được. Mô hình có thể kiểm tra các phụ thuộc cũ, cập nhật mã theo từng giai đoạn và chạy bản dựng sạch nhiều lần. Con người vẫn cần xác định các yêu cầu tương thích và xem xét việc di chuyển. “Tất cả các kiểm thử đã vượt qua” chỉ là bằng chứng nếu bộ kiểm thử bao gồm các hành vi quan trọng.
Đối với việc xem xét yêu cầu kéo thông thường hoặc sửa đổi nhỏ, GPT-6.2 Sol có thể là đủ. OpenAI khuyến nghị rõ ràng Sol cho việc lập trình hàng ngày và nó có chi phí bằng một phần tư mức phí đầu vào và đầu ra tiêu chuẩn của Astra.
Phân tích dữ liệu, bảng điều khiển và sổ làm việc có thể chỉnh sửa
Giá trị của Astra ở đây không chỉ đơn thuần là viết truy vấn SQL. Nó có thể kiểm tra dữ liệu, nhận thấy các vấn đề về chất lượng, nêu các giả định, chạy phân tích và biến kết quả thành sổ làm việc, biểu đồ hoặc bảng điều khiển mà người khác có thể xem xét.
Một bài kiểm tra phân tích dữ liệu Plotly độc lập cung cấp một ví dụ về nhiệm vụ thực tế hữu ích. Astra đã vượt qua 41 trong số 43 câu hỏi, phát hiện tất cả các vấn đề về chất lượng dữ liệu được cài cắm, tránh được cả năm bẫy thống kê và hoàn thành quá trình chạy với giá 4,11 đô la. Câu hỏi trung bình của nó mất 12,4 giây, so với 26,9 giây đối với GPT-6 Astra. Sự đánh đổi rất quan trọng: nó đã bỏ lỡ hai mẫu ẩn và GPT-6.1 Sol đã đạt điểm tuyệt đối trong bài kiểm tra đó với giá 2,61 đô la. Astra nhanh và có năng lực, nhưng không tự động trở thành lựa chọn rẻ nhất hoặc chính xác nhất.
Ví dụ định giá Alderfen của OpenAI cho thấy khía cạnh tài liệu của cùng một khả năng đó. Astra đã xây dựng một sổ làm việc DCF có thể chỉnh sửa để dự báo doanh thu đến năm 2031, đối chiếu ba báo cáo tài chính, tính toán giá trị trên mỗi cổ phiếu và đặt các trình điều khiển chính bên cạnh bảng độ nhạy. Hãy coi đây là bản demo của nhà cung cấp, không phải bằng chứng độc lập. Đây vẫn là một mẫu hữu ích cho một bài kiểm tra mà bạn có thể tái tạo bằng bảng tính của riêng mình.
Tài chính, kế toán, pháp lý và các tài liệu chuyên môn
GPT-6.2 Astra được huấn luyện để tuân thủ các quy chuẩn chuyên môn trong slide, bảng tính, bản ghi nhớ và tài liệu. OpenAI báo cáo những cải thiện trong các quy trình làm việc về tài chính, kế toán, tư vấn, bán hàng và pháp lý. Kết quả của khách hàng trên trang ra mắt bao gồm việc giảm số vòng đánh giá cho các ứng dụng, bảng điều khiển và slide, cũng như rút ngắn thời gian hoàn thành cho các công việc kế toán dài hạn. Đây là những kết quả do nhà cung cấp lựa chọn, vì vậy chúng nên được hiểu là các trường hợp sử dụng đầy hứa hẹn thay vì những kết quả được đảm bảo.
Các ứng dụng tốt nhất là những kết quả có thể kiểm chứng:
Một mô hình tài chính có các công thức đối chiếu và phản hồi chính xác khi các giả định thay đổi.
Một bản ghi nhớ pháp lý có các tuyên bố có thể truy xuất nguồn gốc từ các cơ quan có thẩm quyền và tài liệu nguồn được cung cấp.
Một bộ slide tuân theo mẫu có sẵn và biến mỗi tiêu đề thành một kết luận được hỗ trợ.
Một trình theo dõi tuân thủ ánh xạ mọi yêu cầu tới bằng chứng, người chịu trách nhiệm và trạng thái.
Các bằng chứng độc lập cho thấy kết quả kém khả quan hơn đối với các công việc mở. Trong đánh giá thực tế tại nơi làm việc của Epoch AI, không có mô hình nào được thử nghiệm đạt tiêu chuẩn nhân viên của Epoch trong bất kỳ nhiệm vụ nào. GPT-6.2 Astra đạt trung bình 65%, thấp hơn 17 điểm so với Claude Fable 5.2. Epoch nhận thấy rằng Astra đã cải thiện so với GPT-6 Astra trong việc viết súc tích, thiết kế đồ họa và nghiên cứu trung tâm dữ liệu, nhưng có thể quá thận trọng và bỏ qua các kết luận mà bằng chứng sẵn có đã hỗ trợ.
Sự mâu thuẫn rõ ràng đó chính là vấn đề. Astra có thể rất mạnh khi các tiêu chí và đầu ra là rõ ràng. Khi công việc đòi hỏi phải quyết định điều gì là quan trọng, đưa ra các giả định đã được hiệu chỉnh và lặp lại trên một kế hoạch nghiên cứu không chắc chắn, thì việc lựa chọn mô hình và sự giám sát của con người trở nên quan trọng hơn.
Phân tích khoa học và nghiên cứu kỹ thuật
OpenAI định vị khoa học là trường hợp sử dụng hàng đầu của Astra và báo cáo kết quả dẫn đầu về các quy trình khoa học dựa trên terminal. Một tín hiệu sớm khác từ người dùng đến từ nhà nghiên cứu y sinh Derya Unutmaz, người ưu tiên Astra cho khoa học và lập trình mục tiêu dài hạn, trong khi vẫn thích Opus 5.5 hơn về tư duy thiết kế và trí tuệ cảm xúc. Ông cũng mô tả trải nghiệm nghiên cứu y sinh của riêng mình với Astra là rất mạnh mẽ.
Điều này không có nghĩa là Astra có thể độc lập tạo ra nghiên cứu sẵn sàng để xuất bản. Đánh giá của Epoch cho thấy các mô hình tiên phong vẫn tái sử dụng các ý tưởng hiện có, dựa quá nhiều vào các nỗ lực ban đầu và gặp khó khăn trong việc xác định các phát hiện quan trọng nhất. Hãy sử dụng Astra để tìm kiếm, phân tích mã, so sánh các nguồn, kiểm tra một giả thuyết đã nêu hoặc thách thức một bản nháp. Đừng coi một câu chuyện nghiên cứu đầy tự tin là sự xác thực.
CAD, mô phỏng, thiết kế 3D và nguyên mẫu trực quan
Ở đây, các ví dụ ra mắt thú vị hơn các trò chơi. OpenAI đã trình diễn Astra mô hình hóa các thành phần phương tiện, viết trình giải Python cho động lực học khung gầm, tạo hoạt ảnh cho kết quả trong Blender và tạo hướng dẫn lắp ráp cũng như danh mục phụ tùng cho một chiếc xe buggy điều khiển từ xa. Những ví dụ này kết hợp tư duy trực quan, mã, sử dụng máy tính và tài liệu vào một quy trình làm việc duy nhất.
Sự kết hợp đó có thể hỗ trợ việc khám phá kỹ thuật sớm: biến hình ảnh tham chiếu và hướng dẫn sử dụng thành một mô hình có thể chỉnh sửa, kiểm tra bản sửa đổi trong mô phỏng và tạo giải thích trực quan cho người đánh giá. Một thiết kế vật lý vẫn cần sự xác thực về mặt kỹ thuật. Một hoạt ảnh hợp lý không phải là bằng chứng cho thấy tải trọng, dung sai, vật liệu hoặc các yêu cầu an toàn là chính xác.
GPT-6.2 Astra có thể xây dựng trò chơi không?
Có. Meridian Sound Racing là một bản demo có thể chơi được trên trình duyệt, và dự án thang máy không gian của Ethan Mollick đã kết hợp Blender, Unity, trải nghiệm trên trình duyệt và mô phỏng vật lý không trọng lực.
Nhưng “có thể xây dựng một trò chơi” không phải là bản tóm tắt tốt nhất về Astra. Những dự án này là bằng chứng cho thấy mô hình có thể điều phối mã nguồn, tài sản 3D, công cụ và tương tác trên một bản dựng lớn. Những khả năng tương tự cũng hữu ích cho các mô phỏng, trải nghiệm đào tạo, bản sao kỹ thuật số (digital twins), trình cấu hình sản phẩm và các câu chuyện dữ liệu tương tác.
Tính nhất quán trong sáng tạo cũng cần được kiểm tra. Những người dùng đầu tiên báo cáo rằng mô hình có bản năng thị giác mặc định mạnh mẽ nhưng các mẫu thiết kế bị lặp lại và khả năng kiểm soát phong cách còn yếu. Hãy cung cấp cho Astra tài liệu tham khảo về hình ảnh, kiểu chữ, đối tượng mục tiêu, quy tắc tương tác và các mục tiêu không mong muốn một cách rõ ràng. Sau đó, hãy đánh giá bản sửa đổi thứ hai, đừng chỉ nhìn vào ảnh chụp màn hình đầu tiên.
Cách để đạt kết quả tốt hơn từ GPT-6.2 Astra
Các phản hồi từ cộng đồng cho thấy Astra cần một bản tóm tắt vận hành rõ ràng hơn là một lời nhắc (prompt) trò chuyện thông thường. Hướng dẫn của OpenAI cũng cảnh báo rằng mô hình có thể đề xuất bước tiếp theo và chờ đợi khi ý định không rõ ràng.
Hãy sử dụng cấu trúc lời nhắc như sau:
Mục tiêu:
Hoàn thành [sản phẩm bàn giao cụ thể].

Hoàn thành khi:

1. [Kiểm tra chấp nhận]

2. [Kiểm thử hoặc bằng chứng]

3. [Định dạng đầu ra bắt buộc]

Quyền tự chủ:
Đưa ra các giả định hợp lý, có thể đảo ngược và tiếp tục mà không cần chờ đợi.
Chỉ hỏi nếu một quyết định có thể thay đổi đáng kể kết quả hoặc gây ra hành động không thể đảo ngược.

Ràng buộc:

- Bảo toàn [hành vi hoặc phong cách hiện có].

- Không thay đổi [khu vực ngoài phạm vi].

- Sử dụng [công cụ, tệp, nguồn hoặc quy ước].

Xác minh:
Chạy [các bài kiểm tra hoặc kiểm tra]. Báo cáo rõ ràng bất kỳ tệp nào bị thiếu, công cụ bị lỗi, giả định không được hỗ trợ hoặc bước chưa hoàn thành.

Bàn giao cuối cùng:
Tóm tắt những gì đã thay đổi, những gì đã được xác minh, các rủi ro còn lại và tổng mức sử dụng/chi phí.
Đối với công việc API nhiều lượt, hãy giữ nguyên tiền tố lời nhắc trước đó và thêm các hướng dẫn mới. OpenAI cho biết điều này giúp bảo toàn khả năng suy luận và cải thiện việc tái sử dụng bộ nhớ đệm lời nhắc. Đối với công việc giao diện người dùng hoặc hình ảnh, hãy cung cấp tài liệu tham khảo thực tế và nêu tên kiểu chữ cũng như hình ảnh bạn muốn. “Làm cho nó hiện đại” không phải là một hệ thống thiết kế.
GPT-6.2 Astra có chi phí bao nhiêu cho mỗi tác vụ?
Các mức giá này được tính bằng USD trên mỗi triệu token cho các yêu cầu lên đến 272.000 token đầu vào. Các hàng GPT Proto áp dụng mức giảm giá 20% hiện tại so với mức giá tiêu chuẩn của OpenAI.
Đối với một yêu cầu với 20.000 token đầu vào không lưu bộ nhớ đệm và 5.000 token đầu ra được tính phí, mức phí token tiêu chuẩn sẽ là $0.36 trên GPT-6.2 Astra, $0.45 trên GPT-6 Astra, và $0.09 trên GPT-6.2 Sol. Theo mức giá hiện tại của GPT Proto, cùng số lượng token đó có chi phí là $0.288 trên Astra hoặc $0.072 trên Sol. Một tác vụ đại lý thực tế có thể thực hiện các lệnh gọi mô hình lặp lại, sử dụng lại ngữ cảnh đã lưu, thử lại các công cụ bị lỗi hoặc tạo ra kết quả dài hơn nhiều.
Với hơn 272.000 token đầu vào trong một yêu cầu, tỷ lệ đầu vào và bộ nhớ đệm của Astra sẽ tăng gấp đôi và chi phí đầu ra gấp 1,5 lần so với tỷ lệ ngữ cảnh ngắn cho toàn bộ yêu cầu. Cửa sổ ngữ cảnh 1,05 triệu là hữu ích, nhưng việc lấp đầy nó một cách tùy tiện có thể tạo ra hóa đơn lớn. Hãy đo lường chi phí cho mỗi tác vụ hoàn thành, không chỉ giá trên mỗi triệu token.
Quá trình chạy Plotly đưa ra một ví dụ cụ thể: 43 câu hỏi phân tích có chi phí 4,11 đô la trên GPT-6.2 Astra, so với 19,97 đô la trên GPT-6 Astra. Tuy nhiên, GPT-6.2 Sol chỉ tốn 1,22 đô la và chỉ hoàn thành ít hơn một câu hỏi. Bản nâng cấp của Astra là có thật; mô hình rẻ hơn vẫn có thể mang lại hiệu quả kinh tế tốt hơn cho lưu lượng sản xuất thông thường.
Cả hai lộ trình giảm giá hiện đã hoạt động. Hãy kiểm tra trang mô hình GPT-6.2 Astra hoặc trang mô hình GPT-6.2 Sol để biết ID mô hình và định dạng yêu cầu hiện tại trước khi gửi lưu lượng sản xuất. Bộ sưu tập mô hình OpenAI liệt kê các mô hình OpenAI còn lại hiện có.
GPT-6.2 Astra có tốt hơn Claude Fable 5.2 không?
Không phải trong mọi loại công việc.
OpenAI báo cáo rằng Astra có tỷ lệ vượt qua nghiêm ngặt cao gấp đôi Fable 5.2 trong một bài kiểm tra dành cho tác nhân pháp lý với chi phí chỉ bằng khoảng một phần sáu. Tuy nhiên, trong Cognition’s FrontierCode 2.0, Fable 5.2 đạt điểm cao hơn về các thay đổi đối với cơ sở mã hiện có. Đánh giá nơi làm việc mở của Epoch cũng ưu tiên Fable 5.2 hơn 17 điểm.
| Chọn GPT-6.2 Astra khi… |
Chọn Claude Fable 5.2 khi… |
| Đánh giá mã, gỡ lỗi, sử dụng công cụ hoặc các sản phẩm kỹ thuật có thể kiểm chứng là trọng tâm |
Nhiệm vụ mang tính mở và đòi hỏi khả năng phán đoán mạnh mẽ về những gì quan trọng |
| Bạn cần các quy trình làm việc về CAD, mô phỏng, 3D hoặc sử dụng máy tính |
Phong cách cộng tác và các giải thích dài dòng dễ đọc quan trọng hơn |
| Chi phí cho các tác vụ lặp lại và hiệu quả bộ nhớ đệm là quan trọng |
Các bài kiểm tra đại diện của riêng bạn cho thấy ít sự can thiệp hơn hoặc hoàn thành tốt hơn |
| Bạn muốn một mô hình thứ hai để xem xét công việc của một tác nhân khác |
Bạn muốn một mô hình thứ hai để thách thức các giả định và bản vá của Astra |
Câu trả lời thực tế nhất có thể là sử dụng cả hai. Quy trình đánh giá chéo sớm được mô tả bởi Tibor Blaho đáng tin cậy hơn là tuyên bố một người chiến thắng chung cuộc: hãy để một mô hình thực hiện hoặc nghiên cứu, sau đó để mô hình kia tìm kiếm các lỗi bị bỏ sót và các giả định không được hỗ trợ.
Để có một sự so sánh sáng tạo, hãy sử dụng lại bản tóm tắt màu nước tương tác từ bài kiểm tra Claude Fable 5.2 của chúng tôi. Cung cấp cho cả hai mô hình cùng một dự án hiện có và yêu cầu một điều khiển mới mà không làm hỏng các điều khiển hiện tại. So sánh độ chính xác ở lần thử đầu tiên, số lần sửa đổi, chất lượng giải thích, tổng số token và chi phí hoàn thành tác vụ. Bạn có thể tìm thấy quyền truy cập Fable trên trang API Claude Fable 5.2.
Bạn có thể sử dụng GPT-6.2 Astra ở đâu?
ChatGPT Work: GPT-6.2 Astra khả dụng trong Work thay vì ChatGPT Chat thông thường. Quyền truy cập phụ thuộc vào gói dịch vụ, cài đặt không gian làm việc và trạng thái triển khai.
Codex: Có. Hãy chọn Astra trong ứng dụng Codex hoặc sử dụng /model trong CLI. Đây là tùy chọn được OpenAI khuyến nghị để truy vết các lỗi khó trên các dịch vụ và hoàn tất việc sửa lỗi cũng như kiểm thử.
Claude Code: Không có tùy chọn GPT-6.2 Astra gốc. Tài liệu về cổng LLM của Anthropic cho biết việc định tuyến Claude Code đến các mô hình không phải của Claude thông qua cổng kết nối nằm ngoài phạm vi hỗ trợ của họ.
OpenAI API: Sử dụng ID mô hình chính thức gpt-6.2-astra. OpenAI khuyến nghị sử dụng Responses API cho các quy trình làm việc cần gọi công cụ.
GPT Proto: Cả GPT-6.2 Astra và GPT-6.2 Sol đều đang hoạt động với mức giá thấp hơn 20% so với giá token API tiêu chuẩn của OpenAI. Hãy chọn Astra cho các tác vụ suy luận phức tạp và các sản phẩm chuyên nghiệp cần kiểm chứng; chọn Sol cho các công việc lập trình, viết lách thông thường và khối lượng công việc lớn hơn. Lộ trình triển khai GPT-6.2 Astra trước đó ghi lại các lần xuất hiện của Codex trước khi ra mắt.
Yêu cầu sau đây sử dụng ID mô hình Astra đang hoạt động. Bạn có thể sao chép đoạn mã tích hợp mới nhất trực tiếp từ trang mô hình của nó.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  --header "Authorization: Bearer ${GPTPROTO_API_KEY}" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.2-astra",
    "messages": [
      {
        "role": "user",
        "content": "We sold 12 units at $25 each. Each unit cost $10. Return revenue and gross profit in USD as JSON using the keys revenue and gross_profit."
      }
    ]
  }'
Doanh thu sẽ là $300 và lợi nhuận gộp sẽ là $180. Đối với các tác vụ thông thường rẻ hơn, hãy chuyển sang ID mô hình chính xác được hiển thị trên trang GPT-6.2 Sol. Bạn cũng có thể duyệt qua bộ sưu tập mô hình OpenAI để xem các mô hình khả dụng khác.
Kết luận
Ưu điểm thuyết phục nhất của GPT-6.2 Astra không phải là khả năng xây dựng trò chơi. Đó là khả năng kết hợp suy luận, mã nguồn, công cụ, tệp tin và việc sử dụng máy tính vào các công việc có kết quả đo lường được: một lỗi được sửa và kiểm thử, một quá trình di chuyển dữ liệu được xây dựng sạch sẽ, một bảng tính được đối soát, hoặc một phân tích làm rõ các giả định của nó.
Hạn chế cũng thực tế không kém. Những người dùng đầu tiên liên tục mô tả một mô hình có thể rất xuất sắc trong tác vụ nhưng vẫn khó điều hướng hoặc khó hiểu trong quá trình chạy dài. Hãy sử dụng Sol cho công việc thường ngày. Sử dụng Astra khi công việc đủ khó để xứng đáng với nó, xác định rõ ràng thế nào là “hoàn thành”, xác minh kết quả và so sánh nó với Fable 5.2 trên các tác vụ mà khả năng đánh giá nghiên cứu và phong cách cộng tác là quan trọng.