Tổng quan về Qwen 4 Max: Từ bài kiểm tra mù "Qoduck" đến bản xem trước 14 ngày
Nếu bạn muốn có cái nhìn tổng quan thực tế về Qwen 4 Max, hãy bắt đầu với bốn ngày trước khi tên của nó được công bố. Từ ngày 7 tháng 11 đến ngày 10 tháng 11 năm 2026, một mô hình ẩn danh có tên mã là Qoduck đã xuất hiện bên trong Qoder, một IDE lập trình có khả năng tự vận hành (agentic). Các nhà phát triển thử nghiệm Qoduck đã nhận thấy một mô hình bất thường: thay vì trả về một đoạn mã nhanh trong một lần thực thi và chờ phản hồi từ con người, mô hình này dành từ mười đến mười lăm phút để khởi chạy các kiểm tra shell, tự viết các tài nguyên SVG từ đầu và chạy các bài kiểm tra đơn vị (unit test) dựa trên các thay đổi (diff) của chính nó trước khi đưa ra câu trả lời cuối cùng.
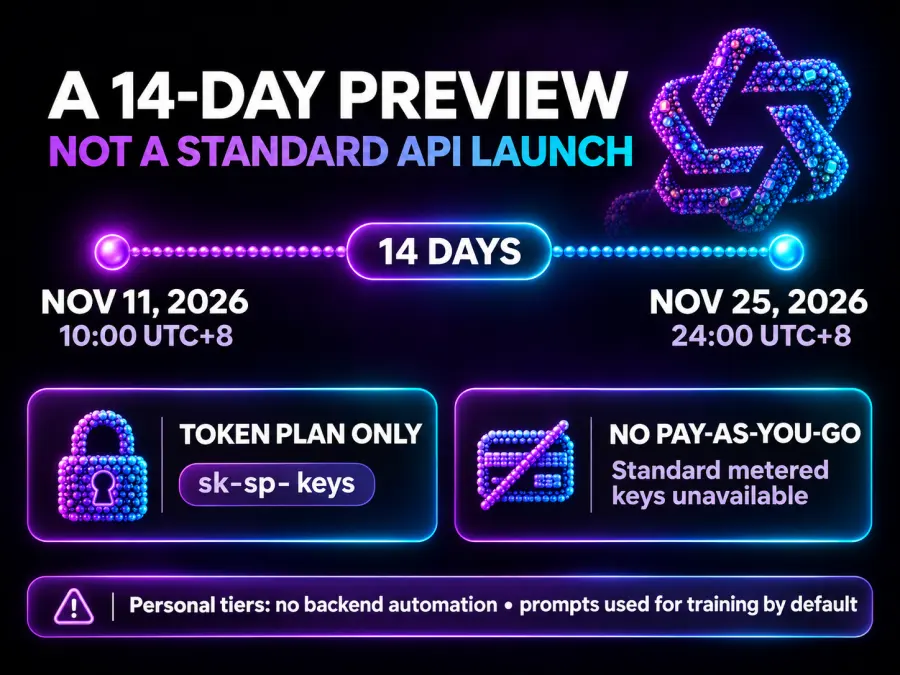
Vào ngày 11 tháng 11 năm 2026 lúc 10:00 UTC+8, Alibaba xác nhận rằng Qoduck chính là mô hình mới nhất của Qwen, Qwen 4 Max, và công bố nó trên Alibaba Cloud Model Studio dưới chuỗi mô hình qwen4-max-preview (được tham chiếu là qwen4.0-max-preview trong một số cấu hình máy khách nhất định). Thay vì tổ chức một đợt ra mắt thương mại đầy đủ với bảng giá theo token, Alibaba đã định hình đợt triển khai này—thường được mô tả trong tài liệu dành cho nhà phát triển là giới thiệu Qwen 4 Max thông qua bản xem trước 14 ngày—được thiết kế để kiểm tra áp lực các quy trình làm việc tự vận hành bên trong các công cụ dành cho nhà phát triển như Claude Code, Cursor, Cline và Qoder.
| Thông số kỹ thuật |
Trạng thái xác nhận (qwen4-max-preview) |
Nguồn / Ghi chú kỹ thuật |
| ID mô hình chính thức |
qwen4-max-preview |
Tài liệu Alibaba Cloud Model Studio / Bailian |
| Thời gian xem trước |
11 tháng 11, 2026 (10:00) – 25 tháng 11, 2026 (24:00 UTC+8) |
Bản xem trước giới hạn nghiêm ngặt trong 14 ngày |
| Cửa sổ ngữ cảnh |
1.000.000 token (đầu vào tối đa: 967.000 token) |
Đã xác minh qua tài liệu CN và Quốc tế |
| Token đầu ra tối đa |
Tổng 393.216 (131.072 đầu ra cuối cùng + 262.144 suy luận) |
max_tokens giới hạn kết hợp tư duy + đầu ra |
| Phương thức đầu vào / đầu ra |
Đầu vào: Văn bản, Hình ảnh, Video · Đầu ra: Văn bản |
Không hỗ trợ đầu vào âm thanh gốc trên lộ trình xem trước |
| Kiểm soát suy luận |
reasoning_effort: low, medium, xhigh |
Chế độ tư duy (Thinking) được bật theo mặc định; mặc định là xhigh |
| Các giao thức API được hỗ trợ |
OpenAI Chat Completions, Responses API, Anthropic Messages |
Yêu cầu endpoint Gói Token sk-sp- chuyên dụng |
| Kích thước tham số & Trọng số |
Không tiết lộ (Bản xem trước thương mại đóng) |
Các con số 2.4T / 95B trên mạng thuộc về Qwen3.8-Max |
| Bảng điểm chuẩn chính thức |
Chưa được công bố tại thời điểm ra mắt bản xem trước |
Điểm số GameFeel 49.9 đang lưu hành là của Qwen-4-Flash-Early |
Việc hiểu qwen 4 max được giải thích như một bước tiến thế hệ phụ thuộc vào cách nó sử dụng tài nguyên tính toán tại thời điểm suy luận. Trong khi các phiên bản trước coi việc gọi công cụ là một tính năng hỗ trợ tùy chọn, thì bản nâng cấp cốt lõi qwen 4 max tích hợp sẵn một vòng lặp tự xác minh vào quy trình suy luận mặc định. Khi được yêu cầu xây dựng một ứng dụng web hoặc vá một tiện ích dòng lệnh, mô hình thường xuyên thực hiện chuỗi hàng chục lệnh gọi công cụ—kiểm tra cây thư mục, chạy pytest hoặc trình duyệt không giao diện cục bộ, tự phát hiện các lỗi cú pháp hoặc bố cục của chính nó, và viết lại các dòng bị lỗi trước khi người dùng nhìn thấy kết quả.
Kiến trúc, Quy mô mô hình và Thực tế về điểm chuẩn
Hai thông tin sai lệch hiện đang thống trị kết quả tìm kiếm cho qwen 4 max size và qwen 4 max benchmark. Làm rõ những điều này là cách nhanh nhất để hiểu những gì Alibaba thực sự đã phát hành và những gì vẫn chưa được công bố.
Thứ nhất, Alibaba chưa tiết lộ tổng số tham số hoặc số tham số hoạt động cho alibaba qwen 4 max. Một số blog của bên thứ ba liệt kê đây là mô hình Mixture-of-Experts (MoE) với 2,4 nghìn tỷ tham số và 95 tỷ tham số hoạt động trên mỗi token. Những con số chính xác đó thuộc về phiên bản hàng đầu trước đây, Qwen3.8-Max, được phát hành vào tháng 9 năm 2026. Mặc dù Qwen 4 Max gần như chắc chắn sử dụng nền tảng MoE thưa thớt để phục vụ cửa sổ ngữ cảnh 1 triệu token một cách kinh tế, bất kỳ con số nghìn tỷ tham số cụ thể nào bạn đọc được vào tháng 11 năm 2026 đều là thông tin chưa được xác minh từ thế hệ 3.8.
Những gì chúng ta có về khía cạnh kiến trúc đến từ bản phát hành kỹ thuật tháng 8 năm 2026 của Alibaba về Qwen3.8-Flash-Next, mà nhóm Qwen đã chỉ định rõ ràng là môi trường thử nghiệm để xác thực các nâng cấp kiến trúc cốt lõi cho dòng Qwen 4. Báo cáo tiền thân đó đã ghi lại bốn thay đổi cấu trúc giải thích cách qwen4-max-preview xử lý khối lượng công việc hàng triệu token:
Hybrid GDN + QSA Attention: Kết hợp các lớp chú ý tuyến tính Gated DeltaNet (GDN) với Qwen Sparse Attention (QSA) giúp giảm độ trễ tiền xử lý thời gian đến token đầu tiên (TTFT) trên ngữ cảnh 1.000.000 token lên tới 7,6 lần so với cơ chế chú ý đầy đủ tiêu chuẩn.
4-Stream Gated Residual Connections: Mở rộng chiều rộng luồng dư với các cổng đã học giúp cải thiện luồng gradient và định tuyến tính năng giữa các lớp trong quá trình suy luận đa bước chuyên sâu.
N-gram Embedding Layers: Việc đưa ngữ cảnh cục bộ đa token trực tiếp vào giai đoạn nhúng giúp giảm tải việc khớp mẫu từ vựng từ các khối chú ý ban đầu.
Muon Optimizer Training: Chuyển đổi tối ưu hóa tiền huấn luyện quy mô lớn sang Muon đã cải thiện hiệu quả lấy mẫu trên các tập dữ liệu mã nguồn và logic hình thức.
Thứ hai, nếu bạn tìm kiếm kết quả qwen 4 max benchmark, bạn có thể sẽ bắt gặp các tuyên bố rằng Qwen 4 Max đạt 49,9 điểm trên GameFeel Bench v1.4, vượt qua Claude Opus 5.5 với 47,2 điểm. Tôi đã kiểm tra bảng xếp hạng và các nhật ký commit cơ bản: số điểm 49,9 đó được ghi lại bởi một checkpoint thử nghiệm nhẹ, sớm có tên là Qwen-4-Flash-Early (tên mã nội bộ hawk), không phải qwen4-max-preview. Tính đến ngày 13 tháng 11 năm 2026, Alibaba chưa công bố bảng xếp hạng MMLU-Pro, SWE-bench Verified hoặc AIME chính thức cho Qwen 4 Max.
Điều bạn có thể xác minh ngay bây giờ là cơ chế của qwen 4 max context window và ngân sách đầu ra của nó—và đây là nơi các nhà phát triển di chuyển gặp khó khăn. Trong khi cửa sổ ngữ cảnh chứa 1.000.000 token (với giới hạn nhắc nhở được ghi nhận là 967.000 token), đầu ra tối đa được liệt kê là 393.216 token trên cổng thông tin quốc tế và được chia nhỏ trên cổng thông tin nội địa là 262.144 token suy luận cộng với 131.072 token câu trả lời cuối cùng.
Đây là điểm cần lưu ý: tham số API max_tokens trong qwen4-max-preview kiểm soát sum của reasoning_content và content. Vì mô hình mặc định sử dụng reasoning_effort: "xhigh" (mức cao nhất trong ba cài đặt khả dụng: low, medium, và xhigh), một câu lệnh lập trình phức tạp có thể dễ dàng tiêu tốn từ 15.000 đến 40.000 token trong khối suy luận ẩn. Nếu mã client hiện tại của bạn truyền max_tokens: 4096 hoặc 8192, mô hình sẽ sử dụng hết hạn mức ngay khi đang suy luận và trả về một chuỗi content trống. Để tránh việc bị cắt ngắn dữ liệu mà không có thông báo, hãy tăng max_tokens lên trên 65.536 hoặc chủ động hạ reasoning_effort xuống medium cho các tác vụ thông thường.
Đánh giá thực tế Qwen 4 Max: Những gì các thử nghiệm từ cộng đồng và truyền thông thực sự cho thấy
Vì Alibaba đã bỏ qua việc phát hành thông cáo báo chí về các điểm chuẩn truyền thống, dữ liệu đánh giá qwen 4 max đáng tin cậy nhất đến từ các đội ngũ kỹ thuật đã tích hợp qwen4-max-preview vào các hệ thống tác nhân trực tiếp trong 48 giờ đầu tiên của bản xem trước. Nhật ký của họ cho thấy một mô hình rõ ràng: mỗi bước nhảy vọt về chất lượng đầu ra đều đi kèm với độ trễ và chi phí token đáng chú ý.
Vào ngày 11 tháng 11, công ty tư vấn AI Nhật Bản WEEL đã công bố một bài đánh giá gồm ba phần, thử nghiệm mô hình xem trước trên các tác vụ tổng hợp giao diện người dùng, nghiên cứu đa nguồn và gỡ lỗi ở cấp độ kho lưu trữ bên trong Claude Code:
Trang đích SVG tùy chỉnh 908 dòng (so với Qwen 3.8 Max): Với cùng một yêu cầu để xây dựng một trang đích phản hồi cho một phòng khám vật lý trị liệu theo chủ đề lâm nghiệp, Qwen3.8-Max đã hoàn thành trong khoảng 9,5 phút nhưng lại lấy các ảnh stock bên ngoài ngẫu nhiên khiến lưới bị vỡ hoặc không tải được. qwen4-max-preview mất khoảng 17 phút—gần gấp đôi thời gian. Thay vì liên kết các URL bên ngoài thiếu ổn định, nó đã gọi Trình thông dịch mã (Code Interpreter) hàng chục lần trong nền để lập trình vẽ các hình minh họa SVG tùy chỉnh về tán rừng, kiến trúc phòng khám và các biểu tượng nhân viên, tạo ra một tệp HTML 908 dòng mà không có tài nguyên nào bị lỗi.
Gỡ lỗi CLI tự động trong Claude Code (Vượt qua 36/36 bài kiểm tra): WEEL đã hướng Claude Code (được hỗ trợ bởi qwen4-max-preview thông qua điểm cuối tương thích với Anthropic) vào một CLI quản lý chi tiêu hộ gia đình bằng Python cục bộ (kakeibo) và yêu cầu nó thêm các cờ lọc --export-csv và --month cùng với các bài kiểm tra đơn vị. Quá trình chạy mất 11 phút 48 giây. Sau khi viết bản triển khai ban đầu, mô hình đã chạy pytest, phát hiện 2 bài kiểm tra thất bại—bao gồm một trường hợp biên nơi một chuỗi tiền tệ âm như -100日元 bị argparse của Python hiểu nhầm là một cờ dòng lệnh—và đã tự sửa trình phân tích cú pháp. Không cần nhắc nhở, nó cũng tự thêm tiêu đề BOM utf-8-sig để các ký tự tiếng Nhật không bị lỗi hiển thị trong Microsoft Excel và thoát các ký tự đầu dòng =, +, - và @ để chặn việc tiêm công thức CSV. Tất cả 36 bài kiểm tra đều vượt qua, chỉ tiêu tốn 0,4% hạn ngạch gói Lite hàng tháng.
Nghiên cứu chính sách tự xác minh: Được giao nhiệm vụ biên soạn bảng so sánh trợ cấp SME Nhật Bản năm 2026, mô hình đã dành 2 phút để chạy hơn một chục truy vấn web trên các cổng thông tin của bộ và 5 phút khác để chạy grep và các tập lệnh xác thực Python để đảm bảo không có cột bảng Markdown nào bị lệch trước khi trình bày kết quả trong 8 phút.
Hai ngày sau, vào ngày 13 tháng 11, ấn phẩm công nghệ Trung Quốc Silicon Star (GuiXingRen) đã thực hiện một thử thách kỹ thuật hình ảnh và 3D đối với qwen4-max-preview. Khi được yêu cầu tạo hoạt ảnh SVG kinh điển "bồ nông đi xe đạp", mô hình đã thể hiện rõ nét nhịp đạp và bóng cây đổ theo hiệu ứng thị sai, đồng thời tự động thêm thanh trượt tốc độ 0,5x–1,75x và bộ chuyển đổi chủ đề ngày/hoàng hôn/đêm. Trong một bài kiểm tra Three.js khó hơn—xây dựng một trò chơi máy bay giấy 3D có thể chơi được tên là Paper Skies nơi máy bay bay qua cửa sổ phòng ngủ vào khu vườn—các nhà đánh giá lưu ý rằng vật lý và khả năng xử lý chướng ngại vật của nó ngang ngửa với Claude Fable 5.1 tập trung vào sáng tạo của Anthropic, mặc dù vẫn còn kém hơn Claude Fable 5.2 mới hơn về độ bóng bẩy của shader. Khi được yêu cầu thiết kế lại trang chủ phản hồi của chính Silicon Star, mô hình đã khởi chạy trình duyệt cục bộ, phát hiện ra rằng các hình thu nhỏ bài viết bên ngoài đang trả về lỗi hotlink 403, tự động thay thế chúng bằng các trình giữ chỗ gradient SVG được tạo kiểu và hoàn thành vòng sửa đổi bố cục biên tập thứ hai trong 5 phút.
Phản hồi của các nhà phát triển trên X (trước đây là Twitter) và các diễn đàn nhà phát triển tại Nhật Bản đã bổ sung những sắc thái quan trọng cho mọi điểm nổi bật về tính năng qwen 4 max. Nhà phát triển @round_boys đã trình diễn khả năng mô hình kết xuất một cảnh 3D hoàn chỉnh bằng Java và Three.js chỉ trong một lần chạy, nhưng lưu ý rằng quá trình này tiêu tốn khoảng 69.000 token. Những người dùng sớm khác khi đo lường thông lượng thô đã báo cáo tốc độ truyền phát đạt khoảng 33 token mỗi giây ở cài đặt mặc định xhigh, đồng thời nhận xét rằng các quỹ đạo sử dụng công cụ học tăng cường (RL) của nó đôi khi suy nghĩ quá mức đối với các thao tác đọc tệp đơn giản—một lời nhắc nhở rằng hậu tố -preview mang ý nghĩa đúng như tên gọi.
Giá cả, Quy tắc Gói Token và Các rào cản sản xuất của Qwen 4 Max
Nếu bạn tìm kiếm giá cả qwen 4 max với kỳ vọng về một bảng giá tiêu chuẩn "$X trên mỗi triệu token đầu vào", bạn sẽ không tìm thấy đâu. Alibaba không cung cấp hình thức thanh toán theo mức sử dụng (pay-as-you-go) cho qwen4-max-preview. Cách duy nhất để gửi yêu cầu là thông qua gói đăng ký Alibaba Cloud Model Studio Token Plan đang hoạt động (trước đây gọi là Coding Plan), gói này tính phí theo "Tín dụng" (Credits) hàng tháng thay vì tính theo đô la trên mỗi token.
Trên cổng thông tin QwenCloud quốc tế, Gói Token được chia thành các cấp độ cá nhân và nhóm:
Gói Lite (3 đô la cho tháng đầu tiên đối với người dùng mới): Bao gồm 20.000 Tín dụng mỗi tháng, được quản lý bởi giới hạn luân phiên nghiêm ngặt là 1.200 Tín dụng mỗi khoảng thời gian 5 giờ và 9.000 Tín dụng mỗi tuần.
Gói Pro (15 đô la cho tháng đầu tiên): Bao gồm 100.000 Tín dụng mỗi tháng, giới hạn ở mức 6.000 Tín dụng mỗi khoảng thời gian 5 giờ và 45.000 Tín dụng mỗi tuần. (Trên cổng thông tin nội địa Trung Quốc của Alibaba, gói Lite và Pro có giá niêm yết lần lượt là 39 RMB và 199 RMB mỗi tháng, với chương trình khuyến mãi giảm giá một nửa cho tháng đầu tiên còn 19,5 RMB và 99,5 RMB.)
Ưu đãi dùng thử 14 ngày (11/11–25/11/2026): Trong thời gian dùng thử hai tuần, các cuộc gọi vào ban ngày (08:00–22:00 UTC+8) chỉ tiêu tốn 20% trọng số Tín dụng tiêu chuẩn, trong khi các cuộc gọi ngoài giờ vào ban đêm (22:00–08:00 UTC+8) được giảm thêm 80% trên mức đó—giảm mức tiêu thụ Tín dụng thực tế xuống chỉ còn 4% so với mức thông thường.
Đối với một lập trình viên cá nhân đang mày mò trong IDE vào ban đêm với mức giá 3 đô la, thì bài toán khuyến mãi này rất khó để đánh bại. Tuy nhiên, đối với một đội ngũ kỹ thuật đang xây dựng sản phẩm hoặc vận hành các tác nhân CI/CD tự động, Gói Token lại tạo ra ba rào cản sản xuất nghiêm trọng:
Cấm tự động hóa backend và tích hợp API: Các điều khoản Gói Token của Alibaba hạn chế rõ ràng các khóa Lite và Pro cá nhân (sk-sp-) chỉ được sử dụng cho việc lập trình tương tác do con người kích hoạt bên trong các plugin IDE được hỗ trợ. Việc sử dụng khóa đăng ký để vận hành tập lệnh backend tự động, tính năng SaaS hướng tới khách hàng hoặc đường ống dữ liệu hàng loạt sẽ vi phạm điều khoản dịch vụ và dẫn đến việc bị đình chỉ tài khoản.
Đào tạo dữ liệu bắt buộc trên các gói cá nhân: Theo quy tắc Gói Token, các gói đăng ký Lite và Pro cá nhân mặc định đưa tất cả các câu lệnh (prompt), ngữ cảnh kho lưu trữ và kết quả hoàn thiện của mô hình vào chương trình cải thiện đào tạo mô hình của Alibaba—và không có tùy chọn để từ chối. Chỉ có Gói Team dành cho doanh nghiệp (40 đô la mỗi chỗ/tháng) mới cung cấp cam kết không lưu giữ dữ liệu / không đào tạo.
Giới hạn tốc độ luân phiên 5 giờ và thời điểm kết thúc ngày 25 tháng 11: Ngay cả khi quy trình làm việc của bạn hoàn toàn nội bộ, giới hạn luân phiên 1.200 Tín dụng mỗi 5 giờ không thể đáp ứng được các đợt bùng nổ yêu cầu từ nhiều nhà phát triển, và điểm cuối qwen4-max-preview dự kiến sẽ đóng vào ngày 25 tháng 11 năm 2026 lúc 24:00 UTC+8.
So sánh trực tiếp: Qwen 4 Max với Qwen 3.8 Max, Kimi K3.1 Pro, GLM-5.3 và Claude Opus 5.5
Vì hiện tại bạn không thể tích hợp qwen4-max-preview vào backend sản xuất, câu hỏi thực tế đằng sau mọi truy vấn so sánh là: mô hình flagship nào theo hình thức trả phí theo mức sử dụng (pay-as-you-go) có thể đáp ứng cùng khối lượng công việc agentic với ngữ cảnh 1 triệu token mà không bị ràng buộc bởi đăng ký thuê bao hoặc rủi ro lộ dữ liệu huấn luyện.
| Mô hình |
Thanh toán & Khả dụng |
Cửa sổ ngữ cảnh |
Đầu ra tối đa |
Các phương thức đầu vào được hỗ trợ |
Tỷ giá đo lường GPT Proto (Đầu vào / Đầu ra trên 1 triệu) |
Qwen4-Max-Preview (qwen4-max-preview) |
Chỉ bản xem trước 14 ngày (Kết thúc ngày 25/11); Đăng ký gói Token ($6–$30/tháng) |
1.000.000 |
393.216 (bao gồm 262K CoT) |
Văn bản, Hình ảnh, Video |
Không được lưu trữ (Không có API upstream đo lường) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
Sản xuất Pay-As-You-Go |
1.000.000 |
65.536+ |
Văn bản, Hình ảnh, Video, Âm thanh, Tài liệu |
4,20 (thấp hơn 30% so với giá niêm yết chính thức) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
Sản xuất Pay-As-You-Go |
1.048.576 (1,05 triệu) |
131.072 |
Văn bản, Hình ảnh, Tài liệu |
10,00 ($0,20 cho đầu vào được lưu trong bộ nhớ đệm) |
GLM-5.3 (glm-5.3) |
Sản xuất Pay-As-You-Go |
1.050.000 (1,05 triệu) |
128.000 |
Văn bản, Hình ảnh, Tài liệu |
3,74 (thấp hơn 15% so với giá niêm yết chính thức) |
Claude Opus 5.5 (claude-opus-5-5) |
Sản xuất Pay-As-You-Go |
1.000.000 |
128.000 |
Văn bản, Hình ảnh, Tài liệu |
18,00 (thấp hơn 10% so với giá niêm yết chính thức) |
Qwen 4 Max so với Qwen 3.8 Max
Khi đánh giá qwen 4 max so với qwen 3.8 max, sự đánh đổi nằm ở thời gian xác minh tự động so với độ ổn định trong sản xuất và hỗ trợ đa phương thức rộng hơn. Như bài kiểm tra trang đích 17 phút so với 9,5 phút của WEEL đã chứng minh, Qwen 4 Max sẵn sàng dành gấp đôi thời gian thực để chạy các kiểm tra Python nền và tổng hợp các tệp SVG tùy chỉnh. Tuy nhiên, qwen4-max-preview đã loại bỏ tính năng phân tích tệp âm thanh và tài liệu gốc trên bản xem trước và không thể được gọi theo từng token.
Nếu quy trình của bạn đã dựa vào định dạng prompt, mã hóa đa ngôn ngữ hoặc thị giác đa phương thức của Alibaba, thì qwen3.8-max-0902 chính là mô hình flagship sẵn sàng cho sản xuất mà bạn nên chọn ngay hôm nay. Nó cung cấp cùng cửa sổ ngữ cảnh 1.000.000 token trong khi chấp nhận đầu vào là Văn bản, Hình ảnh, Video, Âm thanh và Tài liệu. Trên GPT Proto, qwen3.8-max-0902 chạy với mức giá 4,20 cho mỗi 1 triệu token đầu ra—thấp hơn 30% so với giá niêm yết chính thức của Alibaba—và bạn có thể so sánh nó cùng với các mô hình mã nguồn mở nhỏ hơn trong trung tâm mô hình Qwen.
Qwen 4 Max so với Kimi K3.1 Pro
Cuộc đối đầu qwen 4 max vs kimi k3.1 pro đã được thử nghiệm trực tiếp trong các bài kiểm tra Blender MCP và WebGL ngày 13 tháng 11 của Silicon Star, và sự khác biệt giữa hai mô hình này rất rõ ràng: Qwen 4 Max tư duy như một kỹ sư cơ khí kết cấu, trong khi Kimi K3.1 Pro tư duy như một nhà thiết kế công nghiệp.
Trong lời nhắc Blender ("Bến bảo trì tàu vũ trụ quỹ đạo Sao Mộc") và bài kiểm tra cổng biển sâu WebGL ("Cổng vạn thủy triều"), qwen4-max-preview đã xây dựng các khung chịu lực bên trong dày đặc hơn, các cánh tay lắp ghép phức tạp và một thanh trượt giao diện người dùng (UI) điều chỉnh mực nước thủy triều hoạt động, có khả năng tính toán lại mực nước và chỉ số áp suất một cách linh hoạt. Tuy nhiên, các nhà đánh giá liên tục chấm điểm kimi-k3.1-pro cao hơn về bố cục hình ảnh, ánh sáng shader nước và sự hài hòa màu sắc. Nếu bạn đang xây dựng các giao diện người dùng, trải nghiệm web 3D tương tác hoặc các tác nhân tài liệu có ngữ cảnh dài cần cửa sổ ngữ cảnh 1.048.576 token (1,05 triệu) và tối đa 131.072 token đầu ra ngay hôm nay, Kimi K3.1 Pro hiện đã có sẵn trên GPT Proto với giá 10,00 mỗi 1 triệu đầu ra (với đầu vào được lưu trong bộ nhớ đệm giảm xuống còn $0,20 mỗi 1 triệu).
Qwen 4 Max so với GLM-5.3
Các nhà phát triển tìm kiếm qwen 4 max vs glm5.3 thường theo đuổi hiệu suất lập trình và sử dụng công cụ khối lượng lớn với mức giá cạnh tranh. Mặc dù chương trình khuyến mãi Lite tháng đầu tiên với giá 3 đô la của Qwen 4 Max trông có vẻ rẻ trên lý thuyết, nhưng giới hạn tín dụng xoay vòng 5 giờ và lệnh cấm đối với các tập lệnh tự động khiến nó không thể sử dụng cho các đội ngũ tác nhân chạy nền.
Mô hình glm-5.3 của Z.ai giải quyết chính xác vấn đề đó trên một API có đo lường. Nó thực sự vượt trội hơn một chút so với Qwen 4 Max về tổng dung lượng ngữ cảnh—cung cấp cửa sổ ngữ cảnh 1,05 triệu kết hợp với giới hạn đầu ra 128K—và chấp nhận đầu vào dạng Văn bản, Hình ảnh và Tài liệu. Với mức giá 3,74 mỗi 1 triệu token đầu ra trên GPT Proto (thấp hơn 15% so với mức giá chính thức của Z.ai), GLM-5.3 là công cụ làm việc hiệu quả về chi phí nhất theo hình thức trả tiền khi sử dụng cho các bot đánh giá PR tự động, định tuyến công cụ có tính đồng thời cao và tạo mã đa tệp.
Qwen 4 Max so với Claude Opus 5.5
Alibaba đã tích hợp khả năng tương thích API Anthropic Messages gốc vào qwen4-max-preview đặc biệt để thu hút các nhà phát triển đang xem xét qwen 4 max vs claude opus 5.5 trong Claude Code. Như bài kiểm tra Python CLI của WEEL đã chứng minh, Qwen 4 Max đã có thể thực hiện vòng lặp sửa lỗi pytest kéo dài 12 phút và phát hiện các lỗi argparse và lỗi tiêm CSV tinh vi.
Điểm mà claude-opus-5-5 vẫn giữ ưu thế quyết định là hiệu quả quỹ đạo, khả năng phản hồi khi truyền phát và độ tin cậy SLA trong sản xuất. Những người thử nghiệm trong cộng đồng lưu ý rằng việc điều chỉnh RL giai đoạn đầu của Qwen 4 Max có thể khiến nó lặp lại các kiểm tra shell dư thừa ở tốc độ ~33 token/giây dưới chế độ suy luận xhigh. Khi bạn đang tái cấu trúc các kho lưu trữ sản xuất quan trọng, nơi mà việc lãng phí lượt sử dụng công cụ hoặc đào tạo dữ liệu cấp cá nhân là không thể chấp nhận được, Claude Opus 5.5 mang đến cửa sổ ngữ cảnh 1 triệu và đầu ra tối đa 128K với khả năng tuân thủ hướng dẫn trưởng thành. Thông qua GPT Proto, bạn có thể gọi claude-opus-5-5 với giá 18,00 mỗi 1 triệu đầu ra—thấp hơn 10% so với giá chính thức của Anthropic.
Cách gọi các giải pháp thay thế thương mại thông qua Unified API
Nếu bạn muốn chạy bốn mô hình thương mại hàng đầu ở trên mà không cần quản lý các SDK nhà cung cấp riêng biệt, cửa sổ tín dụng đăng ký hoặc các điểm cuối khu vực sk-sp-, GPT Proto sẽ hiển thị tất cả chúng thông qua một lộ trình duy nhất tương thích với OpenAI (https://gptproto.com/v1/chat/completions).
Một chi tiết xác thực cần lưu ý trước khi bạn sao chép đoạn mã: như đã ghi trong hướng dẫn xác thực và trang bắt đầu nhanh của chúng tôi, hãy luôn truyền khóa của bạn trong tiêu đề Authorization với tiền tố Bearer (Authorization: Bearer $GPTPROTO_API_KEY). Dưới đây là ví dụ dựa trên tài liệu cho thấy cách gọi qwen3.8-max-0902 và chuyển đổi trực tiếp sang glm-5.3, kimi-k3.1-pro, hoặc claude-opus-5-5 bằng cách thay đổi một chuỗi duy nhất:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Kiểm tra trình phân tích cú pháp CLI Python này để tìm các xung đột cờ số âm và rủi ro tiêm công thức CSV."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# Hoán đổi ID mô hình tự do giữa các mô hình hàng đầu có ngữ cảnh 1M:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Kiểm tra trình phân tích cú pháp CLI Python này để tìm các xung đột cờ số âm và rủi ro tiêm công thức CSV.",
        }
    ],
)

print(response.choices[0].message.content)