Sekilas Kimi K3.1 Pro vs Opus 5.5
| Item |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Harga input / output resmi per 1 juta token |
$2 / $10 |
$4 / $20 |
| Harga input / output GPT Proto per 1 juta token |
$2 / $10 |
$3.60 / $18 |
| Jendela konteks |
Sekitar 1 juta token |
1 juta token |
| Input / output model |
Teks dan gambar / teks |
Teks dan gambar / teks |
| Upaya penalaran default API asli |
Maksimal |
Sedang |
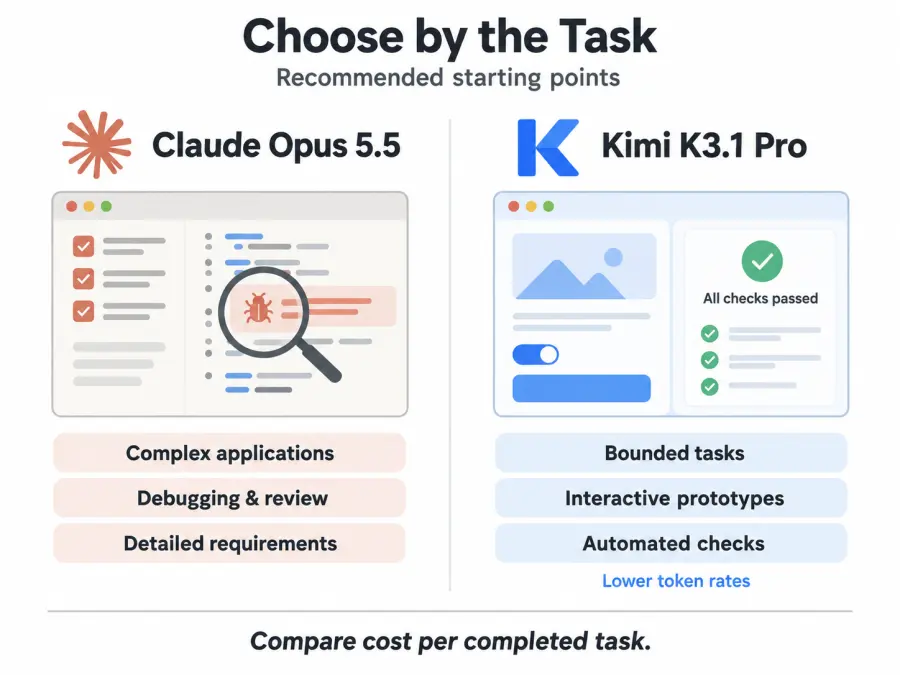
| Uji coba pertama yang saya rekomendasikan |
Tugas terbatas dengan pemeriksaan yang jelas |
Pengembangan kompleks dan tinjauan akhir |
Harga diperiksa pada 29 Oktober 2026. Spesifikasi resmi berasal dari dokumentasi API Kimi dan dokumentasi model Claude. Tarif GPT Proto tercantum di halaman API Kimi K3.1 Pro dan halaman API Claude Opus 5.5. Operasi cache dan biaya lain yang berlaku memerlukan perhitungan terpisah.
Untuk perbandingan katalog cepat, gunakan halaman perbandingan Kimi K3.1 Pro vs Claude Opus 5.5. Untuk latar belakang rilis Kimi ini, lihat apa yang berubah di Kimi K3.1 Pro.
Apa yang Dikatakan Tolok Ukur Tentang Coding dan Apa yang Tidak Mereka Ungkapkan
Moonshot dalam perbandingan peluncuran yang dipublikasikan melaporkan 65,7% untuk Kimi K3.1 Pro dan 66,4% untuk Opus 5.5 pada Terminal-Bench 4.0. Ini adalah angka yang dipublikasikan oleh vendor, menunggu verifikasi independen atas perbandingan spesifik tersebut. Angka ini mendukung pertimbangan serius terhadap Kimi untuk pekerjaan berbasis terminal; namun tidak menetapkan kinerja yang setara di seluruh pengembangan aplikasi.
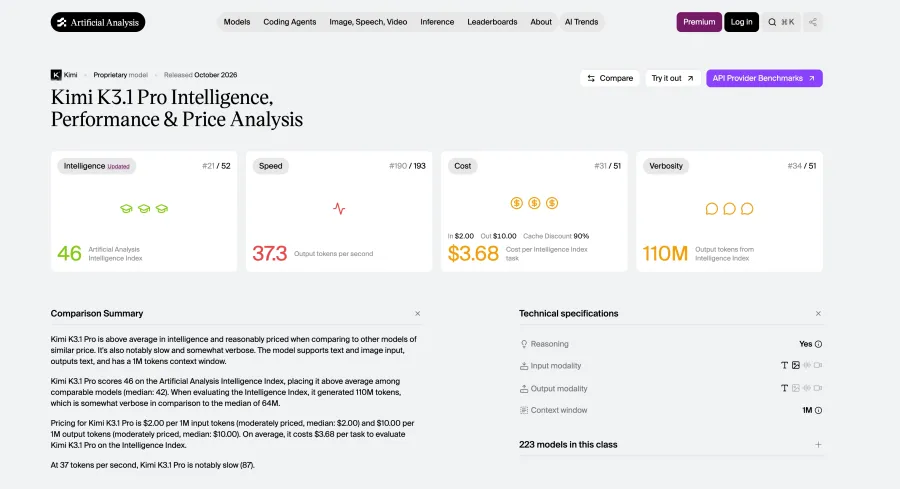
Gambaran independen yang lebih luas berbeda. Pada 29 Oktober, halaman model Artificial Analysis Intelligence Index v5.0 menunjukkan Kimi di angka 46 dan Opus di angka 58, dengan yang terakhir diberi label Maksimal dengan Cadangan Default. Poin indeks tersebut bukanlah persentase atau tingkat keberhasilan coding. Pastikan untuk tetap menyertakan versi indeks dan konfigurasi pada perbandingan tersebut.
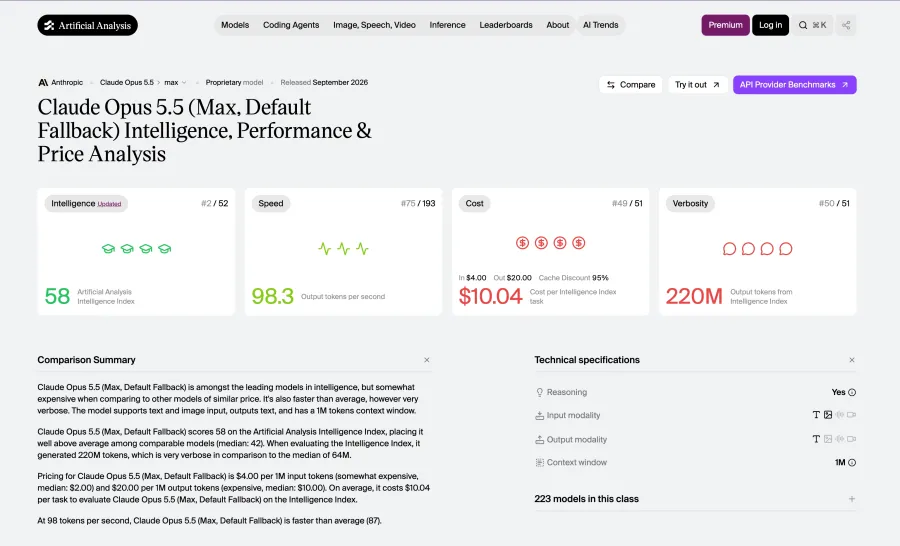
Saya akan memperlakukan Opus sebagai tolok ukur kualitas awal untuk pekerjaan yang menuntut, kemudian menguji apakah Kimi memenuhi kriteria penerimaan yang sama dengan biaya yang lebih rendah. Tolok ukur terminal tidak dapat memberi tahu Anda apakah formulir pemesanan mempertahankan statusnya atau apakah dasbor tetap dapat dibaca di perangkat seluler. Pengujian aplikasi Anda yang harus menjawab hal tersebut.
Coding Frontend: Dari Tangkapan Layar ke Antarmuka yang Berfungsi
Untuk tugas mengubah tangkapan layar menjadi antarmuka, pisahkan antara tampilan dan perilaku. Tata letak yang akurat tetap memerlukan navigasi yang berfungsi, status formulir, akses papan ketik, dan versi seluler yang dapat digunakan. Kemudian, mintalah perubahan. Menambahkan filter tanpa merusak tata letak yang ada adalah pengujian yang berbeda dibandingkan dengan membuat halaman baru dari awal.
Terdapat contoh pengembang yang berguna di sini. Dalam perbandingan yang diterbitkan oleh Melvynx, ia lebih menyukai tampilan visual pemeriksa zona waktu dari Opus. Itu adalah penilaian estetika terhadap satu hasil pembangunan, bukan tingkat keberhasilan frontend yang terukur.
Untuk situs pemasaran atau dasbor yang menghadap klien, pilihan pertama saya adalah Opus ketika desain membutuhkan perbedaan dan penyempurnaan berulang. Kimi adalah kandidat yang masuk akal untuk antarmuka internal dengan sistem desain yang jelas, terutama ketika Anda dapat memeriksa hasilnya sebelum dirilis. Pertukarannya adalah waktu yang dihabiskan untuk memperbaiki apa yang dibiarkan terbuka oleh perintah awal.
Pertimbangkan antarmuka pemesanan sebagai ringkasan evaluasi. Berikan gambar referensi, pustaka komponen yang ada, serta persyaratan untuk pemilihan tanggal, slot yang tidak tersedia, validasi, dan konfirmasi yang sama kepada kedua model. Minta masing-masing untuk menghubungkan antarmuka ke API tiruan yang sama. Kemudian, masukkan permintaan yang gagal dan periksa apakah pengguna dapat memulihkan tanpa kehilangan formulir.
Langkah terakhir itulah yang menjadikannya perbandingan aplikasi. Hal ini mengungkap apakah halaman yang menarik juga menangani tindakan pelanggan berikutnya.
Aplikasi Interaktif dan 3D: Kualitas Visual, Logika, dan Performa Runtime
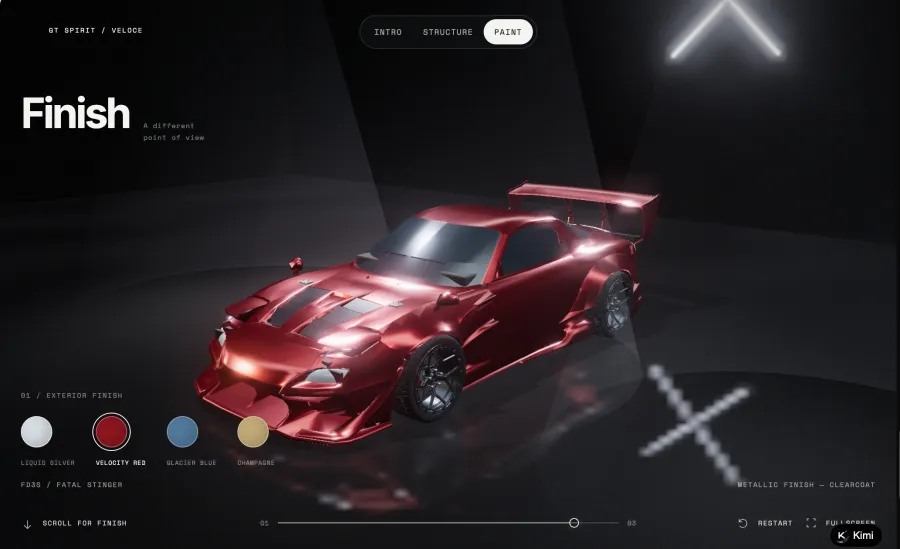
Kasus Kimi menjadi lebih menarik pada pekerjaan visual interaktif. Contoh lampu lava dari Melvynx menyertakan kontrol pencahayaan dan warna. Ia menilai hasil upaya lebih tinggi dari Opus sebagai yang terbaik, sementara menganggap material dan efek kaca Kimi meyakinkan. Biaya operasional yang dilaporkannya adalah $2,30 untuk Kimi High dan $4,16 untuk Max, dibandingkan dengan $4,35 untuk Opus Medium dan $6,39 untuk Extra High.
Ulasan yang sama menjelaskan simulasi tabrakan yang bekerja lebih baik pada Kimi High daripada Max. Penulis mengungkapkan tautan afiliasi Kimi dan ruang kerja bersama yang tidak terisolasi. Contoh-contoh ini adalah pengamatan yang berguna, dengan batasan-batasan tersebut.
Menurut saya, Kimi layak diuji untuk konfigurator produk, demo edukasi, dan prototipe visual. Memilih pengaturan upaya yang lebih tinggi secara otomatis akan melewatkan salah satu pelajaran praktis dari contoh-contoh tersebut. Mulailah dengan persyaratan eksplisit dan periksa artefaknya.
Untuk konfigurator furnitur, tentukan apa yang harus berubah ketika seseorang memilih material, mengganti tampilan kamera, atau mengatur ulang desain. Periksa apakah harga yang ditampilkan sesuai dengan pilihan. Muat ulang halaman. Coba kontrolnya di ponsel. Kursi yang menarik secara visual hanyalah sebagian dari hasil yang harus dikirimkan.
Akurasi teknis memerlukan pemeriksaannya sendiri. Hasil BenchCAD dari Moonshot melaporkan 92,7% untuk Kimi dan 96,2% untuk Opus dengan alat, menggunakan metrik rekonstruksi geometri. Hasil yang diterbitkan vendor tersebut menjawab pertanyaan yang berbeda dari apakah suatu pemandangan terlihat menarik. Animasi yang meyakinkan tetap memerlukan validasi terpisah sebelum Anda menggunakannya untuk mengajarkan fisika atau merepresentasikan proses teknik.
Untuk prototipe, saya akan mencoba Kimi terlebih dahulu. Untuk aplikasi yang sensitif terhadap presisi, saya akan mulai dengan Opus dan memerlukan pemeriksaan khusus domain, model mana pun yang menghasilkan kodenya.
Pengembangan Agen: Bisakah Model Menyelesaikan Tugas Multi-Langkah?
Agen yang bekerja di dalam repositori harus memahami perilaku yang ada, memilih file untuk diubah, menjalankan alat, menafsirkan kegagalan, dan memutuskan kapan harus berhenti. Kesalahan dapat terakumulasi di antara langkah-langkah tersebut.
Kedua vendor mempublikasikan contoh pekerjaan yang diperluas. Moonshot menjelaskan Kimi mendiagnosis dan memperbaiki simulator sebelum melatih ulang pengontrol berjalan. Laporan peluncuran Opus 5.5 dari Anthropic menjelaskan peningkatan di seluruh aplikasi web, termasuk tugas waktu muat yang diselesaikan dengan sukses dalam 39 dari 40 percobaan. Ini adalah contoh vendor yang terpisah, bukan pengujian head-to-head bersama.
Untuk aplikasi faktur yang sudah ada, perbandingan yang berguna adalah menambahkan impor CSV. Memerlukan pemetaan bidang, penanganan baris yang tidak valid, deteksi duplikat, pratinjau, dan pengujian yang mencakup perilaku yang ada. Biarkan setiap model bekerja dari snapshot repositori yang sama dan periksa kedua patch tersebut. Ringkasan yang menyatakan “semua pengujian lulus” memerlukan log pengujian di belakangnya.
Untuk jenis perubahan lintas file seperti itu, Opus akan menjadi titik awal default saya. Kimi lebih mudah dievaluasi pada bagian pekerjaan yang terbatas, seperti menerapkan validasi terhadap skema yang disepakati. Perluas cakupannya setelah pengujian menetapkan bahwa model tersebut dapat menangani aplikasi di sekitarnya.
Konfigurasi juga penting. Panduan penggunaan alat Kimi mengharuskan penyimpanan pesan asisten lengkap di seluruh giliran. Dokumentasi Opus Claude menjelaskan pemikiran khusus model dan perilaku alat. Verifikasi detail tersebut pada rute pilihan Anda; mencocokkan format permintaan dasar tidak menjamin perilaku agen yang identik.
Harga dan Biaya: Berapa Biaya Sebenarnya dari Hasil yang Diterima?
Kimi K3.1 Pro memiliki tarif input dan output standar yang lebih rendah. Pertanyaan yang lebih sulit adalah berapa banyak panggilan, percobaan ulang, dan siklus peninjauan yang dibutuhkan tugas Anda.
Berikut adalah contoh perencanaan menggunakan tarif yang tercantum di GPT Proto. Asumsikan setiap upaya menggunakan 1 juta token input yang tidak di-cache dan 200.000 token output yang ditagihkan. Ini adalah volume hipotetis, bukan hasil aplikasi yang diamati.
| Skenario perencanaan |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Satu upaya pada volume yang dinyatakan |
$4.00 |
$7.20 |
| Dua upaya, masing-masing pada volume yang sama |
$8.00 |
$14.40 |
Berdasarkan asumsi tersebut, hasil Kimi yang memerlukan dua upaya memakan biaya token lebih banyak daripada hasil Opus yang diterima setelah satu upaya. Percobaan ulang yang sebenarnya jarang mengulangi volume token yang persis sama, jadi gunakan catatan penggunaan Anda untuk perhitungan yang sebenarnya.
Caching mengubah perbandingan lagi. Kedua vendor mencantumkan pembacaan cache resmi sebesar $0,20 per 1 juta token dalam dokumentasi Kimi dan Claude mereka. Sesi agen yang panjang dengan banyak cache hit akan memiliki rasio biaya yang berbeda dari permintaan baru. Periksa juga biaya penulisan cache, penggunaan output, dan tarif penyedia Anda yang sebenarnya.
Untuk sebuah tim, saya akan melacak biaya per tugas yang diterima bersama dengan waktu yang berlalu dan menit peninjau. Draf yang lebih murah bisa bernilai baik jika pemeriksaannya cepat. Hal ini menjadi kurang menarik ketika pengembang harus merekonstruksi apa yang diubah oleh agen sebelum mempercayainya.
Cara Membandingkan Kedua Model di Aplikasi Anda Sendiri Melalui GPT Proto
Gunakan perubahan aplikasi kecil dengan hasil yang dapat diamati. Formulir pemesanan, pengimpor CSV, atau konfigurator produk memberi Anda bukti yang lebih berguna daripada permintaan tak terbatas untuk “membangun sesuatu yang mengesankan.”
Buka halaman model Kimi dan halaman model Opus. Gunakan Coba model ini dan Mulai Cepat untuk mendapatkan panduan integrasi, lalu salin instruksi Markdown ke asisten pengodean Anda. Simpan kunci API Anda dalam variabel lingkungan lokal atau konfigurasi sisi server.
Sebelum mengevaluasi kualitas pengembangan, periksa apakah kedua rute model merespons. Contoh koneksi ini mengikuti format Chat Completions yang dipublikasikan di halaman model. Atur GPTPROTO_API_KEY secara lokal sebelum menjalankannya; permintaan tersebut akan menggunakan token berbayar.
for model in kimi-k3.1-pro claude-opus-5-5; do
  curl --fail-with-body --silent --show-error --max-time 180 \
    https://gptproto.com/v1/chat/completions \
    -H "Authorization: Bearer $GPTPROTO_API_KEY" \
    -H "Content-Type: application/json" \
    --data "{
      \"model\": \"$model\",
      \"messages\": [{\"role\": \"user\",
        \"content\": \"Return only: API connection OK\"}]
    }"
done
Ini memeriksa konektivitas, bukan kualitas pengodean. API asli memiliki pengaturan penalaran default yang berbeda; konfigurasikan dan catat pengaturan upaya yang didukung sebelum melakukan perbandingan aplikasi. Respons API juga memerlukan agen atau aplikasi di sekitarnya untuk mengedit file, menjalankan alat, dan memeriksa browser.
Untuk uji coba pengembangan, mulai setiap model dari salinan bersih proyek yang sama. Berikan tugas, izin, dependensi, dan pengujian penerimaan yang sama. Catat rute model, upaya, penggunaan yang ditagih, waktu penyelesaian, dan perubahan manual yang diperlukan. Ulangi tugas tersebut sebelum menjadikan perbedaan kecil sebagai default produksi Anda.
Jika titik akhir mengembalikan kesalahan autentikasi, periksa kunci dan header otorisasi. Jika parameter opsional ditolak, bandingkan dengan panduan halaman model saat ini. Verifikasi bahwa respons yang berhasil berisi output model yang dimaksudkan sebelum memperluas pekerjaan.
Model Mana yang Harus Anda Pilih?
| Beban kerja Anda |
Pilihan awal saya |
Kondisi untuk tetap menggunakannya |
| Frontend yang berhadapan langsung dengan klien dengan revisi desain berulang |
Opus 5.5 |
Output yang lebih baik dan diterima membenarkan biayanya |
| Prototipe interaktif atau eksperimen visual |
Kimi K3.1 Pro |
Kontrol berfungsi dan artefak mudah diperiksa |
| Perubahan kompleks pada aplikasi yang sudah ada |
Opus 5.5 |
Pengujian repositori dan dukungan peninjauan mendukung pilihan ini |
| Implementasi berulang terhadap spesifikasi tetap |
Kimi K3.1 Pro |
Pemeriksaan otomatis menjaga biaya koreksi tetap rendah |
| Kode atau simulasi yang sensitif terhadap presisi |
Opus sebagai garis dasar awal |
Validasi eksternal diperlukan untuk kedua model |
Saya akan memilih Opus 5.5 sebagai default awal bagi tim yang menyerahkan pekerjaan aplikasi yang substansial kepada agen. Bukti evaluasi yang lebih luas mendukung untuk memulai dari sana, sementara repositori yang sebenarnya akan menentukan apakah harga premium tersebut sepadan.
Kimi K3.1 Pro adalah kandidat praktis untuk mengurangi biaya pekerjaan yang terdefinisi dengan baik. Mulailah dengan tugas yang dapat Anda periksa atau uji, ukur hasil yang diterima, dan berikan tanggung jawab lebih seiring dengan meningkatnya bukti. Itu adalah alasan yang lebih kuat untuk beralih daripada hasil yang hampir seri pada satu tolok ukur.
Bawa satu tugas kecil ke halaman API Kimi K3.1 Pro dan API Claude Opus 5.5, gunakan panduan integrasi, dan bandingkan hasil yang dapat diterima oleh aplikasi Anda.