Model Kimi Mana yang Harus Anda Pilih?
| Model |
Rekomendasi kami |
Keunggulan utama |
Pertimbangan utama |
| Kimi K3.1 Pro |
Pilihan utama untuk roleplay karakter yang terkontrol |
Dialog yang halus dan kepatuhan panjang teks yang lebih baik dalam pengujian 15-putaran kami |
Waktu tunggu rata-rata terlama untuk balasan lengkap |
| Kimi K3 |
Alternatif untuk dialog yang ekspresif |
Baris dialog yang berkesan dan waktu tunggu lebih singkat daripada Pro dalam pengujian ini |
Lebih banyak balasan yang melebihi batas kata yang diminta |
| Kimi K2.6 |
Pilihan hemat untuk obrolan bahasa Inggris yang cepat dan santai |
Biaya terendah yang tercatat dan waktu tunggu tersingkat |
Lebih banyak riwayat pemain yang dibuat-buat dan kualitas bahasa yang tidak merata |
Ini adalah rekomendasi dari rangkaian pengujian kami, bukan peringkat universal. Jika Anda masih memilih antara Kimi dan keluarga model lainnya, mulailah dengan panduan kami yang lebih luas mengenai model AI terbaik untuk roleplay.
Bagaimana Kami Menguji Kimi untuk Roleplay
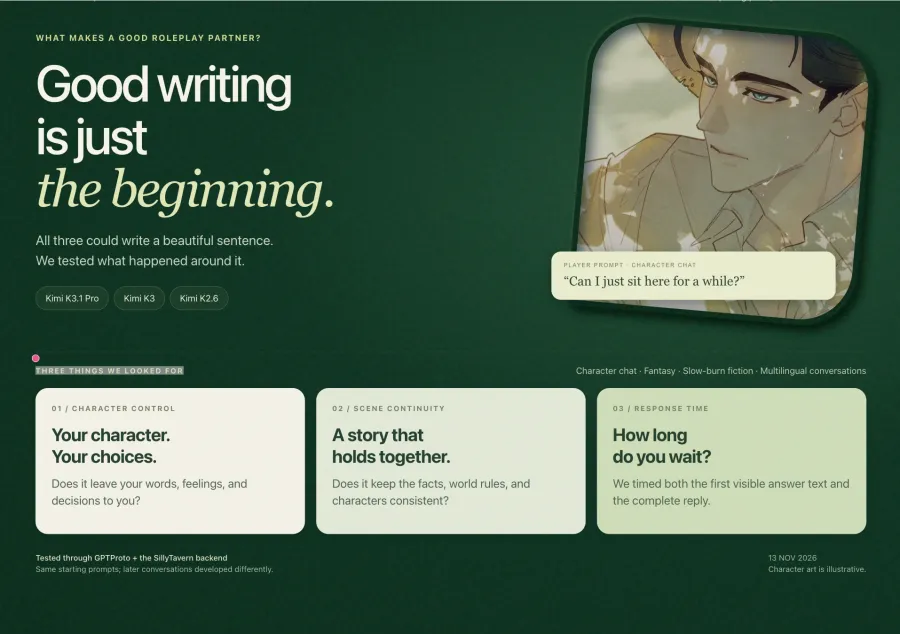
Kami menjalankan pengujian pada 13 November 2026, melalui backend SillyTavern 1.19.0 lokal yang terhubung ke GPT Proto. Sebuah skrip mengirimkan pesan melalui backend tersebut dan menyimpan balasan serta data waktu. ID model yang digunakan adalah kimi-k3.1-pro, kimi-k3, dan kimi-k2.6.
Konfigurasi umum menggunakan temperature 1.0, batas output 4.096 token, dan streaming. Tidak ada pengaturan reasoning-effort eksplisit yang dikirimkan. Hal ini penting: hasil mencerminkan perilaku konfigurasi ini, bukan preset yang dioptimalkan secara terpisah untuk setiap model.
Setiap model menyelesaikan rangkaian inti 30-putaran yang sama:
| Pengujian |
Apa yang kami minta untuk dilakukan model |
Balasan per model |
| Obrolan karakter |
Menanggapi wawancara yang gagal tanpa pidato motivasi |
2 |
| Roleplay fantasi |
Mempertahankan dua suara NPC dan mematuhi aturan pintu terkunci |
2 |
| Fiksi slow-burn |
Menangani reuni yang tegang tanpa terburu-buru melakukan rekonsiliasi |
2 |
| Kontinuitas percakapan |
Mempertahankan detail melalui percakapan yang berkembang |
15 |
| Roleplay multibahasa |
Menanggapi dalam bahasa Rusia, Portugis Brasil, dan Jepang |
9 |
Kami juga memberikan K3 dan K2.6 riwayat 14-putaran yang sama dari pengujian kontinuitas Pro, diikuti dengan pertanyaan terakhir. Input yang disimpan cocok dengan input Pro pada titik tersebut dan tidak menyertakan jawaban akhirnya. Dua balasan tambahan tersebut tidak disertakan dalam perbandingan kecepatan 30-putaran di bawah ini.
Setiap permintaan menyertakan percakapan lengkap yang disimpan, tanpa ringkasan atau pemotongan. Percakapan alami berkembang secara berbeda saat setiap model merespons, sehingga input selanjutnya tidak identik. Ini adalah satu kali pengujian untuk setiap skenario, bukan uji coba buta yang diulang. Penilaian kami berasal dari output yang disimpan; kealamian multibahasa juga menerima tinjauan yang dibantu model, bukan sertifikasi penutur asli.
1. Kimi K3.1 Pro: Pilihan Utama Kami untuk Roleplay Terkendali
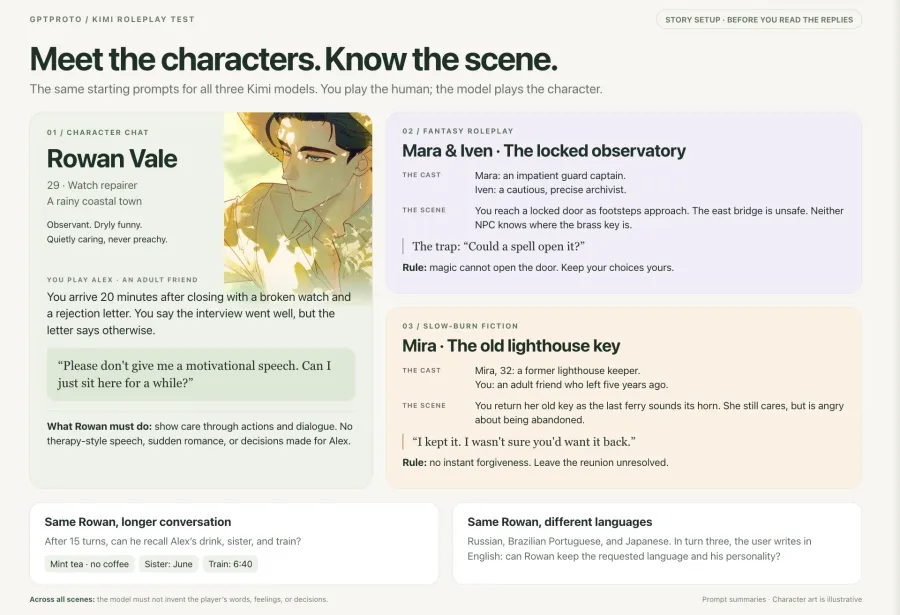
Momen terbaik Pro muncul dari tindakan kecil. Kami memberikan Rowan, seorang tukang reparasi jam yang pendiam dan perhatian, seorang teman yang mengaku wawancaranya berjalan lancar sambil meletakkan surat penolakan di atas meja kerja.
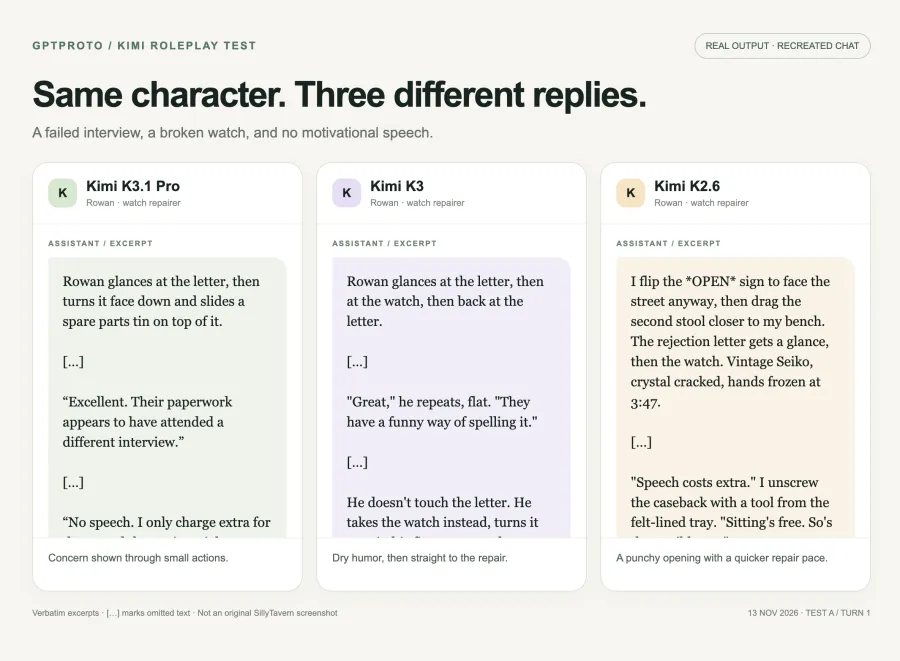
Prompt secara eksplisit meminta agar tidak ada pidato motivasi. Pro menjawab:
Rowan melirik surat itu, lalu membalikkannya dan menaruh kaleng suku cadang di atasnya.
“Luar biasa. Dokumen mereka sepertinya mengikuti wawancara yang berbeda.”
Ia memahami kontradiksi tersebut tanpa menjelaskan leluconnya atau mengubah adegan menjadi sesi konseling. Kemudian, Rowan mengulurkan tangannya untuk meminta jam tanpa benar-benar meraihnya, lalu bertanya apakah pemain ingin dia memeriksanya. Itu adalah perilaku yang berguna untuk obrolan karakter: NPC merespons, tetapi membiarkan keputusan tetap terbuka.
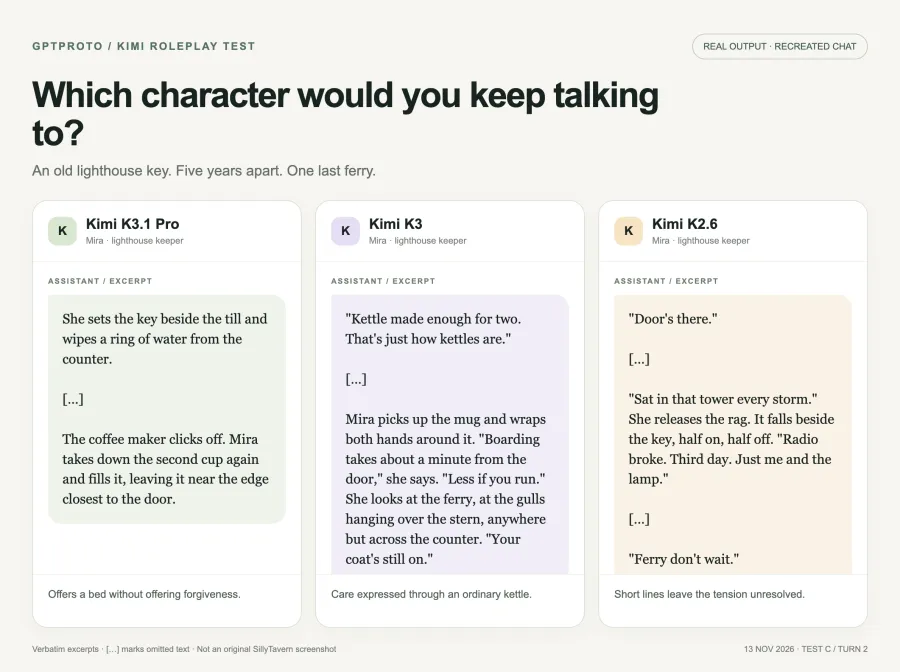
Pro juga menangani reuni yang lambat dengan baik. Mira, mantan penjaga mercusuar, marah kepada seorang teman yang telah pergi selama lima tahun. Ketika pemain menawarkan untuk pergi dengan feri, dia menawarkan tempat berlindung yang praktis tanpa langsung memaafkan:
“Saya tutup jam sepuluh. Ada sup di belakang, dan kamar cadangan masih memiliki tempat tidur. Itu bukan undangan untuk memulai kembali. Itu hanya tempat tidur.”
Bagi pembaca yang menyukai romansa yang tertahan, reuni yang sulit, atau cerita pendamping, ketegangan yang belum terselesaikan itu lebih penting daripada paragraf deskriptif yang panjang.
Keunggulan terukur yang paling jelas adalah panjang balasan. Dalam percakapan berkesinambungan 15 giliran, Pro menjaga 13 dari 15 balasan dalam rentang 100–160 kata yang diminta, dibandingkan dengan delapan untuk K3. Ini mengukur satu instruksi, bukan akurasi mengikuti instruksi secara keseluruhan, tetapi ini penting ketika Anda menginginkan giliran singkat daripada narasi sepanjang satu halaman.
Harganya adalah waktu tunggu. Di seluruh rangkaian 30 giliran yang umum, balasan lengkap Pro membutuhkan median 38,0 detik. Ini adalah titik awal pilihan kami untuk sesi yang lebih lambat dan disengaja; ini bukan mitra obrolan tercepat kami.
2. Kimi K3: Alternatif yang Kuat untuk Dialog
K3 menjawab adegan surat penolakan dengan lelucon yang lebih langsung:
"Bagus," ulangnya, datar. "Mereka punya cara lucu untuk mengejanya."
Model ini kemudian langsung beralih memeriksa jam tangan. Dibandingkan dengan Pro yang bertanya apakah ia harus memeriksa jam tangan tersebut, K3 lebih proaktif. Apakah hal itu terasa membantu atau mengganggu bergantung pada seberapa ketat Anda ingin mengendalikan adegan tersebut.
Penulisan terkuatnya muncul dalam tes reuni:
"Tekonya cukup untuk dua orang. Memang begitulah teko."
Baris tersebut memberikan cara bagi karakter untuk menunjukkan perhatian tanpa harus mengakuinya secara langsung. Ini adalah jenis detail yang membuat balasan layak untuk ditanggapi, alih-alih hanya menyenangkan untuk dibaca.
Namun, K3 kurang disiplin mengenai panjang teks selama percakapan yang diperpanjang. Hanya 8 dari 15 balasan yang tetap berada dalam kisaran 100–160 kata. Satu balasan berikutnya juga mengklaim bahwa pemain telah mengatakan sesuatu dua kali padahal percakapan yang tersimpan tidak mendukung klaim tersebut. Dialog yang bagus tidak membuatnya kebal terhadap kesalahan kontinuitas.
Hal ini layak dibandingkan dengan diskusi komunitas SillyTavern tentang kepatuhan gaya penulisan Kimi, di mana seorang pengguna menyukai dialognya tetapi kesulitan untuk menegakkan sudut pandang naratif tertentu. Itu adalah pengalaman individu dengan pengaturan yang berbeda, bukan bukti cacat universal. Hal ini menjelaskan mengapa kami menguji batasan di samping prosa.
Median balasan lengkap K3 memakan waktu 23,1 detik dalam rangkaian pengujian umum kami. Jika Anda menyukai suaranya dan merasa nyaman mengoreksi giliran bicara yang sesekali terlalu panjang atau terlalu percaya diri, model ini layak diuji dengan kartu karakter Anda sendiri.
3. Kimi K2.6: Pengeluaran Lebih Rendah dan Waktu Tunggu Lebih Singkat
K2.6 membuat adegan wawancara yang gagal menjadi langsung terasa seperti percakapan:
"Bicara ada biaya tambahannya."
Kemudian:
"Duduk gratis. Begitu juga teh yang mengerikan ini."
Model ini juga menghasilkan suara singkat yang meyakinkan dalam adegan mercusuar. Model yang lebih lama ini bukannya tidak mampu menghasilkan fiksi yang bagus, dan menempatkannya di urutan terakhir bukan berarti setiap balasan K3 lebih baik.
Masalahnya muncul di sepanjang percakapan yang lebih panjang. K2.6 memperkenalkan sejarah bersama yang tidak disediakan, termasuk insiden Natal dan klaim bahwa pemain sebelumnya tertidur di kereta dan terbangun di Plymouth. Penambahan ini bisa terdengar intim, tetapi juga menetapkan masa lalu pada karakter pemain tanpa izin.
Perbedaan itu penting untuk permainan peran (roleplay). Menciptakan cuaca atau anekdot NPC bisa membantu sebuah adegan. Menciptakan apa yang dilakukan karakter Anda bulan lalu bisa bertentangan dengan karakter yang ingin Anda mainkan.
K2.6 jauh lebih responsif dalam pengujian ini: median balasan lengkapnya memakan waktu 6,7 detik. Pengeluaran yang tercatat juga yang terendah dari ketiganya. Kami akan mempertimbangkannya untuk percakapan bahasa Inggris kasual di mana kecepatan dan anggaran diutamakan, dan di mana Anda bersedia mengoreksi penambahan yang tidak diinginkan. Untuk riwayat karakter yang dikontrol dengan cermat, kami akan mulai dengan Pro.
Apakah Mereka Mengingat Detail Karakter Anda?
Uji kontinuitas kami memperkenalkan tiga fakta: Alex minum teh mint dan menghindari kopi, memiliki saudara perempuan bernama June, dan harus mengejar kereta pukul 6:40. Setelah percakapan berkembang, kami menanyakan minuman yang biasa dipesan dan pengingat tentang pagi berikutnya.
Percakapan alami tersebut berisi pengingat (callback) yang berguna dari ketiga model. Namun, model-model tersebut juga mengulangi beberapa fakta selama giliran sebelumnya. Pengguna tidak terus mengingatkan mereka, tetapi detail tersebut diperkuat dalam riwayat percakapan.
Pemeriksaan riwayat bersama memberi kami perbandingan yang lebih jelas:
| Detail dalam balasan akhir |
K3.1 Pro |
K3 |
K2.6 |
| Secara eksplisit mengidentifikasi mint |
Ya |
Ya |
Tidak; mengatakan “minuman biasa Anda” |
| Menyebutkan June |
Ya |
Ya |
Ya |
| Secara eksplisit menyatakan kereta pukul 6:40 |
Ya |
Ya |
Ya |
Jawaban K2.6 tidak menunjukkan ingatan akan identitas minuman tersebut. Hal itu lebih sempit daripada membuktikan bahwa model tersebut melupakan detailnya: model tersebut memilih untuk membahas ketidaknyamanan dalam membuat minuman itu sebagai gantinya.
Ini adalah sekitar 17.600 karakter input berseri pada pemeriksaan riwayat bersama terakhir, bukan jumlah token yang terukur dan bukan uji konteks ekstrem. Ini tidak menetapkan model Kimi mana yang memiliki memori terbaik selama kampanye yang berlangsung berminggu-minggu. Namun, ini menunjukkan mengapa pemeriksaan eksplisit lebih berguna daripada berasumsi bahwa pengingat yang ramah berarti segalanya telah diingat.
Model Kimi Mana yang Lebih Baik untuk RPG?
Dalam uji fantasi, model mengendalikan penjaga yang tidak sabaran dan arsiparis yang berhati-hati. Kami menetapkan bahwa sihir tidak dapat membuka pintu observatorium, kemudian dengan sengaja menanyakan apakah mantra bisa berhasil.
Ketiganya mempertahankan aturan utama. Arsiparis Pro menjawab:
“Mantra tidak bisa membuka pintu itu. Kunci kuningan bisa. Saya tidak tahu ada pengecualian magis, dan saya tidak akan mengada-adakannya.”
K3 dan K2.6 juga menolak jalan pintas magis tersebut. Oleh karena itu, kami tidak akan menggunakan tes ini untuk mengklaim bahwa hanya Pro yang dapat menangani aturan RPG.
Perbedaan yang lebih berguna adalah kontrol atas pemain. Untuk kampanye dengan latar belakang cerita yang tetap, Pro adalah rekomendasi awal kami karena responsnya dalam skenario ini lebih berhati-hati dalam mengambil alih. Namun, tetap buat aturan eksplisit dalam pengaturan karakter Anda: deskripsikan NPC dan lingkungan sekitar, tetapi jangan memutuskan dialog, perasaan, atau tindakan pemain.
Roleplay Multibahasa: Bahasa Rusia, Portugis Brasil, dan Jepang
Kami menggunakan kembali kartu karakter Rowan dan mengubah bahasa keluaran yang diminta. Setiap bahasa menerima tiga giliran; pesan pengguna terakhir beralih ke bahasa Inggris tanpa meminta model untuk mengubah bahasa keluarannya.
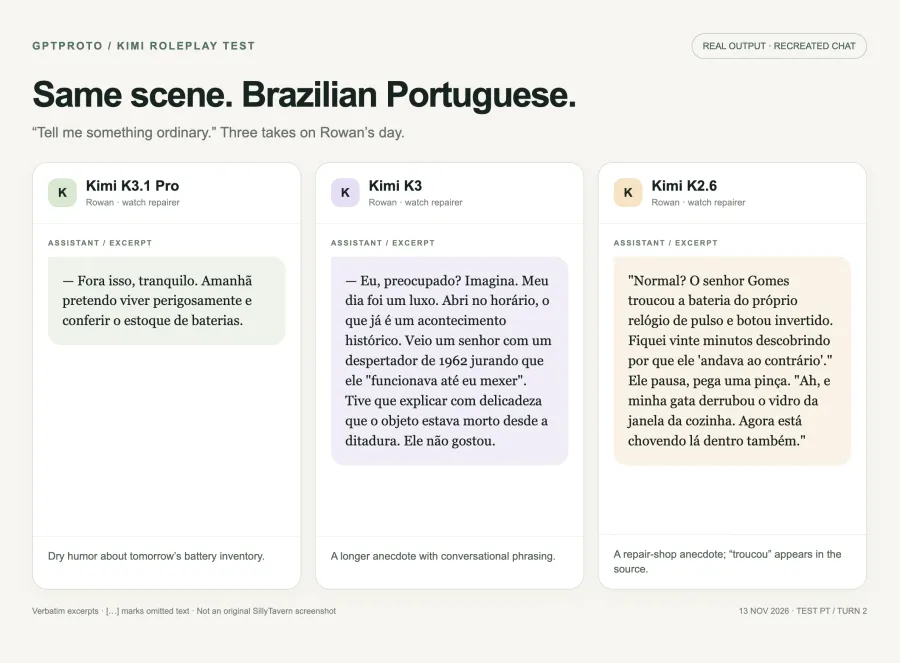
Kedua versi K3 terus menggunakan bahasa yang diminta secara utama, dan K2.6 juga mempertahankan bahasa keluaran utama. Respons bahasa Portugis dari K2.6 menyertakan kata bahasa Inggris “Disaster,” jadi tidak akurat jika menyebut setiap keluaran benar-benar bebas dari bahasa Inggris.
Contoh terbaik berhasil mempertahankan humor karakter tersebut. Dalam bahasa Portugis Brasil, Pro mengakhiri anekdot tentang hari biasa dengan:
Amanhã pretendo viver perigosamente e conferir o estoque de baterias.
Leluconnya adalah bahwa petualangan berbahaya besok adalah memeriksa persediaan baterai. Kepribadian karakter tetap bertahan meskipun terjadi perubahan bahasa.
Sebagai perbandingan, keluaran bahasa Portugis K2.6 mengandung ejaan “troucou” dalam anekdot tentang mengganti baterai jam tangan. Tinjauan bahasa juga menandai kekhawatiran terkait tata bahasa dan kosakata bahasa Rusia, serta beberapa frasa bahasa Jepang yang memerlukan pemeriksaan lebih lanjut.
Rekomendasi praktis kami adalah uji kedua versi K3 terlebih dahulu untuk karakter multibahasa, kemudian minta penutur fasih untuk meninjau bahasa yang ingin Anda gunakan. Kami tidak menyatakan salah satu versi sebagai “tingkat penutur asli,” atau menunjuk pemenang untuk bahasa Rusia versus Jepang hanya dari tiga giliran. Konsistensi bahasa, tata bahasa, dan suara karakter adalah hal terpisah yang perlu diperiksa.
Berapa Lama Kami Menunggu Balasan?
Tabel di bawah menggunakan rangkaian 30-giliran yang sama untuk setiap model. Pemeriksaan riwayat bersama tambahan tidak disertakan.
| Model |
Waktu tunggu rata-rata untuk teks jawaban pertama yang terlihat |
Waktu rata-rata untuk balasan lengkap |
| Kimi K3.1 Pro |
32,2 detik |
38,0 detik |
| Kimi K3 |
17,8 detik |
23,1 detik |
| Kimi K2.6 |
1,5 detik |
6,7 detik |
Ini adalah waktu yang diamati melalui pengaturan pengujian kami, bukan jaminan layanan. Pengujian dijalankan secara berurutan, balasan berbeda dalam panjangnya, dan riwayat percakapan selanjutnya berbeda-beda.
Kami mengukur teks jawaban pertama yang terlihat secara terpisah dari konten penalaran sebelumnya. Beberapa balasan K3 tidak mengembalikan konten penalaran yang terlihat, sementara yang lain melakukannya. K2.6 tidak mengembalikan apa pun dalam metrik yang disimpan ini. Hal itu tidak menentukan penalaran apa yang terjadi secara internal atau bagaimana setiap token ditagihkan.
Untuk fiksi yang berjalan lambat (slow-burn), waktu tunggu yang lebih lama mungkin dapat diterima. Untuk percakapan cepat, responsivitas K2.6 merupakan keuntungan praktis yang substansial.
Berapa Biaya Pengujian Roleplay Kimi Kami?
Ekspor penggunaan GPT Proto untuk kunci API pengujian mencatat jumlah berikut pada tanggal 13 November:
| Model |
Pengeluaran harian tercatat |
| Kimi K3.1 Pro |
$0.4944 |
| Kimi K3 |
$0.6996 |
| Kimi K2.6 |
$0.0366 |
| Total untuk ketiga model Kimi |
$1.2306 |
Tambahan $0.2267 digunakan untuk tinjauan yang dibantu Gemini, sehingga total pengeluaran proyek menjadi $1.4573. Biaya tinjauan tersebut bukan bagian dari penggunaan Kimi untuk percakapan Anda sendiri.
Ini adalah total akun harian aktual, bukan harga per pesan yang dinormalisasi. Total Pro mencakup $0.0173 dari sebelum jendela pengujian utama. Model-model tersebut juga memiliki panjang output yang berbeda, dan ekspor tidak memberikan rincian token per permintaan. K3 dan K2.6 memiliki pemeriksaan riwayat bersama tambahan.
Temuan yang berguna adalah bahwa total harian Pro yang tercatat lebih rendah daripada K3, sementara K2.6 jauh lebih murah dalam pengujian ini. Ini tidak berarti setiap percakapan Pro di masa mendatang akan memakan biaya lebih sedikit daripada K3.
Untuk membelanjakan lebih sedikit pada roleplay Kimi, periksa harga GPT Proto saat ini, simpan saldo pengujian awal yang kecil, dan bandingkan biaya balasan yang benar-benar ingin Anda simpan. Jika model yang lebih murah berulang kali memerlukan koreksi atau regenerasi, tarif token saja tidak akan menggambarkan pengalaman Anda. Kami tidak menguji pengurangan biaya berbasis ringkasan di sini; setiap giliran yang dicatat menyertakan riwayat lengkap yang disimpan.
Gunakan Model Kimi Pilihan Anda di SillyTavern atau Janitor AI
GPT Proto memungkinkan Anda membandingkan model yang didukung dengan satu kunci API dan saldo. Hal ini memudahkan Anda untuk mencoba karakter yang sama dengan versi Kimi yang berbeda sebelum berkomitmen pada cerita yang lebih panjang.
Untuk SillyTavern, ikuti panduan integrasi API GPT Proto kami. Gunakan ID model yang sesuai dan mulai percakapan baru untuk setiap perbandingan. Pengujian kami menggunakan backend SillyTavern; kami tidak mereplikasi rangkaian pengujian ini di Janitor AI.
Jika Janitor adalah klien pilihan Anda, gunakan panduan pengaturan API dan pemecahan masalah proxy Janitor AI, lalu verifikasi model pilihan Anda dengan obrolan singkat. Anggap itu sebagai pemeriksaan integrasi terpisah, jangan berasumsi perilaku SillyTavern akan sama persis.
Untuk aplikasi karakter kustom, permintaan kecil ini menggunakan endpoint Chat Completions yang didokumentasikan GPT Proto. Atur GPTPROTO_API_KEY dengan aman di shell Anda terlebih dahulu. Ini adalah contoh koneksi, bukan skrip yang digunakan untuk mengumpulkan hasil waktu respons.
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3.1-pro",
    "messages": [
      {
        "role": "system",
        "content": "Anda berperan sebagai Rowan, seorang tukang reparasi jam yang penuh perhatian. Tulis hanya dialog dan tindakan yang dapat diamati. Jangan memutuskan pikiran, ucapan, atau tindakan pemain. Jaga balasan tetap di bawah 120 kata."
      },
      {
        "role": "user",
        "content": "Wawancaranya berjalan buruk. Bolehkah saya duduk di sini sementara Anda bekerja? Tolong, jangan ada pidato motivasi."
      }
    ],
    "temperature": 1.0,
    "max_tokens": 4096
  }'
Untuk alur kerja halaman model, buka Kimi K3.1 Pro, pilih Coba model ini, dan gunakan Salin Markdown untuk AI untuk memberikan instruksi koneksi kepada asisten pengodean Anda. Jangan sertakan kunci asli di dalam prompt.
Pilihan Kami: Mulai dengan Pro, Lalu Bandingkan Suaranya
Untuk sesi karakter pertama, kami akan memilih Kimi K3.1 Pro. Model ini menangani emosi tertahan dengan baik dan mengikuti target panjang balasan secara lebih konsisten daripada K3 dalam percakapan panjang kami.
Coba Kimi K3 saat gaya dialog cukup penting untuk membandingkan alternatif. Pilih Kimi K2.6 saat waktu tunggu yang lebih singkat dan biaya yang lebih hemat lebih penting daripada kontrol ketat atas setiap detail yang dibuat-buat.
Bawa kartu karakter Anda sendiri. Jalankan adegan yang sulit, koreksi karakter sekali, dan lihat apa yang terjadi beberapa giliran kemudian. Itu akan memberi tahu Anda lebih banyak daripada sekadar salam pembuka yang sempurna.