Ikhtisar Qwen 4 Max: Dari Uji Buta "Qoduck" hingga Pratinjau 14 Hari
Jika Anda menginginkan ikhtisar praktis tentang Qwen 4 Max, mulailah dengan empat hari sebelum namanya diumumkan ke publik. Antara 7 November dan 10 November 2026, sebuah model anonim dengan kode nama Qoduck muncul di dalam Qoder, sebuah IDE pengodean berbasis agen. Pengembang yang menguji Qoduck melihat pola yang tidak biasa: alih-alih mengembalikan cuplikan kode sekali jalan yang cepat dan menunggu umpan balik manusia, model tersebut menghabiskan sepuluh hingga lima belas menit untuk menjalankan pemeriksaan shell, menulis aset SVG kustom dari awal, dan menjalankan pengujian unit terhadap diff-nya sendiri sebelum memberikan jawaban akhir.
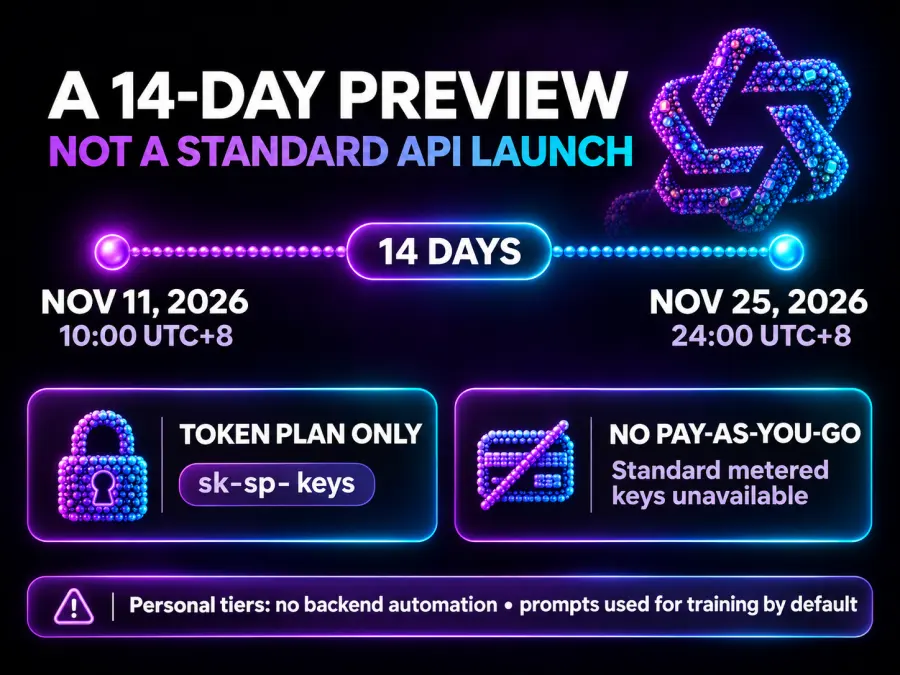
Pada 11 November 2026 pukul 10:00 UTC+8, Alibaba mengonfirmasi bahwa Qoduck adalah model terbaru Qwen, yaitu Qwen 4 Max, dan mengeksposnya di Alibaba Cloud Model Studio di bawah string model qwen4-max-preview (disebut sebagai qwen4.0-max-preview dalam konfigurasi klien tertentu). Alih-alih melakukan peluncuran komersial penuh dengan harga daftar per-token, Alibaba membingkai peluncuran ini—yang sering dijelaskan dalam dokumen pengembang sebagai pengenalan Qwen 4 Max melalui pratinjau Qwen 4 Max selama 14 hari—yang dirancang untuk menguji alur kerja agen di dalam alat pengembang seperti Claude Code, Cursor, Cline, dan Qoder.
| Spesifikasi |
Status Terkonfirmasi (qwen4-max-preview) |
Catatan Sumber / Teknis |
| ID Model Resmi |
qwen4-max-preview |
Dokumen Alibaba Cloud Model Studio / Bailian |
| Jendela Pratinjau |
11 Nov 2026 (10:00) – 25 Nov 2026 (24:00 UTC+8) |
Pratinjau terbatas 14 hari yang ketat |
| Jendela Konteks |
1.000.000 token (input maks: 967.000 token) |
Diverifikasi di seluruh dokumen CN dan Internasional |
| Token Output Maksimum |
Total 393.216 (131.072 output akhir + 262.144 penalaran) |
max_tokens membatasi gabungan pemikiran + output |
| Modalitas Input / Output |
Input: Teks, Gambar, Video · Output: Teks |
Tidak ada input audio asli pada rute pratinjau |
| Kontrol Penalaran |
reasoning_effort: low, medium, xhigh |
Pemikiran AKTIF secara default; default ke xhigh |
| Protokol API yang Didukung |
OpenAI Chat Completions, Responses API, Anthropic Messages |
Memerlukan endpoint Paket Token sk-sp- khusus |
| Ukuran Parameter & Bobot |
Tidak diungkapkan (Pratinjau komersial tertutup) |
Angka 2.4T / 95B yang beredar daring milik Qwen3.8-Max |
| Tabel Tolok Ukur Resmi |
Tidak dipublikasikan saat peluncuran pratinjau |
Skor GameFeel 49.9 yang beredar adalah Qwen-4-Flash-Early |
Memahami penjelasan qwen 4 max sebagai langkah generasional bergantung pada bagaimana model tersebut menghabiskan komputasi pada saat inferensi. Di mana rilis sebelumnya memperlakukan pemanggilan alat sebagai pembantu opsional, peningkatan inti qwen 4 max menyematkan loop verifikasi mandiri ke dalam jejak penalaran default. Saat diminta untuk membangun aplikasi web atau menambal utilitas baris perintah, model ini secara rutin merangkai lusinan pemanggilan alat—memeriksa pohon direktori, menjalankan pytest atau browser headless lokal, menangkap regresi sintaksis atau tata letaknya sendiri, dan menulis ulang baris yang rusak sebelum pengguna melihat outputnya.
Arsitektur, Ukuran Model, dan Realitas Tolok Ukur
Dua informasi keliru saat ini mendominasi hasil pencarian untuk qwen 4 max size dan qwen 4 max benchmark. Mengklarifikasinya adalah cara tercepat untuk memahami apa yang sebenarnya dirilis oleh Alibaba dan apa yang masih belum diungkapkan.
Pertama, Alibaba belum mengungkapkan jumlah parameter total atau aktif untuk alibaba qwen 4 max. Beberapa blog pihak ketiga mencantumkannya sebagai model Mixture-of-Experts (MoE) dengan 2,4 triliun parameter dan 95 miliar parameter aktif per token. Angka-angka tersebut sebenarnya milik model unggulan sebelumnya, Qwen3.8-Max, yang dirilis pada September 2026. Meskipun Qwen 4 Max hampir pasti menggunakan tulang punggung sparse MoE untuk melayani jendela konteks 1 juta token secara ekonomis, angka triliunan parameter apa pun yang Anda baca pada November 2026 adalah informasi yang belum terverifikasi dan terbawa dari generasi 3.8.
Apa yang kita miliki dari sisi arsitektur berasal dari rilis teknis Alibaba pada Agustus 2026 mengenai Qwen3.8-Flash-Next, yang secara eksplisit ditetapkan oleh tim Qwen sebagai wadah uji untuk memvalidasi peningkatan arsitektur inti bagi seri Qwen 4. Laporan pendahulu tersebut mendokumentasikan empat perubahan struktural yang menjelaskan bagaimana qwen4-max-preview menangani beban kerja jutaan token:
Perhatian Hybrid GDN + QSA: Menggabungkan lapisan perhatian linear Gated DeltaNet (GDN) dengan Qwen Sparse Attention (QSA) memangkas latensi prefill waktu-ke-token-pertama (TTFT) pada konteks 1.000.000 token hingga 7,6x dibandingkan dengan perhatian penuh standar.
Koneksi Residual Gated 4-Stream: Memperluas lebar aliran residual dengan gerbang yang dipelajari meningkatkan aliran gradien dan perutean fitur lintas lapisan selama penalaran multi-langkah yang mendalam.
Lapisan Embedding N-gram: Menyuntikkan konteks lokal multi-token secara langsung pada tahap embedding meringankan beban pencocokan pola leksikal dari blok perhatian awal.
Pelatihan Pengoptimal Muon: Beralih ke pengoptimalan pra-pelatihan skala besar menggunakan Muon meningkatkan efisiensi sampel pada korpus kode dan logika formal.
Kedua, jika Anda mencari hasil qwen 4 max benchmark, Anda kemungkinan akan menemukan klaim bahwa Qwen 4 Max mencetak skor 49,9 pada GameFeel Bench v1.4, mengungguli Claude Opus 5.5 yang mencetak 47,2. Saya memeriksa papan peringkat dan log komit yang mendasarinya: skor 49,9 tersebut dicatat oleh checkpoint uji awal yang ringan bernama Qwen-4-Flash-Early (nama kode internal hawk), bukan qwen4-max-preview. Per 13 November 2026, Alibaba belum menerbitkan tabel papan peringkat resmi MMLU-Pro, SWE-bench Verified, atau AIME untuk Qwen 4 Max.
Apa yang dapat Anda verifikasi saat ini adalah mekanisme qwen 4 max context window dan anggaran keluarannya—dan di sinilah pengembang yang bermigrasi menemui kendala. Meskipun jendela konteks menampung 1.000.000 token (dengan batas prompt terdokumentasi sebesar 967.000 token), output maksimum tercantum sebagai 393.216 token di portal internasional dan dirinci di portal domestik sebagai 262.144 token penalaran ditambah 131.072 token jawaban akhir.
Inilah kendalanya: parameter API max_tokens pada qwen4-max-preview mengatur sum dari reasoning_content dan content. Karena model ini secara default menggunakan reasoning_effort: "xhigh" (yang tertinggi dari tiga pengaturan yang tersedia: low, medium, dan xhigh), prompt pengodean yang kompleks dapat dengan mudah menghabiskan 15.000 hingga 40.000 token di dalam blok pemikiran tersembunyi. Jika kode klien Anda saat ini menggunakan max_tokens: 4096 atau 8192, model akan menghabiskan seluruh jatahnya di tengah proses berpikir dan mengembalikan string content yang kosong. Untuk menghindari pemotongan senyap, tingkatkan max_tokens di atas 65.536 atau turunkan secara eksplisit reasoning_effort ke medium untuk tugas-tugas rutin.
Ulasan Praktis Qwen 4 Max: Apa yang Sebenarnya Ditunjukkan oleh Pengujian Komunitas dan Media
Karena Alibaba melewatkan rilis pers tolok ukur tradisional, data ulasan qwen 4 max yang paling andal berasal dari tim teknik yang menghubungkan qwen4-max-preview ke dalam rangkaian agen langsung selama 48 jam pertama pratinjau. Log mereka menunjukkan pola yang jelas: setiap lonjakan kualitas output dibarengi dengan latensi dan biaya token yang nyata.
Pada 11 November, konsultan AI asal Jepang WEEL menerbitkan evaluasi tiga bagian yang menguji model pratinjau tersebut dalam sintesis frontend, penelitian multi-sumber, dan debugging tingkat repositori di dalam Claude Code:
Halaman Landas SVG Kustom 908 Baris (vs Qwen 3.8 Max): Diberikan perintah yang identik untuk membangun halaman landas responsif bagi klinik terapi fisik bertema kehutanan, Qwen3.8-Max selesai dalam waktu sekitar 9,5 menit tetapi menarik foto stok eksternal acak yang merusak kisi atau gagal dimuat. qwen4-max-preview membutuhkan waktu sekitar 17 menit—hampir dua kali lebih lama. Alih-alih menautkan URL eksternal yang rapuh, model ini memanggil Interpreter Kode-nya puluhan kali di latar belakang untuk menggambar ilustrasi SVG kustom secara terprogram mengenai kanopi hutan, arsitektur klinik, dan ikon staf, menghasilkan file HTML 908 baris tanpa aset yang rusak.
Debugging CLI Otonom di Claude Code (36/36 Tes Lulus): WEEL mengarahkan Claude Code (yang didukung oleh qwen4-max-preview melalui endpoint yang kompatibel dengan Anthropic) ke CLI akuntansi rumah tangga Python lokal (kakeibo) dan memintanya untuk menambahkan flag pemfilteran --export-csv dan --month beserta pengujian unit. Proses ini memakan waktu 11 menit 48 detik. Setelah menulis implementasi awal, model menjalankan pytest, menemukan 2 tes yang gagal—termasuk kasus ekstrem di mana string mata uang negatif seperti -100日元 disalahartikan oleh argparse Python sebagai flag baris perintah—dan memperbaiki parser tersebut secara mandiri. Tanpa diminta, model ini juga menambahkan header BOM utf-8-sig agar karakter Jepang tidak berantakan di Microsoft Excel dan melakukan escape pada karakter =, +, -, dan @ di awal untuk memblokir injeksi rumus CSV. Semua 36 tes lulus, hanya menghabiskan 0,4% dari kuota paket Lite bulanan.
Penelitian Kebijakan yang Diverifikasi Sendiri: Ditugaskan untuk menyusun tabel perbandingan subsidi UKM Jepang tahun 2026, model menghabiskan 2 menit menjalankan belasan kueri web di seluruh portal kementerian dan 5 menit lagi menjalankan grep serta skrip validasi Python untuk memverifikasi bahwa tidak ada kolom tabel Markdown yang bergeser sebelum menyajikan hasil 8 menit tersebut.
Dua hari kemudian, pada 13 November, publikasi teknologi Tiongkok Silicon Star (GuiXingRen) menjalankan tantangan teknik visual dan 3D terhadap qwen4-max-preview. Saat diminta untuk membuat animasi SVG klasik "pelikan mengendarai sepeda", model tersebut mengartikulasikan kayuhan pedal dan bayangan pohon paralaks sambil secara otomatis menambahkan penggeser kecepatan 0,5x–1,75x dan pengalih tema siang/senja/malam. Dalam tes Three.js yang lebih sulit—membangun game pesawat kertas 3D yang dapat dimainkan bernama Paper Skies di mana pesawat terbang melalui jendela kamar tidur ke taman—pengulas mencatat bahwa penanganan fisika dan rintangannya setara dengan Claude Fable 5.1 yang berfokus pada kreativitas dari Anthropic, meskipun masih tertinggal dari Claude Fable 5.2 yang lebih baru dalam hal polesan shader. Saat diminta untuk mendesain ulang beranda responsif Silicon Star sendiri, model tersebut meluncurkan browser lokal, mendeteksi bahwa thumbnail artikel eksternal mengembalikan kesalahan hotlink 403, menggantinya dengan placeholder gradien SVG bergaya secara otomatis, dan menyelesaikan putaran kedua revisi tata letak editorial dalam 5 menit.
Umpan balik pengembang di X (sebelumnya Twitter) dan forum pengembang Jepang memberikan nuansa penting pada setiap sorotan fitur qwen 4 max. Pengembang @round_boys mendemonstrasikan model tersebut merender adegan 3D lengkap menggunakan Java dan Three.js dalam sekali jalan, namun mencatat bahwa proses tersebut menghabiskan sekitar 69.000 token. Pengguna awal lainnya yang mengukur throughput mentah melaporkan kecepatan streaming berkisar sekitar 33 token per detik di bawah pengaturan default xhigh, seraya berkomentar bahwa lintasan penggunaan alat pembelajaran penguatan (RL) terkadang terlalu memikirkan pembacaan file sederhana—sebuah pengingat bahwa akhiran -preview itu nyata.
Harga Qwen 4 Max, Aturan Paket Token, dan Hambatan Produksi
Jika Anda mencari harga qwen 4 max dengan harapan menemukan tabel standar "$X per juta token input", Anda tidak akan menemukannya. Alibaba tidak menawarkan penagihan terukur atau bayar-sesuai-pemakaian untuk qwen4-max-preview. Satu-satunya cara untuk mengirim permintaan adalah melalui langganan Alibaba Cloud Model Studio Token Plan yang aktif (sebelumnya disebut Coding Plan), yang menagih dalam bentuk "Kredit" bulanan abstrak, bukan dolar per token.
Di portal internasional QwenCloud, Paket Token dibagi menjadi tingkat personal dan tim:
Paket Lite (3 untuk bulan pertama bagi pengguna baru): Termasuk 20.000 Kredit per bulan, diatur oleh pembatasan ketat (rolling throttle) sebesar 1.200 Kredit per jendela 5 jam dan 9.000 Kredit per minggu.
Paket Pro (15 untuk bulan pertama): Termasuk 100.000 Kredit per bulan, dibatasi hingga 6.000 Kredit per jendela 5 jam dan 45.000 Kredit per minggu. (Di portal domestik Alibaba China, Lite dan Pro terdaftar seharga 39 RMB dan 199 RMB per bulan, dengan promo setengah harga untuk bulan pertama seharga 19,5 RMB dan 99,5 RMB.)
Diskon Pratinjau 14 Hari (11 Nov–25 Nov 2026): Selama jendela pratinjau dua minggu, panggilan siang hari (08:00–22:00 UTC+8) hanya mengonsumsi 20% dari bobot Kredit standar, sementara panggilan malam hari di luar jam sibuk (22:00–08:00 UTC+8) menerima diskon tambahan 80% di atasnya—menurunkan penggunaan Kredit efektif menjadi hanya 4% dari tarif normal.
Bagi pengembang individu yang bereksperimen di IDE pada malam hari dengan harga $3, perhitungan promosi tersebut sulit untuk dikalahkan. Namun, bagi tim teknik yang membangun produk atau menjalankan agen CI/CD otomatis, Paket Token ini menghadirkan tiga hambatan produksi yang nyata:
Larangan Otomatisasi Backend dan Integrasi API: Ketentuan Paket Token Alibaba secara eksplisit membatasi kunci Lite dan Pro personal (sk-sp-) untuk pengodean interaktif yang dipicu oleh manusia di dalam plugin IDE yang didukung. Menggunakan kunci langganan untuk menjalankan skrip backend otomatis, fitur SaaS yang menghadap pelanggan, atau pipeline data batch melanggar ketentuan layanan dan akan memicu penangguhan akun.
Pelatihan Data Wajib pada Tingkat Personal: Berdasarkan aturan Paket Token, langganan Lite dan Pro personal mendaftarkan semua prompt, konteks repositori, dan penyelesaian model ke dalam program peningkatan pelatihan model Alibaba secara default—dan tidak ada tombol untuk menonaktifkannya. Hanya Paket Tim perusahaan ($40 per kursi/bulan) yang memberikan jaminan tanpa retensi data / tanpa pelatihan.
Batas Tarif 5 Jam yang Berjalan dan Penutupan 25 November: Bahkan jika alur kerja Anda sepenuhnya internal, batas 1.200 Kredit per 5 jam tidak dapat menampung lonjakan dari banyak pengembang, dan endpoint qwen4-max-preview dijadwalkan untuk ditutup pada 25 November 2026 pukul 24:00 UTC+8.
Perbandingan Langsung: Qwen 4 Max vs Qwen 3.8 Max, Kimi K3.1 Pro, GLM-5.3, dan Claude Opus 5.5
Karena Anda tidak dapat menghubungkan qwen4-max-preview ke backend produksi saat ini, pertanyaan praktis di balik setiap kueri perbandingan adalah model unggulan pay-as-you-go mana yang mencakup beban kerja agenik dengan konteks 1 juta token yang sama tanpa terkunci pada langganan atau paparan pelatihan data.
| Model |
Penagihan & Ketersediaan |
Jendela Konteks |
Output Maksimum |
Modalitas Input yang Didukung |
Tarif Meteran GPT Proto (Input / Output per 1 Juta) |
Qwen4-Max-Preview (qwen4-max-preview) |
Hanya pratinjau 14 hari (Berakhir 25 Nov); Langganan Paket Token ($6–$30/bln) |
1.000.000 |
393.216 (termasuk 262K CoT) |
Teks, Gambar, Video |
Tidak di-host (Tidak ada API upstream terukur) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
Produksi Pay-As-You-Go |
1.000.000 |
65.536+ |
Teks, Gambar, Video, Audio, Dokumen |
4.20 (30% di bawah harga resmi) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
Produksi Pay-As-You-Go |
1.048.576 (1,05 Juta) |
131.072 |
Teks, Gambar, Dokumen |
10.00 ($0.20 input cache) |
GLM-5.3 (glm-5.3) |
Produksi Pay-As-You-Go |
1.050.000 (1,05 Juta) |
128.000 |
Teks, Gambar, Dokumen |
3.74 (15% di bawah harga resmi) |
Claude Opus 5.5 (claude-opus-5-5) |
Produksi Pay-As-You-Go |
1.000.000 |
128.000 |
Teks, Gambar, Dokumen |
18.00 (10% di bawah harga resmi) |
Qwen 4 Max vs Qwen 3.8 Max
Saat mengevaluasi qwen 4 max vs qwen 3.8 max, pertukarannya adalah waktu verifikasi otonom dibandingkan stabilitas produksi dan dukungan modalitas yang lebih luas. Seperti yang ditunjukkan oleh pengujian halaman landas WEEL 17 menit vs 9,5 menit, Qwen 4 Max bersedia menghabiskan dua kali lipat waktu untuk menjalankan pemeriksaan Python latar belakang dan menyintesis SVG kustom. Namun, qwen4-max-preview menghilangkan penguraian file audio dan dokumen asli pada rute pratinjaunya dan tidak dapat dipanggil berdasarkan per token.
Jika pipeline Anda sudah mengandalkan pemformatan prompt, tokenisasi multibahasa, atau visi multimodal Alibaba, qwen3.8-max-0902 adalah model unggulan siap produksi yang dapat Anda gunakan hari ini. Model ini menawarkan jendela konteks 1.000.000 token yang sama sambil menerima input Teks, Gambar, Video, Audio, dan Dokumen. Di GPT Proto, qwen3.8-max-0902 berjalan dengan harga 4.20 per 1 juta token output—30% di bawah harga resmi Alibaba—dan Anda dapat membandingkannya bersama model open-weight yang lebih kecil di hub model Qwen.
Qwen 4 Max vs Kimi K3.1 Pro
Perbandingan qwen 4 max vs kimi k3.1 pro diuji secara langsung dalam tolok ukur Blender MCP dan WebGL Silicon Star pada 13 November, dan perbedaan antara kedua model tersebut sangat jelas: Qwen 4 Max berpikir seperti insinyur mekanik struktural, sementara Kimi K3.1 Pro berpikir seperti desainer industri.
Dalam prompt Blender ("Dermaga Pemeliharaan Kapal Orbital Jupiter") dan tes gerbang laut dalam WebGL ("Gerbang Sepuluh Ribu Pasang Surut"), qwen4-max-preview membangun rusuk penahan beban internal yang lebih padat, lengan dok yang kompleks, dan penggeser UI tingkat pasang surut yang berfungsi untuk menghitung ulang ketinggian air dan pembacaan tekanan secara dinamis. Namun, pengulas secara konsisten memberikan skor lebih tinggi pada kimi-k3.1-pro untuk komposisi visual, pencahayaan shader air, dan harmoni warna. Jika Anda sedang membangun frontend yang menghadap pengguna, pengalaman web 3D interaktif, atau agen dokumen berkonteks panjang yang membutuhkan jendela konteks 1.048.576 token (1,05 juta) dan output maksimum 131.072 token saat ini, Kimi K3.1 Pro tersedia di GPT Proto dengan harga 10,00 per 1 juta output (dengan input cache turun menjadi $0,20 per 1 juta).
Qwen 4 Max vs GLM-5.3
Pengembang yang mencari qwen 4 max vs glm5.3 biasanya mengejar efisiensi pengkodean dan penggunaan alat bervolume tinggi dengan harga yang agresif. Meskipun promo Lite bulan pertama Qwen 4 Max seharga $3 terlihat murah di atas kertas, batas Kredit bergulir 5 jam dan larangan skrip otomatis membuatnya tidak dapat digunakan untuk armada agen latar belakang.
Z.ai's glm-5.3 memecahkan masalah tersebut pada API terukur. Model ini sedikit mengungguli Qwen 4 Max dalam kapasitas konteks total—menawarkan jendela konteks 1,05 juta yang dipasangkan dengan batas output 128K—dan menerima input Teks, Gambar, dan Dokumen. Dengan harga 3,74 per 1 juta token output di GPT Proto (15% di bawah tarif resmi Z.ai), GLM-5.3 adalah pekerja keras bayar-sesuai-pemakaian yang paling hemat biaya untuk bot peninjau PR otomatis, perutean alat dengan konkurensi tinggi, dan pembuatan kode multi-file.
Qwen 4 Max vs Claude Opus 5.5
Alibaba membangun kompatibilitas API Pesan Anthropic asli ke dalam qwen4-max-preview secara khusus untuk menarik pengembang yang melihat qwen 4 max vs claude opus 5.5 di dalam Claude Code. Seperti yang dibuktikan oleh tes Python CLI WEEL, Qwen 4 Max sudah dapat menjalankan loop perbaikan pytest selama 12 menit dan menangkap bug argparse serta injeksi CSV yang halus.
Di mana claude-opus-5-5 mempertahankan keunggulan yang menentukan adalah efisiensi lintasan, responsivitas streaming, dan keandalan SLA produksi. Penguji komunitas mencatat bahwa penyetelan RL tahap awal Qwen 4 Max dapat menyebabkannya melakukan loop melalui pemeriksaan shell yang berlebihan pada ~33 token/detik di bawah penalaran xhigh. Saat Anda melakukan refaktorisasi repositori produksi yang sangat penting di mana giliran alat yang terbuang atau pelatihan data tingkat pribadi tidak dapat diterima, Claude Opus 5.5 memberikan jendela konteks 1 juta dan output maksimum 128K dengan kepatuhan instruksi yang matang. Melalui GPT Proto, Anda dapat memanggil claude-opus-5-5 dengan harga 18,00 per 1 juta output—10% di bawah harga resmi Anthropic.
Cara Memanggil Alternatif Produksi melalui API Terpadu
Jika Anda ingin menjalankan empat model unggulan produksi di atas tanpa harus mengelola SDK vendor yang terpisah, jendela kredit langganan, atau endpoint regional sk-sp-, GPT Proto mengekspos semuanya di balik satu rute yang kompatibel dengan OpenAI (https://gptproto.com/v1/chat/completions).
Satu detail autentikasi yang perlu diperhatikan sebelum Anda menyalin cuplikan kode: sebagaimana didokumentasikan pada panduan autentikasi dan halaman mulai cepat kami, selalu sertakan kunci Anda di header Authorization dengan awalan Bearer (Authorization: Bearer $GPTPROTO_API_KEY). Di bawah ini adalah contoh berbasis dokumentasi yang menunjukkan cara memanggil qwen3.8-max-0902 dan beralih langsung ke glm-5.3, kimi-k3.1-pro, atau claude-opus-5-5 dengan mengubah satu string saja:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Audit this Python CLI parser for negative-number flag collisions and CSV formula injection risks."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# Tukar ID model secara bebas di seluruh model unggulan dengan konteks 1M:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Audit this Python CLI parser for negative-number flag collisions and CSV formula injection risks.",
        }
    ],
)

print(response.choices[0].message.content)