Nếu bạn đang phân vân giữa GPT 6.1 Terra và Sonnet 5.5 hôm nay, đây là quy tắc quyết định ngắn gọn mà tôi sử dụng trước khi chạy một bài kiểm tra hiệu năng:
Hãy chọn GPT-6.1 Terra nếu quy trình của bạn thực hiện kiểm tra ảnh chụp màn hình khối lượng lớn, tự động hóa biểu mẫu và hóa đơn, gỡ lỗi bố cục giao diện người dùng, hoặc các tác vụ lập trình có giới hạn, nơi mức giá $0.80/$4.00 mỗi token và tốc độ thực thi tác vụ nhanh gấp 3 lần quan trọng hơn độ sâu tái cấu trúc tự động tối đa—và các đầu vào yêu cầu đơn lẻ của bạn ở mức 272K token hoặc thấp hơn.
Hãy tiếp tục sử dụng Claude Sonnet 5.5 nếu tác nhân của bạn thực hiện di chuyển kho lưu trữ đa tệp, gỡ lỗi terminal chuyên sâu nơi một chỉnh sửa bị bỏ lỡ đắt đỏ hơn hóa đơn token, hoặc các lời nhắc một lần từ 300K đến 900K token, nơi phụ phí ngữ cảnh dài của OpenAI xóa bỏ lợi thế về giá đầu vào của Terra.
Bạn có thể kiểm tra tỷ giá danh mục trực tiếp hoặc chạy khối lượng token hàng tháng của riêng bạn thông qua trung tâm so sánh mô hình GPT Proto trước khi cam kết với một trong hai lựa chọn. Mọi thông tin bên dưới là sự so sánh dựa trên tài liệu và điểm chuẩn được xác minh vào ngày 5 tháng 11 năm 2026; các điểm chuẩn do nhà cung cấp báo cáo được dán nhãn riêng biệt với các phép đo độc lập bởi Artificial Analysis và phản hồi sớm từ nhà phát triển.
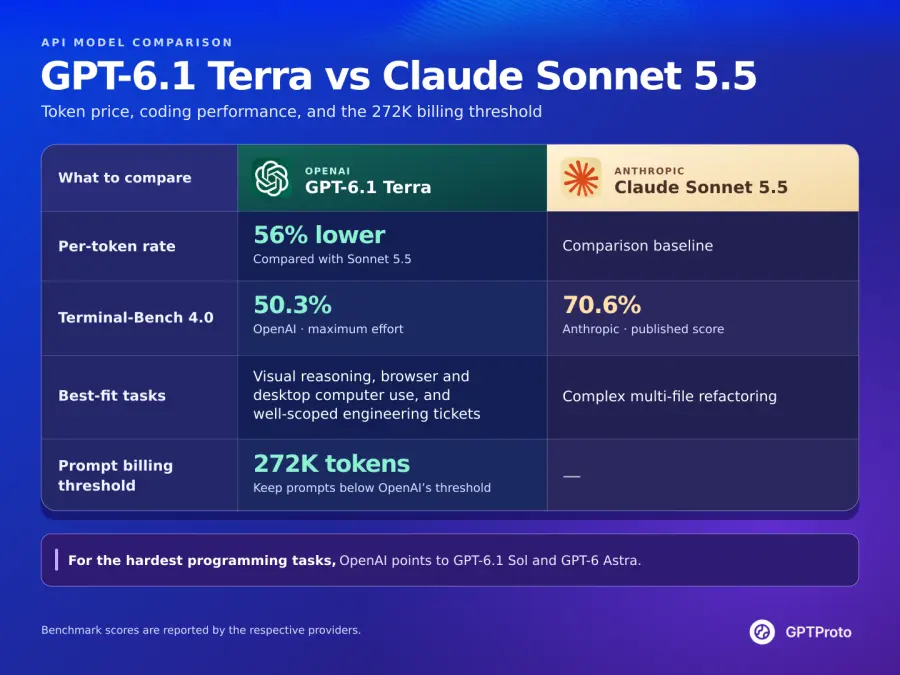
So sánh nhanh GPT-6.1 Terra và Claude Sonnet 5.5
Các nhà phát triển khi tìm kiếm thông tin về ChatGPT 6.1 Terra so với Sonnet 5.5 hoặc Anthropic Claude Sonnet 5.5 so với GPT 6.1 Terra thường gặp phải các bảng thông số mâu thuẫn vì hai nhà cung cấp này cấu trúc các tùy chọn kiểm soát suy luận, điểm cuối công cụ và phụ phí cho ngữ cảnh dài theo những cách khác nhau. Bảng dưới đây đối chiếu cả hai mô hình dựa trên tài liệu chính thức của OpenAI về gpt-6.1-terra, tổng quan về Claude Sonnet 5.5 của Anthropic và bảng giá trực tiếp từ danh mục GPT Proto.
| Thông số kỹ thuật |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| Nhà cung cấp |
OpenAI |
Anthropic |
| Ngày phát hành |
26 tháng 10, 2026 |
28 tháng 9, 2026 |
| Đầu vào / đầu ra tiêu chuẩn chính thức (trên 1 triệu token) |
$1.00 / $5.00 |
$2.00 / $10.00 |
| Đầu vào / đầu ra GPT Proto (trên 1 triệu token) |
$0.80 / $4.00 (−20% so với chính thức) |
$1.80 / $9.00 (−10% so với chính thức) |
| Đọc đầu vào được lưu trong bộ nhớ đệm chính thức (trên 1 triệu token) |
$0.05 (5% của đầu vào cơ sở) |
$0.10 (giảm từ $0.20 vào ngày 7 tháng 10, 2026) |
| Ghi vào bộ nhớ đệm chính thức (trên 1 triệu token) |
$1.25 (TTL 30 phút) / $2.50 (TTL 12 giờ) |
$2.50 (TTL 5 phút) |
| Đọc / ghi bộ nhớ đệm GPT Proto (trên 1 triệu token) |
$0.04 / $1.00 |
$0.09 / $2.25 (xác minh trên trang mô hình trực tiếp) |
| Cửa sổ ngữ cảnh |
1.050.000 token |
1.000.000 token |
| Quy tắc định giá ngữ cảnh dài |
>272K đầu vào tính phí toàn bộ yêu cầu ở mức 2x đầu vào/bộ nhớ đệm và 1.5x đầu ra |
Mức giá cố định trên toàn bộ cửa sổ ngữ cảnh 1 triệu token |
| Số token đầu ra tối đa |
128.000 token |
128.000 token |
| Các phương thức đầu vào / đầu ra |
Văn bản, Hình ảnh, Tài liệu vào → Văn bản ra |
Văn bản, Hình ảnh, Tài liệu vào → Văn bản ra |
| Cột mốc kiến thức |
1 tháng 6, 2026 |
Đầu đến giữa năm 2026 (giữ lại bộ mã hóa Sonnet 5) |
| Kiểm soát suy luận / nỗ lực |
none, low, medium (mặc định), high, xhigh, max |
Tư duy thích ứng được bật theo mặc định; medium, high (mặc định API), max, between_tools |
| Điểm cuối bắt buộc để gọi công cụ |
/v1/responses theo yêu cầu của tài liệu OpenAI |
/v1/messages (gốc) hoặc /v1/chat/completions tương thích với OpenAI |
| Khả dụng trên Client & IDE |
ChatGPT Work & Codex (không phải Chat thông thường), GitHub Copilot, Claude Code (thông qua API) |
Claude.ai, Claude Code, GitHub Copilot, Cursor |
| Chỉ số thông minh AA (v4.3.2) |
41 (medium) / 48 (max) |
56 (max, Dự phòng mặc định) |
| Chi phí tác vụ đánh giá trung bình AA |
$0.10 (`medium`) / $0.40 (max) |
$5.46 (max, Dự phòng mặc định) |
| Terminal-Bench 4.0 (do nhà cung cấp báo cáo) |
50,3% (max nỗ lực) |
70,6% |
Ba hàng trong bảng đó thực hiện hầu hết công việc khi bạn lập ngân sách cho một ứng dụng. Thứ nhất, đối với các yêu cầu tiêu chuẩn dưới 272K token, GPT-6.1 Terra rẻ hơn 56% mỗi token trên GPT Proto cho cả đầu vào và đầu ra, vì vậy các phần hoàn thành dài không làm thay đổi thứ hạng chi phí. Thứ hai, Sonnet 5.5 dẫn trước 20,3 điểm phần trăm trên Terminal-Bench 4.0, điều này tương quan chặt chẽ với cách hai mô hình hoạt động khi chỉnh sửa kho lưu trữ không có hướng dẫn. Thứ ba, không giống như GPT-6.1 Sol, GPT-6.1 Terra khôi phục hỗ trợ cho reasoning.effort: "none", mang lại cho các nhà phát triển OpenAI một con đường nhanh chóng không cần suy luận thực sự một lần nữa.
Phân tích giá cả và chi phí: Mô hình nào đắt đỏ hơn và mô hình nào tiết kiệm chi phí hơn?
Khi các nhà phát triển tìm kiếm "GPT 6.1 Terra so với Sonnet 5.5 mô hình nào đắt hơn" hoặc "mô hình nào tiết kiệm chi phí hơn", họ thường cố gắng đối chiếu hai con số khác nhau: mức phí trên mỗi triệu token trên trang định giá và chi phí thực tế bằng đô la cho một tác vụ đại lý hoàn chỉnh. Hai tỷ lệ đó không giống nhau.
Ở cấp độ mỗi token, Claude Sonnet 5.5 là mô hình có giá cao hơn đáng kể. Mức giá chính thức của Anthropic là 2,00 đô la cho mỗi triệu token đầu vào và 10,00 đô la cho mỗi triệu token đầu ra—gấp đôi mức giá niêm yết 1,00 đô la/5,00 đô la của OpenAI cho Terra. Vì GPT Proto áp dụng mức giảm giá 20% cho GPT-6.1 Terra (0,80 đô la đầu vào / 4,00 đô la đầu ra) và giảm giá 10% cho Claude Sonnet 5.5 (1,80 đô la đầu vào / 9,00 đô la đầu ra), Sonnet 5.5 có chi phí cao gấp 2,25 lần trên mỗi token trên nền tảng. Cả hai nhà cung cấp hiện đều tính phí đọc đầu vào được lưu vào bộ nhớ đệm ở mức 5% so với đầu vào cơ sở (0,05 đô la chính thức cho Terra so với 0,10 đô la chính thức cho Sonnet 5.5 sau khi Anthropic giảm một nửa giá đọc bộ nhớ đệm của Sonnet vào tháng 10 năm 2026), và cả hai đều tính phí 1,25 lần đầu vào cơ sở cho các lần ghi bộ nhớ đệm tiêu chuẩn (1,25 đô la so với 2,50 đô la chính thức). Lưu ý rằng một lời nhắc dài được ghi vào bộ nhớ đệm để sử dụng một lần thực tế sẽ cộng thêm 25% phụ phí cho cả hai mô hình nếu bạn không bao giờ đọc lại tiền tố đó lần thứ hai.
Ở cấp độ mỗi tác vụ, khoảng cách trở nên lớn hơn nhiều. Trong Chỉ số Trí tuệ v4.3.2 của Artificial Analysis (được công bố từ ngày 26–27 tháng 10 năm 2026), cấu hình Claude Sonnet 5.5 (max nỗ lực với Default Fallback) đã được thử nghiệm ghi nhận chi phí trung bình có trọng số là 5,46 đô la cho mỗi tác vụ đánh giá. Trong cùng bộ đánh giá đó, [GPT-6.1 Terra ở mức nỗ lực `max`](https://artificialanalysis.ai/models/gpt-6-1-terra) trung bình là 0,40 đô la cho mỗi tác vụ, và GPT-6.1 Terra ở mức nỗ lực medium trung bình chỉ 0,10 đô la cho mỗi tác vụ. Đó là sự khác biệt gấp 13,6 lần ở mức nỗ lực max và khác biệt gấp 54,6 lần khi so sánh cài đặt cao nhất của Sonnet với cài đặt medium mặc định của Terra.
Tại sao sự khác biệt gấp 2 lần trên mỗi token lại biến thành khoảng cách hóa đơn từ 13 đến 54 lần? Các mô hình suy luận tính phí các token tư duy như các token đầu ra. Khi Sonnet 5.5 chạy ở mức nỗ lực cao hoặc tối đa trên một điểm chuẩn mở, nó tạo ra các chuỗi suy luận dài với giá 10,00 đô la cho mỗi triệu token (9,00 đô la trên GPT Proto). Thông báo của Terra cũng lưu ý rằng ở mức nỗ lực tối đa trong bài kiểm tra Agents' Last Exam, Terra đã sử dụng ít hơn một phần ba số lượng token so với Claude Opus 5.5. Quan trọng hơn nữa là phát hiện về đường biên Pareto của Artificial Analysis: đối với GPT-6.1 Terra, các cài đặt nỗ lực low và medium là tối ưu Pareto về trí tuệ so với chi phí. Việc tăng Terra lên mức max đẩy điểm số của nó từ 41 lên 48, ngang bằng với GPT-6.1 Sol ở mức nỗ lực medium—ngoại trừ Sol medium có chi phí 0,21 đô la cho mỗi tác vụ trong khi Terra `max` có chi phí 0,40 đô la. Tóm lại, nếu bạn muốn thiết lập tiết kiệm chi phí nhất trên Terra, hãy giữ nó ở mức low hoặc medium; nếu một tác vụ đủ khó để yêu cầu nỗ lực max, bạn nên thử nghiệm Sol hoặc Sonnet 5.5.
Tính toán chi phí thực tế: Hai kịch bản sản xuất thực tế
Để thấy được nơi mà mức giá token rẻ hơn thực sự mang lại hiệu quả—và nơi nó phản tác dụng—hãy cùng thực hiện phép tính chính xác theo bảng giá trực tiếp của GPT Proto ($0.80/$4.00 cho Terra; $1.80/$9.00 cho Sonnet 5.5), giả định các yêu cầu không được lưu bộ nhớ đệm dưới 272K token.
Kịch bản A là một vòng lặp tác vụ QA hình ảnh và trích xuất biểu mẫu gồm 20 bước. Mỗi bước gửi một ảnh chụp màn hình và đoạn mã DOM với tổng cộng 15.000 token đầu vào và tạo ra 1.500 token đầu ra (bao gồm cả medium token suy luận). Qua 20 bước, một quy trình làm việc tiêu tốn 300.000 token đầu vào (0.3M) và 30.000 token đầu ra (0.03M):
GPT-6.1 Terra trên GPT Proto: (0.3 * $0.80) + (0.03 * $4.00) = $0.24 + $0.12 = $0.36 mỗi quy trình.
Claude Sonnet 5.5 trên GPT Proto: (0.3 * $1.80) + (0.03 * $9.00) = $0.54 + $0.27 = $0.81 mỗi quy trình.
Với 10.000 quy trình mỗi tháng, Terra tốn $3.600 so với $8.100 của Sonnet—tiết kiệm được $4.500 mỗi tháng. Ngay cả khi Terra thất bại trong việc xác thực ở 20% số lần chạy và phải thực hiện lại 2.000 quy trình đó từ đầu (thêm $720), tổng hóa đơn của bạn là $4.320, vẫn tiết kiệm được $3.780 mỗi tháng so với việc chạy Sonnet mà không cần thực hiện lại.
Kịch bản B là việc tái cấu trúc backend đa tệp trong một pull request đang hoạt động. Giả sử mỗi lần thử đọc 80.000 token đầu vào và xuất ra 10.000 token đầu ra. Một lần chạy sạch trên Sonnet 5.5 tốn (0.08 * $1.80) + (0.01 * $9.00) = $0.234. Một lần chạy trên Terra tốn (0.08 * $0.80) + (0.01 * $4.00) = $0.104. Bạn tiết kiệm được 13 xu cho mỗi lệnh gọi API. Vấn đề là nếu Terra bỏ lỡ một sự phụ thuộc kiểu dữ liệu giữa các module—điều này phù hợp với khoảng cách 50.3% so với 70.6% trên Terminal-Bench—và buộc phải thực hiện lại ba lần cộng với 12 phút thời gian của kỹ sư cấp cao với mức lương $90/giờ ($18.00 chi phí nhân công), thì khoản tiết kiệm 13 xu đó vừa khiến nhóm của bạn mất $18.18. Tóm lại trong một câu: Terra thắng áp đảo ở các vòng lặp có thể lặp lại và máy móc có thể xác minh, trong khi Sonnet 5.5 xứng đáng với mức giá cao hơn bất cứ khi nào một chỉnh sửa thất bại làm lãng phí thời gian đánh giá của con người.
Ngữ cảnh cửa sổ (1.05M so với 1M): Tại sao vượt ngưỡng 272K lại làm thay đổi chi phí
Trên lý thuyết, sự so sánh giữa GPT 6.1 Terra và Sonnet 5.5 về ngữ cảnh cửa sổ trông như một cuộc đua ngang tài ngang sức với lợi thế nhỏ nghiêng về OpenAI: Terra chấp nhận 1.050.000 token đầu vào và xuất ra tối đa 128.000 token, trong khi Claude Sonnet 5.5 chấp nhận 1.000.000 token đầu vào và xuất ra tối đa 128.000 token. Hầu hết các bảng so sánh đều dừng lại ở đó.
Tuy nhiên, nếu bạn đọc tài liệu về mô hình gpt-6.1-terra của OpenAI, sẽ có một ngưỡng tính phí tại 272.000 token đầu vào làm thay đổi hoàn toàn kinh tế học về ngữ cảnh dài. Bất cứ khi nào một prompt vượt quá 272K token đầu vào trên GPT-6.1 Terra, OpenAI sẽ tính phí toàn bộ yêu cầu—không chỉ các token vượt trên 272K—với mức giá gấp 2 lần cho đầu vào và bộ nhớ đệm (cache), cùng mức giá gấp 1,5 lần cho đầu ra.
Đây là những gì xảy ra với biểu giá chính thức trên mỗi triệu token ngay khi prompt của bạn vượt từ 272.000 token lên 272.001 token:
| Khoảng ngữ cảnh |
GPT-6.1 Terra (Giá chính thức) |
Claude Sonnet 5.5 (Giá chính thức) |
Mối quan hệ giá đầu vào |
| Prompt tiêu chuẩn (≤272K token đầu vào) |
$1.00 đầu vào / $5.00 đầu ra / $0.05 đọc cache |
$2.00 đầu vào / $10.00 đầu ra / $0.10 đọc cache |
Terra rẻ hơn 50% cho cả đầu vào và đầu ra |
| Prompt ngữ cảnh dài (>272K đến 1M+ token đầu vào) |
$2.00 đầu vào / $7.50 đầu ra / $0.10 đọc cache |
$2.00 đầu vào / $10.00 đầu ra / $0.10 đọc cache |
Giá đầu vào và đọc cache là như nhau ($2.00 / $0.10) |
Không giống như mô hình Haiku 5.5 nhỏ hơn của Anthropic (áp dụng phụ phí 5x trên 100K token), Claude Sonnet 5.5 duy trì mức giá cố định trên toàn bộ cửa sổ ngữ cảnh 1.000.000 token của nó.
Hãy thử tính toán trên một lần kiểm tra kho lưu trữ 400.000 token tạo ra 10.000 token đầu ra theo giá niêm yết chính thức:
Khi prompt của bạn vượt quá 272K token, mức giảm giá đầu vào 50% của Terra biến mất hoàn toàn, để lại mức chênh lệch tổng cộng là $0.025 cho một lệnh gọi 400K token. Lời khuyên của tôi rất đơn giản: đừng bao giờ gửi các prompt nguyên khối >272K token cho GPT-6.1 Terra với kỳ vọng về kinh tế học giá rẻ một nửa. Hãy chia nhỏ/truy xuất ngữ cảnh của bạn xuống dưới 272K token để Terra duy trì trong khung giá $1.00 ($0.80 GPT Proto), hoặc chuyển các tệp kho lưu trữ từ 300K–900K trực tiếp sang Claude Sonnet 5.5, nơi bạn trả cùng mức giá đầu vào chính thức và có được khả năng hiểu mã nguồn dài hạn mạnh mẽ hơn. (Trước khi chạy các prompt >272K trong môi trường sản xuất thông qua GPT Proto, hãy xác nhận với bộ phận hỗ trợ nền tảng về cách điều chỉnh bậc 272K ở thượng nguồn được phản ánh trên số dư tài khoản của bạn.)
Điểm chuẩn và Phản hồi từ Cộng đồng: Lập trình, Frontend và Tác vụ Đại lý
Điểm tổng hợp tiêu đề thường che giấu nơi mà mỗi mô hình thực sự thành công. Trên Chỉ số Trí tuệ Phân tích Nhân tạo v4.3.2, Claude Sonnet 5.5 (tối đa, Mặc định) đạt 56 điểm, GPT-6.1 Sol (tối đa) đạt 52 điểm, và GPT-6.1 Terra đạt 48 điểm ở nỗ lực tối đa và 41 điểm ở nỗ lực trung bình. (Trên ảnh chụp nhanh chỉ số ngày 3 tháng 11 năm 2026 hiển thị trên thẻ so sánh của GPT Proto, Sonnet 5.5 ghi nhận 54,2 và Terra tối đa ghi nhận 51—một khoảng cách hẹp hơn là 3,2 điểm vẫn nghiêng về phía Sonnet.) Để đưa ra quyết định định tuyến thực tế cho mã nguồn, giao diện người dùng frontend hoặc các vòng lặp đại lý, chúng ta phải phân tích các tổng hợp đó theo loại tác vụ và so sánh chúng với những gì các nhà phát triển đang báo cáo trong thực tế.
1. Lập trình Backend và Terminal (GPT 6.1 Terra so với Sonnet 5.5 trong lập trình)
Đối với kỹ thuật phần mềm thuần túy từ dòng lệnh, Anthropic vẫn nắm giữ lợi thế rõ ràng. Trên Terminal-Bench 4.0, Anthropic báo cáo 70,6% cho Claude Sonnet 5.5 (tăng từ 10,3% trên Sonnet 5), trong khi OpenAI báo cáo 50,3% cho GPT-6.1 Terra ở mức nỗ lực tối đa (tăng từ 21,5% trên GPT-5.6 Terra). Trong Coding Agent Index v2.0 mới được phát hành của Artificial Analysis, Terra đạt 48 điểm—cao hơn 17 điểm so với GPT-6 Luna hạng nhẹ (31), nhưng thấp hơn 6 điểm so với GPT-6.1 Sol (54). Artificial Analysis cũng lưu ý rằng đối với các tác nhân lập trình (coding agents) cụ thể, các thiết lập nỗ lực thấp và cực cao của Terra nằm trên ngưỡng hiệu quả chi phí, trong khi các thiết lập nỗ lực khác vẫn còn tụt hậu.
Các thử nghiệm thực tế ban đầu chỉ ra ranh giới chính xác giữa hai mô hình:
Nhật ký thay đổi ngày 26 tháng 10 năm 2026 của GitHub Copilot báo cáo rằng trong các thử nghiệm nội bộ ban đầu, GPT-6.1 Terra đã giải quyết được nhiều tác vụ terminal và lập trình C# hơn đáng kể so với GPT-5.6 Terra, đồng thời đưa ra một quan sát hành vi quan trọng: "Nó hoạt động theo các bước tập trung, hợp nhất trên các tác vụ có phạm vi rõ ràng." GitHub không công bố tỷ lệ vượt qua thô trong ghi chú đó, vì vậy hãy coi đó là một phát hiện định tính của nền tảng thay vì một điểm chuẩn có kiểm soát.
Về phía Claude, một thử nghiệm đối đầu sớm của nhà phát triển trên r/ClaudeAI (chạy mười tác vụ lập trình cá nhân ba lần cho mỗi cấu hình ở mức nỗ lực cao trong Claude Code và pi-agent) cho thấy Sonnet 5.5 hoàn thành các triển khai một cách nhất quán trong ít lượt hội thoại hơn và ít token đầu ra hơn so với phiên bản tiền nhiệm, phần lớn là do Sonnet 5.5 xử lý các lệnh gọi công cụ song song mạnh mẽ hơn. Tương tự, trên đánh giá CursorBench 4.0 bên ngoài của Cursor, Sonnet 5.5 ở mức nỗ lực cao đạt 47,8% với chi phí 1,67 đô la cho mỗi tác vụ.
Điểm mấu chốt cho các nhà phát triển backend: nếu ticket có phạm vi rõ ràng—viết một phương thức dịch vụ C#, thêm unit test hoặc sửa một tập lệnh CLI riêng biệt—Terra ở mức nỗ lực thấp hoặc trung bình sẽ hoàn thành nhanh chóng với mức giá token chưa bằng một nửa. Nếu ticket yêu cầu theo dõi trạng thái qua mười tệp nơi một vòng lặp thử lại bổ sung làm hỏng quy trình làm việc, thì năng lực terminal 70,6% của Sonnet 5.5 xứng đáng với mức giá cao hơn. Khi liên quan đến tính toán khoa học, OpenAI cũng báo cáo rằng trên Terminal-Bench-Science 0.1 (chẳng hạn như viết mã để theo dõi sự phân chia tế bào trong video tua nhanh thời gian), Terra ở mức nỗ lực tối đa thực sự vượt qua GPT-6.1 Sol và chỉ kém Claude Opus 5.5 năm điểm với chi phí ước tính chưa bằng một phần năm.
2. GPT-6.1 Terra so với Sonnet 5.5 trong lập trình Frontend
Việc tìm kiếm GPT 6.1 Terra so với Sonnet 5.5 trong lập trình Frontend xứng đáng có một câu trả lời riêng vì kỹ thuật frontend thực chất là hai công việc khác nhau được kết hợp lại: công việc bố cục hình ảnh/DOM và logic trạng thái/kiến trúc.
Khi OpenAI giới thiệu điểm số 50,3% của GPT-6.1 Terra trên Terminal-Bench 4.0, ví dụ lập trình cụ thể duy nhất mà họ nhấn mạnh trong thông báo là một lỗi frontend: "sửa lỗi một trang web bị xê dịch bố cục khi tải" (Cumulative Layout Shift - CLS). Đồng thời, OpenAI báo cáo rằng trên MMMU-Pro—một bộ tiêu chuẩn đánh giá khả năng suy luận hình ảnh qua sơ đồ, ảnh chụp màn hình và các bố cục dày đặc—GPT-6.1 Terra vượt trội hơn GPT-5.6 Terra ở mọi cấp độ nỗ lực và gần như ngang bằng với các mô hình tiên phong là GPT-6 Astra và GPT-6.1 Sol với mức giá chỉ bằng một phần nhỏ. Trong chủ đề ngày ra mắt trên diễn đàn Cộng đồng Nhà phát triển OpenAI, một trong những phản hồi đầu tiên của nhà phát triển đã tóm tắt Terra là "rất đáng đồng tiền bát gạo, đặc biệt là về khả năng hiểu hình ảnh. Khả năng lập trình cũng khá tốt."
Sự phân chia đó mang lại cho các nhóm frontend một sự phân công lao động rõ ràng:
Sử dụng GPT-6.1 Terra cho công việc frontend về hình ảnh và lớp giao diện người dùng (UI): chuyển đổi ảnh chụp màn hình Figma hoặc wireframe thành mã đánh dấu Tailwind/HTML ban đầu, so sánh ảnh chụp màn hình Playwright đã kết xuất với các thông số thiết kế để phát hiện các nút DOM chồng chéo hoặc lỗi hồi quy điểm ngắt di động, và chẩn đoán các lỗi xê dịch bố cục CSS. Vì Terra xử lý hình ảnh nguyên bản, chạy nhanh hơn gấp 3 lần so với GPT-6.1 Sol và Astra trên các tiêu chuẩn đánh giá hành động hình ảnh, và có giá $0.80/$4.00 trên GPT Proto, quy trình CI của bạn hoàn toàn có thể thực hiện kiểm tra hồi quy hình ảnh trên mỗi commit.
Sử dụng Claude Sonnet 5.5 cho kiến trúc frontend nặng về logic: tái cấu trúc các cây trạng thái server-action phức tạp trong React/Next.js, giải quyết các ràng buộc generic phức tạp của TypeScript, hoặc di chuyển kho lưu trữ Redux cũ mà không làm hỏng quá trình hydration. Khi không có ảnh chụp màn hình để kiểm tra và độ khó nằm hoàn toàn ở tính nhất quán của trạng thái trên nhiều tệp, Sonnet 5.5 vẫn là lựa chọn an toàn hơn.
3. Tác vụ đại lý (Agentic Work), Sử dụng máy tính và Tính xác thực (cho tác vụ đại lý)
Nếu định nghĩa của bạn về GPT 6.1 Terra so với Sonnet 5.5 cho tác vụ đại lý tập trung vào tự động hóa giao diện người dùng (GUI), phân tích tài liệu và sử dụng máy tính trong văn phòng, thì GPT-6.1 Terra có thể coi là bản phát hành mang lại giá trị mạnh mẽ nhất của OpenAI trong năm 2026.
Trong các đánh giá do nhà cung cấp OpenAI báo cáo trên Agents' Last Exam v1 (bài kiểm tra các quy trình làm việc chuyên nghiệp gồm nhiều bước như chuyển đổi bản vẽ kiến trúc thành mô hình 3D hoặc ghi lại mã thời gian từng cảnh trong một bộ phim hoạt hình), GPT-6.1 Terra ở mức nỗ lực trung bình đạt điểm cao hơn 15 điểm phần trăm so với GPT-5.6 Terra với chi phí chỉ bằng khoảng một phần ba, ngang bằng với phiên bản hàng đầu GPT-6 Astra ở mức giá token bằng một phần mười. Ở mức nỗ lực tối đa, OpenAI báo cáo rằng Terra tiết kiệm token hơn gấp 3 lần so với Claude Opus 5.5 và có giá mỗi token bằng 1/4, mang lại chi phí mỗi tác vụ thấp hơn khoảng 9 lần trong khi hoàn thành quy trình làm việc nhanh hơn gấp 3 lần so với cả GPT-6 Astra và GPT-6.1 Sol.
Trên OSWorld 2.1 (điều khiển ứng dụng máy tính để bàn), OpenAI báo cáo rằng Terra ở mức nỗ lực trung bình đã vượt qua điểm số tốt nhất của GPT-5.6 Terra với chi phí mỗi tác vụ chỉ bằng một phần nhỏ. Để giữ sự cân bằng, điểm số OSWorld 2.1 (ngoại tuyến) do Anthropic công bố cho Claude Sonnet 5.5 là 83,9% (được tiết lộ trong bảng điểm chuẩn Haiku 5.5 tháng 10 năm 2026 của Anthropic). Cả hai mô hình đều là những công cụ sử dụng máy tính hàng đầu; sự khác biệt nằm ở chỗ các đại lý quét màn hình gửi ảnh chụp màn hình mới sau mỗi lần nhấp chuột, điều này làm tiêu tốn token đầu vào rất nhanh và khiến mức giá đầu vào $0.80/M GPT Proto của Terra dễ duy trì hơn nhiều ở quy mô lớn.
Điều quan trọng không kém đối với các đại lý tự hành là biết khi nào mô hình không biết điều gì đó. Trong bài kiểm tra độc lập AA-Omniscience của Artificial Analysis, tỷ lệ ảo tưởng của GPT-6.1 Terra (tần suất mô hình đoán khi thiếu kiến thức) đã giảm 50 điểm phần trăm—từ 88% trên GPT-5.6 Terra xuống còn 38%—trong khi đồng thời tăng 2 điểm về độ chính xác tổng thể. Phép đo độc lập đó củng cố đánh giá tính xác thực nội bộ của OpenAI (được trình bày chi tiết hơn trong Thẻ hệ thống GPT-6.1 Terra), nơi tỷ lệ lỗi thực tế ở mức nỗ lực thấp trên các câu lệnh khó đã giảm từ 53,6% xuống 16,7% (và xuống 4,3% ở mức nỗ lực tối đa). Tỷ lệ ảo tưởng thấp hơn đồng nghĩa với việc ít xảy ra các lệnh gọi công cụ bị lỗi hơn ở các bước sau.
Trải nghiệm nhà phát triển và các cạm bẫy API (GPT 6.1 Terra so với Sonnet 5.5 cho nhà phát triển)
Việc chuyển đổi giữa gpt-6.1-terra và claude-sonnet-5-5 trong môi trường production hiếm khi chỉ là thay thế một chuỗi ký tự đơn giản. Nếu bạn đang đánh giá tính công thái học của GPT 6.1 Terra so với Sonnet 5.5 cho nhà phát triển, thì bốn ràng buộc ở cấp độ API sẽ quyết định công việc tích hợp của bạn.
Thứ nhất, GPT-6.1 Terra hỗ trợ reasoning.effort: "none", trong khi GPT-6.1 Sol thì không. Khi OpenAI ra mắt GPT-6.1 Sol vào ngày 29 tháng 9 năm 2026, họ đã loại bỏ các cấp độ suy luận none và minimal, buộc mọi yêu cầu phải ở mức low trở lên, đồng thời làm hỏng các tham số temperature và top_p trên diện rộng. Theo hướng dẫn di chuyển và nhắc lệnh gpt-6.1-terra chính thức của OpenAI gpt-6.1-terra, Terra hỗ trợ đầy đủ các cấp độ: none, low, medium (mặc định), high, xhigh, và max. Nếu bạn đặt reasoning_effort: "none", Terra sẽ chạy mà không tạo ra các token suy luận ẩn và cho phép sử dụng các tham số lấy mẫu tiêu chuẩn. Tuy nhiên, ngay khi bạn sử dụng low, medium, high, xhigh, hoặc max, bạn phải loại bỏ temperature, top_p, top_logprobs, và logprobs khỏi payload yêu cầu của mình, nếu không API sẽ từ chối cuộc gọi với lỗi HTTP 400.
Thứ hai, OpenAI yêu cầu sử dụng Responses API (/v1/responses) để gọi công cụ trên GPT-6.1 Terra. Mặc dù các lời nhắc văn bản và hình ảnh thông thường hoạt động trên /v1/chat/completions, tài liệu về mô hình của OpenAI nêu rõ rằng việc gọi công cụ yêu cầu /v1/responses. Khi đã sử dụng Responses API, Terra hỗ trợ tất cả chín công cụ tích hợp sẵn của OpenAI—Tìm kiếm web, Tìm kiếm tệp, Tạo hình ảnh, Trình thông dịch mã, Shell được lưu trữ, apply_patch, Kỹ năng, Sử dụng máy tính, MCP và Tìm kiếm công cụ—cộng với async: true trên các công cụ hàm tùy chỉnh để mô hình có thể tiếp tục suy luận trong khi một công cụ nền chậm đang thực thi. Hơn nữa, Terra hỗ trợ gửi mục nhập configuration_update giữa cuộc trò chuyện để tăng hoặc giảm reasoning.effort trong một lượt khó mà không cần viết lại tiền tố nhắc lệnh hoặc làm mất hiệu lực bộ nhớ đệm nhắc lệnh 30 phút của bạn (prompt_cache_options.ttl: "30m").
Thứ ba, Claude Sonnet 5.5 có các bẫy lỗi 400 nghiêm ngặt của riêng nó. Theo hướng dẫn di chuyển Sonnet 5.5 của Anthropic, Sonnet 5.5 sử dụng tư duy thích ứng theo mặc định (mặc định là nỗ lực high trên API và medium trong Claude Code, như đã lưu ý trong tài liệu cấu hình Claude Code của Anthropic). Nếu tích hợp Claude cũ của bạn gửi thinking: {"type": "disabled"}, bạn phải cập nhật nó thành between_tools cho cài đặt tư duy thấp nhất. Quan trọng hơn, Sonnet 5.5 từ chối các lựa chọn công cụ bắt buộc (tool_choice: {"type": "any"} hoặc một công cụ được đặt tên bắt buộc) với lỗi 400 khi tư duy thích ứng đang hoạt động; bạn phải sử dụng auto và hướng dẫn lựa chọn công cụ trong lời nhắc. Bạn cũng cần phân tích cú pháp các khối nội dung phản hồi theo type thay vì giả định content[0] là văn bản, vì khối đầu tiên thường là một khối thinking.
Thứ tư, tích hợp IDE và CLI đã được thiết lập sẵn cho cả hai. Lưu ý rằng trong các gói đăng ký người dùng cá nhân, ghi chú phát hành của OpenAI xác nhận rằng GPT-6.1 Terra đã được triển khai cho ChatGPT Work và Codex (dành cho các gói Plus, Pro, Business, Enterprise và Edu), chứ không phải giao diện ChatGPT Chat tiêu chuẩn, và nó không hỗ trợ lưu trú suy luận tại UAE (mặc dù chế độ Fast hỗ trợ lưu trú dữ liệu tại EU). Đối với các nhà phát triển làm việc trong terminal cục bộ, cả hai mô hình đều có thể được kết nối với Claude Code và OpenAI Codex thông qua GPT Proto. Trên trang mô hình GPT-6.1 Terra, nhấp vào Thử mô hình này sẽ mở ra bảng Bắt đầu nhanh, nơi bạn có thể chọn Claude Code hoặc ChatGPT (Codex) trong mục Để AI hoàn tất tích hợp, hoặc nhấp vào Sao chép Markdown cho AI để để trợ lý lập trình của bạn tự động thiết lập các biến môi trường.
Xây dựng ứng dụng: Cách định tuyến cả hai mô hình với một khóa API duy nhất
Khi các nhóm hỏi về GPT 6.1 Terra so với Sonnet 5.5 để xây dựng ứng dụng, kiến trúc tốt nhất hầu như không bao giờ là chọn một mô hình cho 100% lưu lượng truy cập. Vì cả hai mô hình đều nằm dưới một số dư trả trước duy nhất trên GPT Proto, bạn có thể định tuyến theo từng bước thay vì theo nhà cung cấp: gửi các tác vụ kiểm tra hình ảnh tần suất cao, phân loại ảnh chụp màn hình và sửa lỗi giao diện người dùng (UI) có giới hạn tới gpt-6.1-terra với giá $0.80/$4.00, và chuyển các tác vụ tổng hợp mã nguồn đa tệp tới claude-sonnet-5-5 với giá $1.80/$9.00.
1. Kiểm tra cURL lần đầu (Chat Completions tương thích với OpenAI)
Cả hai mô hình đều có thể được gọi để phân tích văn bản và hình ảnh thông qua điểm cuối /v1/chat/completions thống nhất, tương thích với OpenAI của GPT Proto bằng cách sử dụng mã thông báo Bearer tiêu chuẩn. Việc chuyển đổi giữa chúng chỉ yêu cầu thay đổi chuỗi "model":
# Lệnh gọi 1: GPT-6.1 Terra ($0.80 đầu vào / $4.00 đầu ra trên mỗi 1 triệu token trên GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "Kiểm tra quy tắc CSS này và giải thích trong hai câu tại sao nó gây ra sự thay đổi bố cục trên thiết bị di động: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# Lệnh gọi 2: Claude Sonnet 5.5 ($1.80 đầu vào / $9.00 đầu ra trên mỗi 1 triệu token trên GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Viết một trình trợ giúp TypeScript để xác thực chữ ký webhook bằng Web Crypto API với phép so sánh thời gian không đổi."
      }
    ]
  }'
2. Ví dụ về trình định tuyến bước Python cho Frontend & Đường ống ứng dụng
Dưới đây là một mẫu Python thực tế sử dụng SDK openai tiêu chuẩn trỏ đến https://gptproto.com/v1. Trong quy trình làm việc này, Bước 1 sử dụng gpt-6.1-terra để phân loại báo cáo lỗi giao diện người dùng (nơi khối lượng token lớn và việc chẩn đoán hình ảnh/DOM có chi phí thấp), và Bước 2 định tuyến động bản vá mã thực tế tới gpt-6.1-terra (để sửa lỗi CSS cho một thành phần đơn lẻ) hoặc claude-sonnet-5-5 (khi quá trình phân loại phát hiện thay đổi trạng thái giữa các tệp hoặc khi lời nhắc tiến gần đến giới hạn 272K):
import os
import json
from openai import OpenAI

# Một khóa API và số dư dùng chung cho cả mô hình OpenAI và Anthropic
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # Bước 1: Luôn thực hiện phân loại trực quan/DOM trên GPT-6.1 Terra ($0.80 / $4.00 mỗi 1M token)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "Bạn là một tác nhân phân loại QA frontend. Hãy kiểm tra ảnh chụp màn hình và DOM. "
                    "Trả về JSON với các khóa: 'root_cause', 'scope' ('isolated_css' hoặc 'multi_file_state'), "
                    "và 'target_files' (mảng các chuỗi)."
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"Ảnh chụp nhanh DOM: {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # Bước 2: Định tuyến theo phạm vi tác vụ VÀ giới hạn thanh toán ngữ cảnh dài 272K
    # Nếu bản sửa lỗi liên quan đến trạng thái đa tệp HOẶC vượt quá 272K token đầu vào, hãy chuyển lên Sonnet 5.5
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"Chẩn đoán phân loại: {json.dumps(triage_data)} | "
                    f"Tạo bản vá tối thiểu, sẵn sàng cho sản xuất cho DOM/thành phần: {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"Đã định tuyến bản vá tới: {result['routed_to']}")
    print(result["patch"])
Lưu ý trước khi triển khai (yêu cầu kiểm thử khói): Xác minh các chuỗi mô hình chính xác (gpt-6.1-terra và claude-sonnet-5-5) so với các bảng Sử dụng API trực tiếp trên các trang mô hình GPT Proto của họ trước khi triển khai các vòng lặp tính phí. Nếu tác nhân của bạn dựa vào các công cụ API Phản hồi gốc của OpenAI (apply_patch, shell được lưu trữ, hoặc các lệnh gọi hàm async: true) hoặc các tham số tư duy thích ứng /v1/messages gốc của Anthropic (output_config.effort), hãy chạy kiểm thử khói nhanh đối với các điểm cuối gốc tương ứng của GPT Proto (/v1/responses và /v1/messages) để xác nhận việc chuyển tham số trên tuyến đường của bạn.
Phán quyết: Bạn nên sử dụng mô hình nào?
Nếu bạn muốn có một bảng duy nhất để dán vào tài liệu đánh giá kiến trúc, hãy khớp khối lượng công việc chính của bạn với chế độ lỗi và giới hạn thanh toán mà bạn quan tâm nhất:
| Khối lượng công việc / Kịch bản |
Mô hình đề xuất |
Cài đặt đề xuất |
Tại sao nó chiến thắng |
| QA ảnh chụp màn hình khối lượng lớn, đọc hóa đơn/biểu mẫu & sử dụng máy tính qua trình duyệt |
GPT-6.1 Terra |
low hoặc medium effort |
Tốc độ token GPT Proto thấp hơn 56% ($0.80/$4.00), hoàn thành tác vụ nhanh hơn >3 lần so với Sol/Astra, và khả năng thị giác đạt chuẩn MMMU-Pro tương đương Astra. |
| Gỡ lỗi UI frontend (dịch chuyển bố cục CLS, Figma-to-CSS, hồi quy hình ảnh) |
GPT-6.1 Terra |
medium effort |
Được xây dựng để kiểm tra hình ảnh + DOM; được đo điểm chuẩn rõ ràng trên các bản sửa lỗi dịch chuyển bố cục trang web. |
Phân loại, định tuyến hoặc trích xuất JSON có độ trễ thấp nơi cần temperature |
GPT-6.1 Terra |
reasoning.effort: "none" |
Khôi phục tầng none không suy luận mà GPT-6.1 Sol đã loại bỏ, giúp giữ độ trễ và số lượng token đầu ra ở mức tối thiểu. |
| Tái cấu trúc backend đa tệp & thay đổi trạng thái TypeScript/React phức tạp |
Claude Sonnet 5.5 |
medium hoặc high effort |
70.6% so với 50.3% trên Terminal-Bench 4.0; gộp các lệnh gọi công cụ trong ít lượt hơn, tiết kiệm thời gian đánh giá đắt đỏ của nhà phát triển. |
| Phân tích kho lưu trữ ngữ cảnh dài trong một yêu cầu duy nhất (300K đến 900K token đầu vào) |
Claude Sonnet 5.5 |
medium hoặc high effort |
Terra kích hoạt phụ phí 2x đầu vào / 1.5x đầu ra trên 272K token (nhảy lên mức $2.00 đầu vào chính thức), xóa bỏ lợi thế về giá của nó. |
Lập trình terminal chuyên sâu chuẩn OpenAI khi Terra max không đáp ứng được |
GPT-6.1 Sol |
medium effort |
Đạt 54 điểm so với 48 điểm của Terra trên AA Coding Agent Index v2.0, và Sol medium ($0.21/tác vụ) thực tế rẻ hơn trên mỗi tác vụ so với Terra `max` ($0.40/tác vụ). |
Để tóm tắt phán quyết mà không cần dè dặt: hãy bắt đầu mọi bước lặp lại về hình ảnh, sử dụng máy tính và lập trình có giới hạn trên GPT-6.1 Terra ở mức low hoặc medium effort để tận dụng mức giá $0.80/$4.00, và giữ Claude Sonnet 5.5 cho các bước lập trình đa tệp và các prompt >272K-token nơi độ chính xác ở lần thử đầu tiên cao hơn và mức giá ngữ cảnh 1M cố định của nó mang lại hiệu quả kinh tế. Để nhập tỷ lệ đầu vào và đầu ra hàng tháng của riêng bạn, hãy mở công cụ tính toán so sánh GPT Proto và kiểm tra cả hai mô hình song song trên một bảng cân đối.