So sánh nhanh Kimi K3.1 Pro và Opus 5.5
| Mục |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Giá chính thức đầu vào / đầu ra trên mỗi 1 triệu token |
$2 / $10 |
$4 / $20 |
| Giá GPT Proto đầu vào / đầu ra trên mỗi 1 triệu token |
$2 / $10 |
$3.60 / $18 |
| Cửa sổ ngữ cảnh |
Khoảng 1 triệu token |
1 triệu token |
| Đầu vào / đầu ra mô hình |
Văn bản và hình ảnh / văn bản |
Văn bản và hình ảnh / văn bản |
| Mức độ suy luận mặc định của API gốc |
Tối đa |
Trung bình |
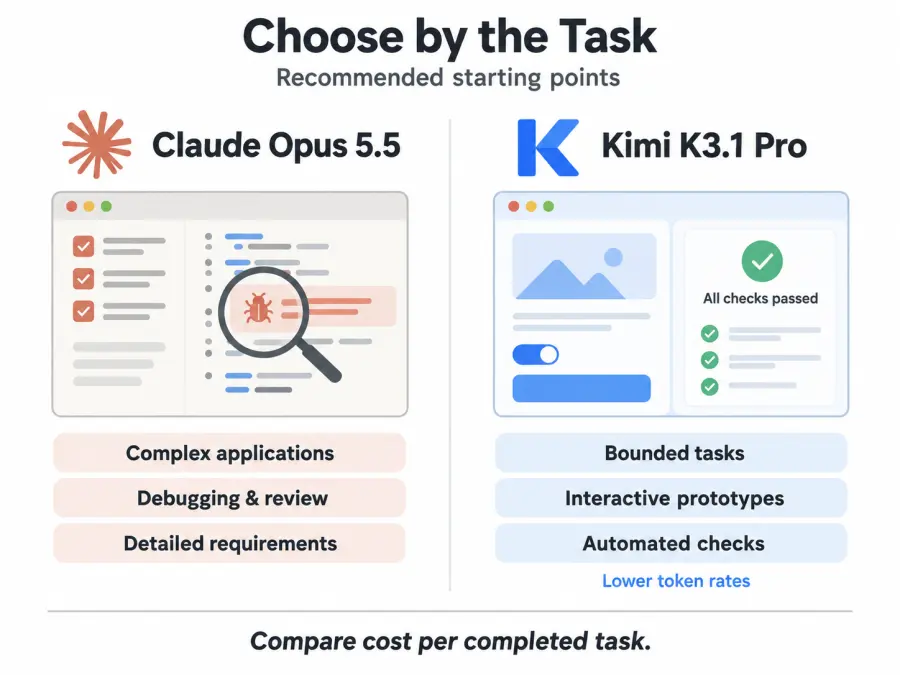
| Lần thử nghiệm đầu tiên tôi đề xuất |
Các tác vụ giới hạn với các bước kiểm tra rõ ràng |
Phát triển phức tạp và đánh giá cuối cùng |
Giá được kiểm tra vào ngày 29 tháng 10 năm 2026. Thông số kỹ thuật chính thức đến từ tài liệu API Kimi và tài liệu mô hình Claude. Giá của GPT Proto được liệt kê trên trang API Kimi K3.1 Pro và trang API Claude Opus 5.5. Các hoạt động bộ nhớ đệm và các khoản phí áp dụng khác cần được tính toán riêng.
Để so sánh danh mục nhanh, hãy sử dụng trang so sánh Kimi K3.1 Pro và Claude Opus 5.5. Để biết thông tin cơ bản về bản phát hành Kimi này, hãy xem những thay đổi trong Kimi K3.1 Pro.
Các điểm chuẩn cho chúng ta biết gì về lập trình và những gì chúng bỏ qua
Bản so sánh ra mắt được công bố của Moonshot báo cáo 65,7% cho Kimi K3.1 Pro và 66,4% cho Opus 5.5 trên Terminal-Bench 4.0. Đây là những số liệu do nhà cung cấp công bố, đang chờ xác minh độc lập về sự so sánh cụ thể đó. Chúng ủng hộ việc coi trọng Kimi cho các công việc dựa trên terminal; chúng không thiết lập hiệu suất ngang bằng trong việc phát triển ứng dụng.
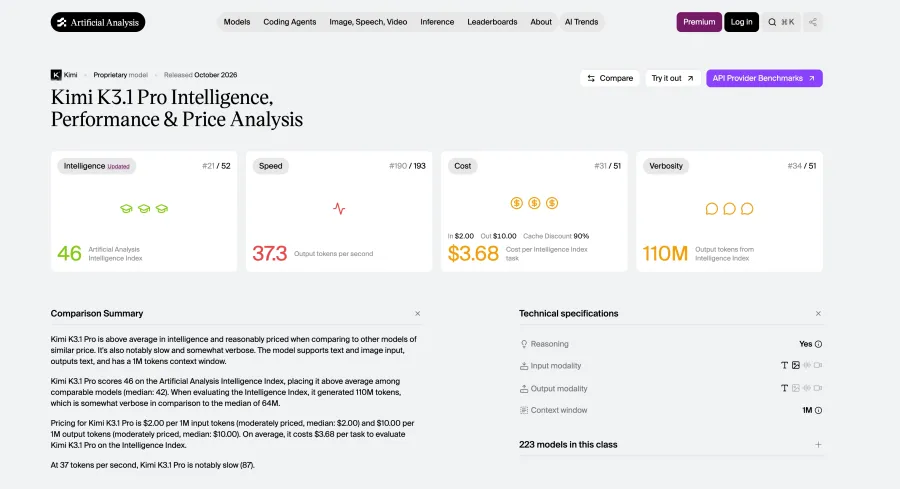
Bức tranh độc lập rộng lớn hơn thì khác. Vào ngày 29 tháng 10, các trang mô hình của Artificial Analysis Intelligence Index v5.0 cho thấy Kimi ở mức 46 và Opus ở mức 58, với cái sau được gắn nhãn Max với Default Fallback. Các điểm chỉ số đó không phải là tỷ lệ phần trăm hay tỷ lệ thành công trong lập trình. Hãy giữ phiên bản chỉ số và cấu hình đi kèm với sự so sánh.
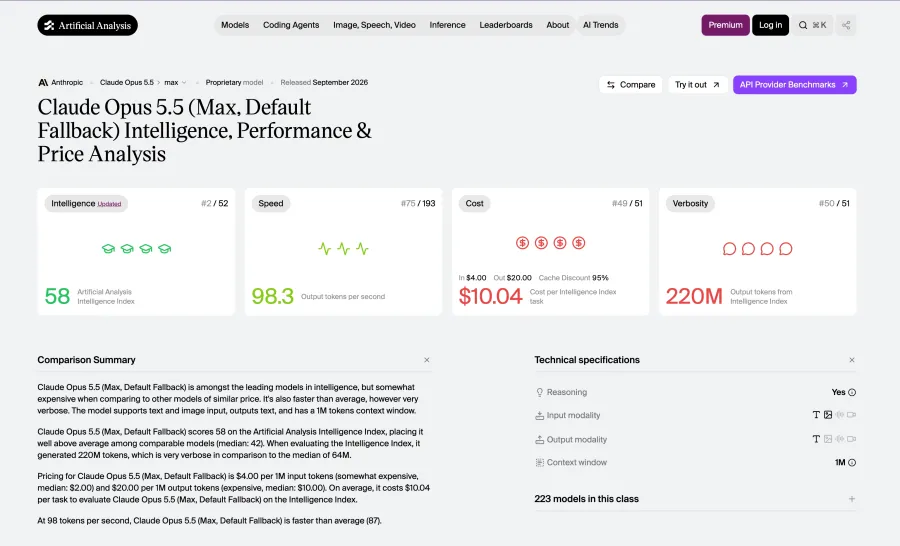
Tôi sẽ coi Opus là tiêu chuẩn chất lượng ban đầu cho các công việc đòi hỏi khắt khe, sau đó kiểm tra xem Kimi có đáp ứng các tiêu chí chấp nhận tương tự với chi phí thấp hơn hay không. Một điểm chuẩn terminal không thể cho bạn biết liệu biểu mẫu đặt chỗ có giữ nguyên trạng thái hay bảng điều khiển có còn dễ đọc trên thiết bị di động hay không. Các bài kiểm tra ứng dụng của bạn phải trả lời điều đó.
Lập trình Frontend: Từ ảnh chụp màn hình đến giao diện hoàn chỉnh
Đối với tác vụ chuyển đổi từ ảnh chụp màn hình sang giao diện, hãy tách biệt phần hiển thị và phần hành vi. Một bố cục chuẩn xác vẫn cần điều hướng hoạt động tốt, các trạng thái biểu mẫu, khả năng truy cập bằng bàn phím và phiên bản di động có thể sử dụng được. Sau đó, hãy yêu cầu thay đổi. Việc thêm bộ lọc mà không làm hỏng bố cục hiện có là một bài kiểm tra khác biệt so với việc tạo ra một trang mới hoàn toàn.
Có một ví dụ hữu ích cho nhà phát triển ở đây. Trong bài so sánh được đăng tải của Melvynx, anh ấy ưu tiên cách xử lý hình ảnh của Opus cho một công cụ kiểm tra múi giờ. Đó là đánh giá về mặt thẩm mỹ cho một bản dựng cụ thể, thay vì là tỷ lệ thành công đo lường được trong lập trình frontend.
Đối với một trang web tiếp thị hoặc bảng điều khiển dành cho khách hàng, lựa chọn đầu tiên của tôi sẽ là Opus khi thiết kế cần sự khác biệt và tinh chỉnh nhiều lần. Kimi là một ứng viên hợp lý cho giao diện nội bộ với hệ thống thiết kế rõ ràng, đặc biệt là khi bạn có thể kiểm tra kết quả trước khi phát hành. Sự đánh đổi nằm ở thời gian dành cho việc sửa chữa những gì mà yêu cầu ban đầu còn bỏ ngỏ.
Hãy xem xét giao diện đặt chỗ như một bản tóm tắt đánh giá. Cung cấp cho cả hai mô hình cùng một hình ảnh tham chiếu, thư viện thành phần hiện có và các yêu cầu về chọn ngày, các khung giờ không khả dụng, xác thực và xác nhận. Yêu cầu mỗi mô hình kết nối giao diện với cùng một API giả lập. Sau đó, hãy tạo ra một yêu cầu thất bại và kiểm tra xem người dùng có thể khôi phục mà không làm mất dữ liệu biểu mẫu hay không.
Bước cuối cùng đó biến đây thành một bài so sánh ứng dụng. Nó cho thấy liệu một trang web bắt mắt có xử lý được hành động tiếp theo của khách hàng hay không.
Ứng dụng tương tác và 3D: Chất lượng hình ảnh, Logic và Hiệu suất thời gian thực
Trường hợp của Kimi trở nên thú vị hơn đối với các tác phẩm hình ảnh tương tác. Ví dụ về đèn lava của Melvynx bao gồm các điều khiển về ánh sáng và màu sắc. Anh ấy đánh giá cao kết quả nỗ lực hơn của Opus, trong khi vẫn thấy các hiệu ứng vật liệu và thủy tinh của Kimi rất thuyết phục. Chi phí vận hành được báo cáo là 2,30 đô la cho Kimi High và 4,16 đô la cho Max, so với 4,35 đô la cho Opus Medium và 6,39 đô la cho Extra High.
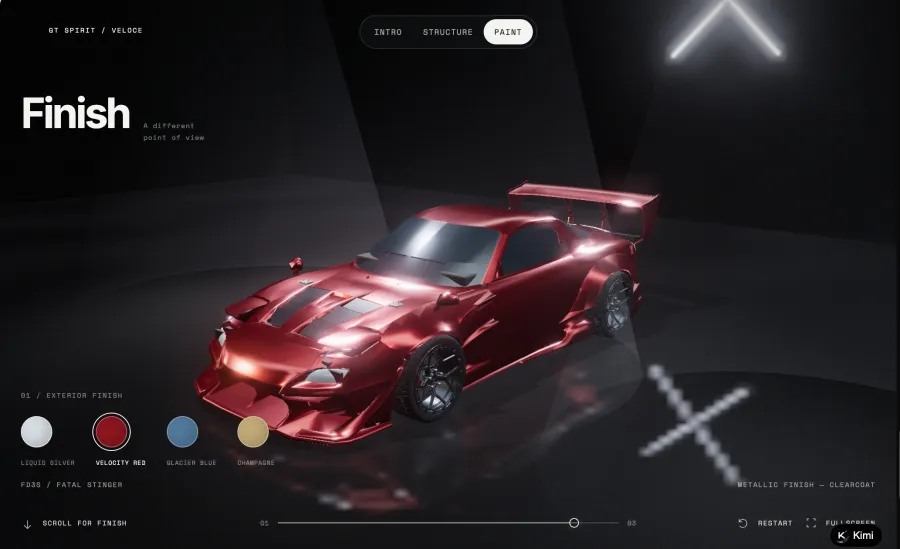
Cùng bài đánh giá đó mô tả một mô phỏng va chạm hoạt động tốt hơn ở Kimi High so với Max. Tác giả có tiết lộ về liên kết tiếp thị (affiliate link) của Kimi và một không gian làm việc chung, không tách biệt. Những ví dụ này là những quan sát hữu ích, với những giới hạn đi kèm.
Theo tôi, Kimi đáng để thử nghiệm cho các bộ cấu hình sản phẩm, bản demo giáo dục và nguyên mẫu hình ảnh. Việc tự động chọn cài đặt nỗ lực cao hơn sẽ bỏ lỡ một trong những bài học thực tế từ các ví dụ đó. Hãy bắt đầu với một yêu cầu rõ ràng và kiểm tra thành phẩm.
Đối với bộ cấu hình nội thất, hãy xác định những gì cần thay đổi khi ai đó chọn vật liệu, chuyển đổi góc nhìn camera hoặc đặt lại thiết kế. Kiểm tra xem giá hiển thị có khớp với lựa chọn hay không. Tải lại trang. Thử các điều khiển trên điện thoại. Một chiếc ghế hấp dẫn về mặt hình ảnh chỉ là một phần của sản phẩm bàn giao.
Độ chính xác kỹ thuật cần có các bài kiểm tra riêng. Kết quả BenchCAD của Moonshot báo cáo 92,7% cho Kimi và 96,2% cho Opus khi sử dụng các công cụ, dựa trên thước đo tái tạo hình học. Kết quả do nhà cung cấp công bố đó giải quyết một câu hỏi khác với việc liệu một cảnh quay có trông hấp dẫn hay không. Một hình ảnh động thuyết phục vẫn cần xác thực riêng trước khi bạn sử dụng nó để dạy vật lý hoặc mô tả một quy trình kỹ thuật.
Đối với một nguyên mẫu, tôi sẽ dùng thử Kimi trước. Đối với một ứng dụng đòi hỏi độ chính xác cao, tôi sẽ bắt đầu với Opus và yêu cầu các kiểm tra chuyên biệt theo lĩnh vực bất kể mô hình nào tạo ra mã đó.
Phát triển tác nhân (Agentic): Liệu mô hình có thể hoàn thành một tác vụ gồm nhiều bước?
Một tác nhân hoạt động trong kho lưu trữ phải hiểu được hành vi hiện tại, chọn các tệp cần thay đổi, chạy công cụ, diễn giải các lỗi và quyết định khi nào cần dừng lại. Các sai sót có thể tích tụ giữa những bước đó.
Cả hai nhà cung cấp đều công bố các ví dụ về công việc mở rộng. Moonshot mô tả Kimi chẩn đoán và sửa lỗi một trình mô phỏng trước khi đào tạo lại bộ điều khiển đi bộ. Báo cáo ra mắt Opus 5.5 của Anthropic mô tả các cải tiến trên một ứng dụng web, bao gồm một tác vụ thời gian tải được hoàn thành thành công trong 39 trên 40 lần thử. Đây là các ví dụ riêng biệt từ nhà cung cấp, thay vì là một bài kiểm tra đối đầu trực tiếp được chia sẻ.
Đối với một ứng dụng lập hóa đơn hiện có, một phép so sánh hữu ích sẽ là việc thêm tính năng nhập CSV. Yêu cầu ánh xạ trường, xử lý hàng không hợp lệ, phát hiện trùng lặp, bản xem trước và các bài kiểm tra bao quát hành vi hiện tại. Hãy để mỗi mô hình làm việc từ cùng một bản chụp kho lưu trữ và kiểm tra cả hai bản vá. Một bản tóm tắt nói rằng “tất cả các bài kiểm tra đều vượt qua” cần có nhật ký kiểm tra đi kèm.
Đối với loại thay đổi trên nhiều tệp đó, Opus sẽ là điểm khởi đầu mặc định của tôi. Kimi dễ đánh giá hơn ở một phần giới hạn của công việc, chẳng hạn như triển khai xác thực dựa trên một lược đồ đã thỏa thuận. Hãy mở rộng phạm vi của nó sau khi các bài kiểm tra xác nhận rằng nó có thể xử lý ứng dụng xung quanh.
Cấu hình cũng rất quan trọng. Hướng dẫn sử dụng công cụ của Kimi yêu cầu giữ lại toàn bộ tin nhắn của trợ lý qua các lượt. Tài liệu Opus của Claude mô tả tư duy và hành vi công cụ dành riêng cho mô hình. Hãy xác minh các chi tiết đó trên lộ trình bạn đã chọn; việc khớp với định dạng yêu cầu cơ bản không thiết lập hành vi tác nhân giống hệt nhau.
Giá cả và Chi phí: Một kết quả được chấp nhận thực sự tốn bao nhiêu?
Kimi K3.1 Pro có mức giá đầu vào và đầu ra tiêu chuẩn thấp hơn. Câu hỏi khó hơn là tác vụ của bạn cần bao nhiêu lệnh gọi, thử lại và chu kỳ đánh giá.
Dưới đây là ví dụ lập kế hoạch sử dụng các mức giá niêm yết của GPT Proto. Giả sử mỗi lần thử sử dụng 1 triệu token đầu vào không lưu vào bộ nhớ đệm và 200.000 token đầu ra được tính phí. Đây là các khối lượng giả định, không phải kết quả ứng dụng thực tế.
| Kịch bản lập kế hoạch |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Một lần thử với khối lượng đã nêu |
$4.00 |
$7.20 |
| Hai lần thử, mỗi lần với cùng khối lượng |
$8.00 |
$14.40 |
Theo những giả định đó, một kết quả Kimi cần hai lần thử sẽ tốn nhiều token hơn một kết quả Opus được chấp nhận sau một lần thử. Các lần thử lại thực tế hiếm khi lặp lại chính xác cùng một khối lượng token, vì vậy hãy sử dụng hồ sơ sử dụng của bạn để tính toán thực tế.
Bộ nhớ đệm (Caching) làm thay đổi phép so sánh một lần nữa. Cả hai nhà cung cấp đều liệt kê các lần đọc bộ nhớ đệm chính thức ở mức $0.20 cho mỗi 1 triệu token trong tài liệu Kimi và Claude của họ. Một phiên tác nhân dài với nhiều lượt truy cập bộ nhớ đệm sẽ có tỷ lệ chi phí khác với một yêu cầu mới. Hãy kiểm tra cả phí ghi bộ nhớ đệm, mức sử dụng đầu ra và mức giá thực tế của nhà cung cấp của bạn.
Đối với một nhóm, tôi sẽ theo dõi chi phí cho mỗi tác vụ được chấp nhận cùng với thời gian trôi qua và số phút của người đánh giá. Một bản nháp rẻ hơn có thể mang lại giá trị tốt khi việc kiểm tra nó diễn ra nhanh chóng. Nó trở nên kém hấp dẫn hơn khi một nhà phát triển phải tái cấu trúc những gì tác nhân đã thay đổi trước khi tin tưởng nó.
Cách so sánh cả hai mô hình trên ứng dụng của bạn thông qua GPT Proto
Hãy sử dụng một thay đổi nhỏ trên ứng dụng với kết quả có thể quan sát được. Một biểu mẫu đặt chỗ, trình nhập CSV hoặc trình cấu hình sản phẩm sẽ cung cấp cho bạn bằng chứng hữu ích hơn là một yêu cầu chung chung như “xây dựng một thứ gì đó ấn tượng”.
Mở trang mô hình Kimi và trang mô hình Opus. Sử dụng tính năng Thử mô hình này (Try this model) và Bắt đầu nhanh (Quick Start) để lấy hướng dẫn tích hợp, sau đó sao chép các hướng dẫn Markdown vào trợ lý lập trình của bạn. Hãy giữ khóa API của bạn trong biến môi trường cục bộ hoặc cấu hình phía máy chủ.
Trước khi đánh giá chất lượng phát triển, hãy kiểm tra xem cả hai đường dẫn mô hình đều phản hồi. Ví dụ kết nối này tuân theo định dạng Chat Completions được công bố trên các trang mô hình. Thiết lập GPTPROTO_API_KEY cục bộ trước khi chạy; các yêu cầu này sẽ tiêu tốn token trả phí.
for model in kimi-k3.1-pro claude-opus-5-5; do
  curl --fail-with-body --silent --show-error --max-time 180 \
    https://gptproto.com/v1/chat/completions \
    -H "Authorization: Bearer $GPTPROTO_API_KEY" \
    -H "Content-Type: application/json" \
    --data "{
      \"model\": \"$model\",
      \"messages\": [{\"role\": \"user\",
        \"content\": \"Return only: API connection OK\"}]
    }"
done
Thao tác này kiểm tra khả năng kết nối, không phải chất lượng lập trình. Các API gốc có các cài đặt suy luận mặc định khác nhau; hãy cấu hình và ghi lại các cài đặt nỗ lực được hỗ trợ trước khi so sánh ứng dụng. Một phản hồi API cũng cần một tác nhân hoặc ứng dụng bao quanh nó để chỉnh sửa tệp, thực thi công cụ và kiểm tra trình duyệt.
Đối với thử nghiệm phát triển, hãy bắt đầu mỗi mô hình từ một bản sao sạch của cùng một dự án. Cung cấp cùng một tác vụ, quyền, phần phụ thuộc và các bài kiểm tra chấp nhận. Ghi lại đường dẫn mô hình, nỗ lực, mức sử dụng được tính phí, thời gian hoàn thành và các thay đổi thủ công cần thiết. Hãy lặp lại tác vụ trước khi biến một thay đổi nhỏ thành mặc định trong môi trường sản xuất của bạn.
Nếu điểm cuối trả về lỗi xác thực, hãy kiểm tra khóa và tiêu đề ủy quyền. Nếu một tham số tùy chọn bị từ chối, hãy so sánh nó với hướng dẫn trên trang mô hình hiện tại. Xác minh phản hồi thành công có chứa đầu ra mô hình dự kiến trước khi mở rộng công việc.
Bạn nên chọn mô hình nào?
| Khối lượng công việc của bạn |
Lựa chọn khởi đầu của tôi |
Điều kiện để duy trì lựa chọn |
| Frontend hướng tới khách hàng với các bản sửa đổi thiết kế lặp đi lặp lại |
Opus 5.5 |
Kết quả đầu ra được chấp nhận tốt hơn xứng đáng với chi phí bỏ ra |
| Nguyên mẫu tương tác hoặc thử nghiệm trực quan |
Kimi K3.1 Pro |
Các điều khiển hoạt động tốt và artifact dễ dàng kiểm tra |
| Các thay đổi phức tạp trong một ứng dụng hiện có |
Opus 5.5 |
Các bài kiểm tra kho lưu trữ và hỗ trợ đánh giá củng cố cho lựa chọn này |
| Triển khai lặp lại dựa trên một đặc tả cố định |
Kimi K3.1 Pro |
Các kiểm tra tự động giúp giữ chi phí sửa lỗi ở mức thấp |
| Mã hoặc mô phỏng đòi hỏi độ chính xác cao |
Opus là lựa chọn cơ sở ban đầu |
Cần có xác thực bên ngoài cho cả hai mô hình |
Tôi sẽ chọn Opus 5.5 làm mặc định ban đầu cho một nhóm giao phó khối lượng công việc ứng dụng đáng kể cho một tác nhân AI. Bằng chứng đánh giá rộng rãi hơn ủng hộ việc bắt đầu từ đó, trong khi kho lưu trữ thực tế sẽ quyết định xem mức phí cao cấp có xứng đáng hay không.
Kimi K3.1 Pro là một ứng cử viên thiết thực để giảm chi phí cho các công việc đã được xác định rõ ràng. Hãy bắt đầu với các tác vụ mà bạn có thể kiểm tra hoặc thử nghiệm, đo lường các kết quả được chấp nhận và giao cho nó nhiều trách nhiệm hơn khi bằng chứng cải thiện. Đó là lý do thuyết phục hơn để chuyển đổi so với việc chỉ dựa vào kết quả gần như ngang bằng trên một tiêu chuẩn đánh giá.
Hãy thử một tác vụ nhỏ với trang Kimi K3.1 Pro API và Claude Opus 5.5 API, sử dụng các hướng dẫn tích hợp và so sánh kết quả mà ứng dụng của bạn có thể chấp nhận.